
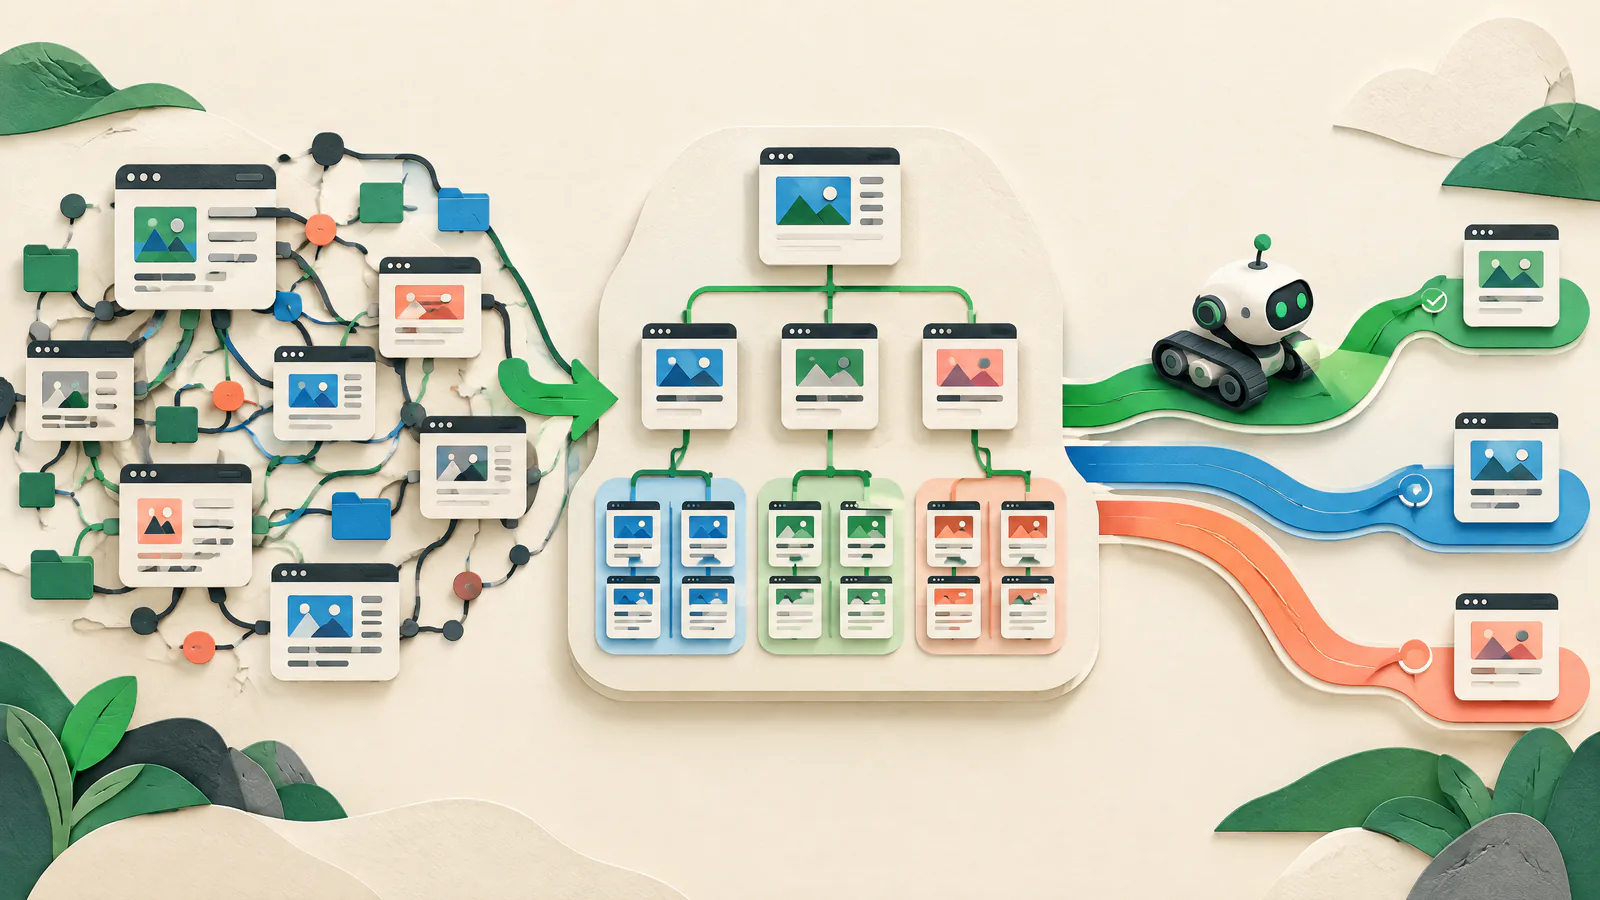
Define la elegibilidad antes de generar el XML
Un sitemap XML es una lista legible por máquinas de URLs y metadatos opcionales. Empieza con una regla de elegibilidad, no con una exportación del rastreador: incluye una página solo cuando esté pensada para búsqueda, sea recuperable públicamente y sea la versión preferida de su contenido. Mantén fuera las URLs facetadas de catálogos, resultados de búsqueda internos, variantes de campaña, destinos de inicio de sesión y vistas previas, salvo que sean destinos de búsqueda públicos deliberados.
Páginas públicas y útiles destinadas a aparecer en búsqueda con una URL preferida.
Redirecciones, errores, duplicados, páginas noindex y rutas privadas.
La ayuda al descubrimiento no garantiza rastreo ni indexación.
Incluye la URL canónica, no todas las vías para alcanzarla
Una URL canónica es la versión que quieres que los motores traten como representativa entre versiones similares. La inclusión en el sitemap es una señal débil de canonicalización, así que debe reforzar, no contradecir, redirecciones, etiquetas rel=canonical autodeclaradas y enlaces internos. Selecciona un formato HTTPS estable y emite exactamente esa versión.
Revisa http y https, www y sin-www, reglas de barra final, mayúsculas, páginas de impresión, filtros y parámetros de seguimiento. Si una URL hace una redirección, lista solo su destino canónico final. Da a cada página localizada e independiente su propia URL canónica; no uses el sitemap para colapsar contenidos localizados distintos.
Escribe el esquema y el host completos, no una ruta relativa. Google rastrea las URLs tal como aparecen listadas.
Sitemap, etiqueta canónica, enlaces internos y política de redirección deben nombrar la misma página.
Bloquear un duplicado no establece una versión preferida.
Mantén el XML pequeño, válido y veraz
Usa la estructura del Sitemap Protocol: XML en UTF-8 con un urlset, el espacio de nombres del sitemap y un loc para cada URL. Escapa caracteres sensibles de XML en los valores de URL. La automatización debe serializar URLs en lugar de concatenar XML a mano.
Cada sitemap puede contener como máximo 50.000 URLs y no ser mayor de 50 MB sin comprimir. Esos son límites, no objetivos. Divide antes si productos, artículos, locales o tipos de contenido crean un límite operativo útil.
Usa lastmod solo para la fecha de cambio significativa real de la página. Google lo utiliza cuando es consistente y verificablemente preciso; una actualización del año de copyright no califica. Nunca marques cada URL con la hora de generación. Google ignora changefreq y priority, así que omítelos.
loc es obligatorio; lastmod es opcional y debe describir la página, no la generación.
Gzip puede reducir el tamaño en transferencia, pero el archivo descomprimido debe permanecer por debajo de 50 MB.
Comprueba la well-formedness del XML, la accesibilidad y el comportamiento de las páginas listadas.
Usa índices para escalar sin perder propiedad
Un índice de sitemap lista archivos de sitemap. Úsalo cuando el sitio supere el límite de un solo archivo o necesite inventarios separados. Agrupa por propiedad editorial, producto o centro de ayuda. Tiene los mismos límites de 50.000 ítems y 50 MB sin comprimir.
Mantén los archivos hijos en el sitio previsto en URLs estables. El protocolo generalmente liga las URLs elegibles al host y la ubicación del sitemap; los arreglos cross-site requieren propiedad verificada.
Divide en torno a un propósito comprobable: tipo de contenido, escaparate, conjunto de idiomas o límite de despliegue. Registra el generador, el propietario y la población esperada.
Envía el índice completo en lugar de cada hijo manualmente.
El lastmod del índice describe el archivo sitemap, no sus páginas.
Publica, envía e interpreta los resultados correctamente
Aloja el sitemap en una dirección HTTPS pública y estable, preferiblemente cerca de la raíz. Añade una directiva Sitemap absoluta a robots.txt. Envía el sitemap o índice a Google Search Console y Bing Webmaster Tools para obtener detalles de procesamiento.
En Search Console, Success significa que el sitemap fue recuperado y leído sin errores. Has errors significa que se leyó con errores; Couldn’t fetch significa que no estuvo disponible. Corrige entrega, autenticación, DNS, robots, redirecciones o XML y reenvía.
Trata los recuentos de páginas descubiertas como entrada diagnóstica, no como una puntuación. Una página descubierta no está garantizada para ser rastreada o indexada. Prueba URLs de muestra contra su URL canónica, la respuesta y los informes de indexación.
robots.txt ayuda al descubrimiento; la presentación en herramientas expone informes de procesamiento.
Search Console lista archivos enviados por informe o API, no todos los descubiertos vía robots.txt.
Opera el sitemap como infraestructura crítica de lanzamiento
La calidad del sitemap puede degradarse cuando un plugin del CMS cambia, un despliegue modifica el host canónico, reglas de caché sirven salida obsoleta o un trabajo en lote publica páginas incompletas. Incluye comprobaciones del sitemap en el trabajo de pre-lanzamiento y de rollback. No reemplaces silenciosamente un inventario completo con un archivo vacío o mal formado.
Conserva el sitemap conocido como bueno, marca cambios inesperados en el recuento y muestrea altas y bajas antes de publicar. Cuando cambian rutas, coordina redirecciones, etiquetas canónicas, enlaces internos y sitemaps como un único conjunto de cambios. Esto es una optimización proactiva de disponibilidad: protege la superficie pública descubrible antes de que rastreadores y visitantes encuentren rutas rotas.
Pausa la publicación si la salida del sitemap es inválida, vacía, del host incorrecto o no canónica.
Mantén el artefacto previo y la configuración del generador listos para rollback.