
STATUS IS UPWIKI DE OPTIMIZACIÓN WEB
32Fortalecer
SEO y visibilidad / Fortalecer

Guía de robots.txt: Controla el rastreo sin ocultar errores

Usa robots.txt para guiar el acceso de los rastreadores y combínalo con el método correcto de indexación o control de acceso según el caso.

Guía de robots.txt: Controla el rastreo sin ocultar errores — GUÍA VISUAL
LEER
8 minutos
FUENTES
6
REVALIDAR
2027-03-27
revisado
Revisor técnico de SEO y plataforma web; añade revisión de seguridad para decisiones de control de acceso o contenido sensible.
LA RESPUESTA BREVE

Empieza con la decisión.

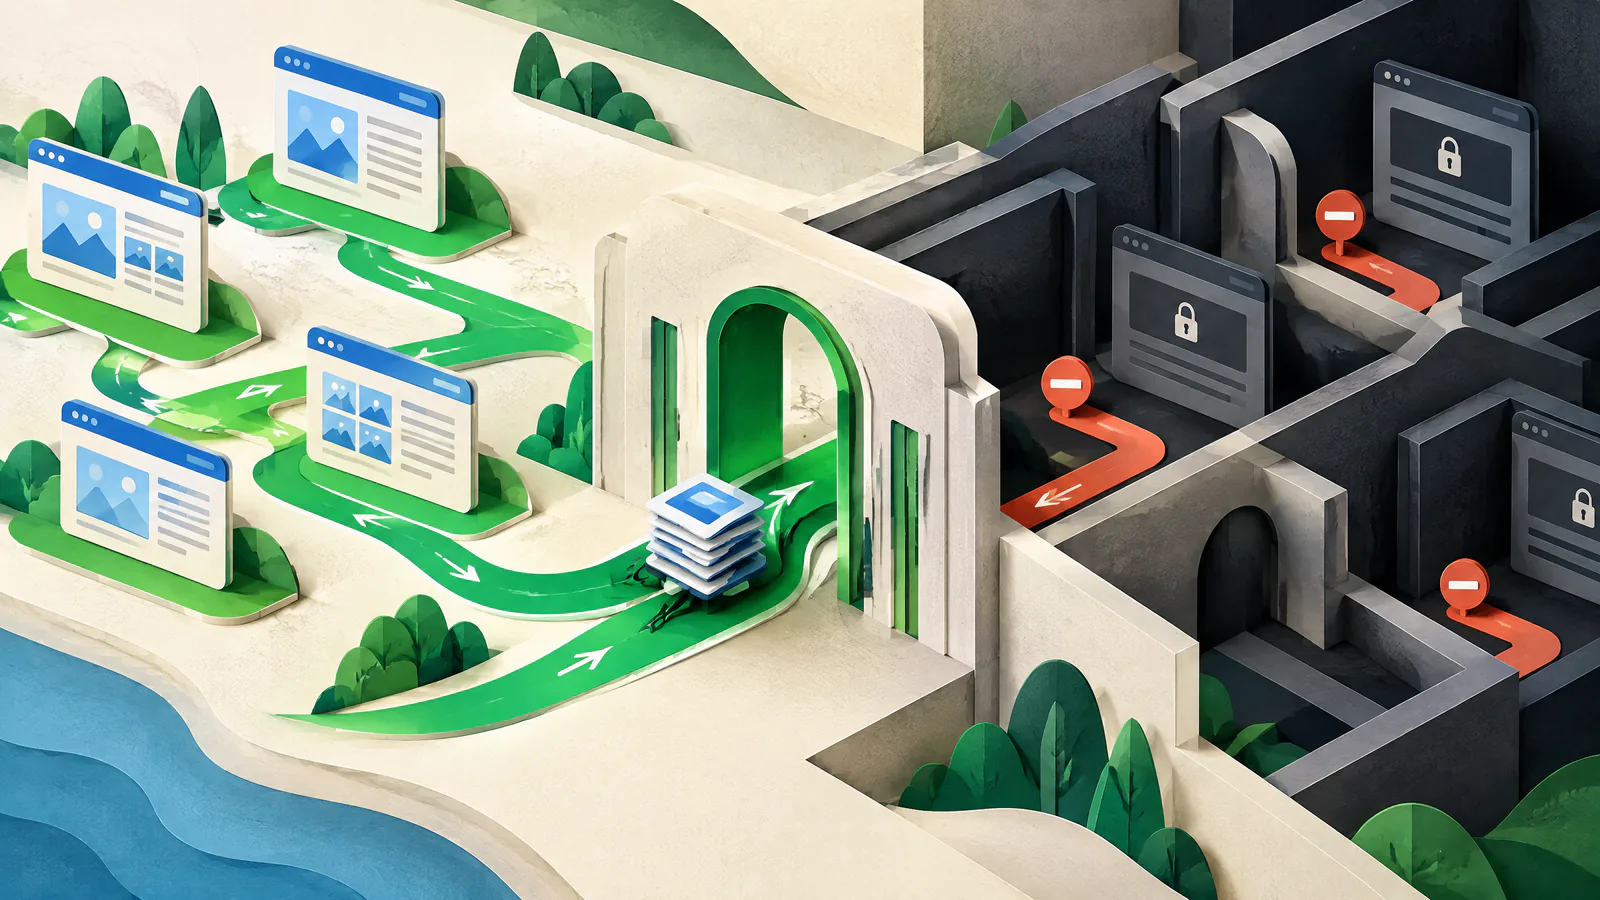
Usa robots.txt para pedir a los rastreadores cumplidores que eviten patrones públicos de URL específicos que generan trabajo de rastreo innecesario. Publica un archivo de texto plano UTF-8 en la raíz del origen exacto del sitio y empieza con pocas reglas. Es una señal de acceso para rastreadores, no una cerradura, y nunca oculta un error.

Robots.txt no oculta ni protege de forma fiable una página. Una URL bloqueada aún puede descubrirse mediante enlaces. Para contenido público que no debe indexarse, usa noindex dejando que el rastreador obtenga la respuesta. Para material privado, aplica controles de acceso en el servidor o la aplicación.

Trata las ediciones como configuración de producción: identifica el origen, prueba URLs nombradas, recupera el /robots.txt en vivo y conserva la versión anterior lista. SIU respalda la disponibilidad proactiva y la remediación mediante disciplina de preflight y rollback, no mediante alertas de caída o informes de estado.

GUÍA VISUAL

Ve el trabajo como un sistema.

Usa este mapa para conectar las decisiones del artículo antes de actuar sobre tácticas individuales.

SIUFortalecer
01Elige el control que corresponda al resultado
02Usa la sintaxis y el alcance central con precisión
03Bloquea solo patrones respaldados por evidencia de URL
04Mantén consistentes sitemap, noindex y decisiones de privacidad
01

Elige el control que corresponda al resultado

El rastreo es la recuperación automatizada de una URL. La indexación es la decisión de un motor de búsqueda de almacenar y mostrar información sobre esa URL. El control de acceso determina quién puede obtener el contenido. Robots.txt se refiere al rastreo, y los rastreadores cumplidores eligen si seguirlo. El Protocolo de Exclusión de Robots de la IETF establece que no es autorización.

Usa una regla Disallow para gestionar el acceso de rastreadores a una ruta pública de bajo valor, como una ruta de búsqueda interna controlada. Usa noindex para contenido público que no deba aparecer en resultados soportados. Usa controles de acceso reales para vistas previas, áreas de cuentas, exportaciones o datos sensibles. Para información de clientes, empleados, pagos o regulada, obtiene revisión calificada de seguridad y plataforma; robots.txt nunca es un control compensatorio.

Gestión del rastreo

Robots.txt puede pedir que los rastreadores cumplidores eviten una ruta pública definida; no garantiza la eliminación de resultados.

Control de indexación

Usa noindex en HTML o en un encabezado HTTP X-Robots-Tag y deja la respuesta accesible para que la instrucción pueda leerse.

Contenido privado

Requiere autenticación o un control apropiado en la aplicación o el servidor, y luego elimina la URL de las rutas de descubrimiento públicas.

02

Usa la sintaxis y el alcance central con precisión

Publica robots.txt en texto plano UTF-8 en /robots.txt para cada esquema, host y puerto que necesite reglas. Un archivo en https://www.example.com/robots.txt no gobierna automáticamente https://example.com, un subdominio o un origen HTTP. Verifica los orígenes servidos por URLs canónicas, redirecciones, CDN y la aplicación antes de asumir que una regla aplica.

Un grupo comienza con User-agent y luego usa Allow o Disallow con rutas. User-agent: * es el grupo general. La coincidencia distingue mayúsculas y minúsculas y comienza en el inicio del path. Gana la regla más específica; un Allow igualmente específico debería ganar sobre Disallow. Disallow: no bloquea nada, mientras que Disallow: / bloquea todo el origen. El estándar define # para comentarios, * para comodín y $ para el final de un patrón.

Línea base mínima

Si no hay una necesidad documentada de gestión de rastreo, no añadas exclusiones; no crees bloqueos especulativos.

Patrón seguro

Prefiere un prefijo estable y estrecho como /search/ en lugar de un comodín amplio o una regla de nombre de archivo sin explicación.

Comentarios

Registra el propósito de la regla, el propietario y la referencia de cambio, pero no trates los comentarios como sustituto de la revisión.

03

Bloquea solo patrones respaldados por evidencia de URL

Antes de escribir una regla, inventaría las páginas importantes, rutas de rastreo no deseadas, variantes de query, búsqueda interna, rutas de vista previa, recursos y URLs del sitemap. Para cada URL de muestra, registra el resultado esperado y la regla que coincidiría. Compara la lista con las URLs canónicas y la navegación en vivo para que un bloqueo no oculte una ruta útil.

Mantén disponibles los recursos críticos para el navegador a menos que se haya probado lo contrario. Google advierte que bloquear CSS, JavaScript, imágenes u otros recursos puede dificultar el análisis de una página. Robots.txt no resuelve la selección de contenido duplicado, la autorización o la calidad de página; usa canonicalización, redirecciones, controles de acceso o trabajo de contenido cuando corresponda.

Evidencia primero

Usa muestras reales de URL y evidencia de servidor o de rastreo, no una lista genérica copiada de otro sitio.

Tabla de cambios

Mantén cada URL de muestra, resultado previsto, regla coincidente y propietario responsable en el registro de lanzamiento.

04

Mantén consistentes sitemap, noindex y decisiones de privacidad

Un sitemap indica a los motores de búsqueda qué URLs y archivos consideras importantes; puede ayudar a la descubribilidad pero no garantiza rastreo ni indexación. Los enlaces internos fuertes siguen siendo importantes. Puedes añadir un Sitemap URL totalmente calificado en robots.txt, pero no listes URLs privadas, redireccionadas, bloqueadas por robots o intencionalmente noindex. Reconcilia la salida del sitemap con las reglas de robots en el lanzamiento.

Noindex no es una directiva de robots.txt de Google. Google lo soporta en una metaetiqueta HTML o en un encabezado HTTP X-Robots-Tag, y debe rastrear la respuesta para verlo. Si una página pública necesita salir de los resultados de Google, elimina cualquier bloqueo de robots que oculte el noindex. Si el contenido no es público, no publiques su ruta en robots.txt; aplica control de acceso. Los límites de datos sensibles necesitan revisión calificada.

Declaración de sitemap

Usa una URL completa, por ejemplo Sitemap: https://www.example.com/sitemap.xml; no anula un bloqueo de rastreo.

HTML y archivos

Usa un meta noindex para HTML o un encabezado X-Robots-Tag: noindex cuando proceda, y luego prueba la respuesta en vivo.

Exposición urgente

Restringe el acceso primero cuando el contenido sea sensible, luego usa el proceso de eliminación del motor de búsqueda cuando corresponda.

05

Prueba y publica como un archivo de configuración crítico

Valida el texto aprobado localmente y luego prueba ejemplos permitidos y denegados para el grupo de rastreadores previsto. Después del despliegue, recupera /robots.txt público de forma privada o mediante una petición HTTP directa para confirmar el contenido, el origen y el estado de la respuesta. Google ofrece un informe de robots.txt en Search Console para archivos accesibles y una librería parser de código abierto para pruebas locales.

Los rastreadores pueden almacenar en caché archivos robots, así que no esperes cambios inmediatos en descubrimiento o indexación. Los errores de servidor o de red llevan a los rastreadores a asumir un disallow completo, mientras que un 4xx puede permitir acceso. Mantén el archivo en control de código fuente, exige revisión adicional para cambios de sitio completo o comodines, y conserva la versión anterior. Los preflights y la planificación de rollback de SIU ayudan a detectar un mal lanzamiento antes de que se convierta en un problema mayor de disponibilidad o descubribilidad.

Puerta de lanzamiento

Requiere un segundo revisor para migraciones de origen, bloqueos de sitio completo, comodines y cambios que afecten rutas de inicio de sesión, pago o soporte.

Señal de rollback

Restaura la versión anterior cuando una URL de muestra importante quede recién bloqueada, un recurso necesario sea inaccesible o el endpoint no esté disponible.

Límite

Una prueba de rastreador no demuestra que cada cliente automatizado interprete todas las reglas de la misma manera.

ACCIÓN / VERIFICAR

Tu guía práctica de tareas.

  1. 01

    Clasifica el objetivo

    Elige gestión de rastreo, exclusión de indexación o acceso privado antes de seleccionar un control.

    VERIFICAR: Cada URL afectada tiene un propósito documentado y un propietario responsable.
  2. 02

    Mapea el origen

    Identifica el protocolo exacto, host, puerto, subdominio, CDN y origen de la app involucrados.

    VERIFICAR: Ningún origen se asume que herede las reglas robots de otro origen.
  3. 03

    Lista URLs representativas

    Incluye páginas importantes, objetivos, variantes, recursos, entradas de sitemap y rutas privadas.

    VERIFICAR: Una tabla nombra el resultado esperado para cada URL de prueba.
  4. 04

    Escribe reglas estrechas

    Usa User-agent, Allow y Disallow claros; evita comodines amplios a menos que sean necesarios.

    VERIFICAR: Un revisor puede explicar el alcance y las excepciones de cada regla.
  5. 05

    Implementa noindex correctamente

    Usa una metaetiqueta o un encabezado de respuesta para contenido público excluido de Google.

    VERIFICAR: El objetivo en vivo es rastreable y expone noindex al rastreador.
  6. 06

    Protege material no público

    Usa controles de autenticación o en servidor y aplicación, no robots.txt.

    VERIFICAR: Una petición no autenticada no puede obtener contenido sensible.
  7. 07

    Publica el archivo aprobado

    Despliega texto plano UTF-8 en la raíz del origen.

    VERIFICAR: La URL /robots.txt en vivo devuelve el archivo revisado.
  8. 08

    Prueba el comportamiento en vivo

    Comprueba muestras permitidas y bloqueadas con las herramientas apropiadas.

    VERIFICAR: Los resultados coinciden con la tabla de lanzamiento, incluidas las excepciones.
  9. 09

    Reconcilia las entradas de descubrimiento

    Mantén el sitemap y los enlaces internos consistentes con las decisiones de rastreo e indexación.

    VERIFICAR: Ninguna URL intencionalmente privada, redireccionada, noindex o bloqueada está en el sitemap sin una razón.
  10. 10

    Mantén el rollback listo

    Almacena el archivo previo y añade el cambio de regla a los procedimientos de lanzamiento y recuperación.

    VERIFICAR: Una versión conocida y buena y un propietario de rollback son identificables de inmediato.
TEMAS DE DISCUSIÓN

Compara las ventajas y desventajas; no compartas datos privados.

Usa estas preguntas con tu equipo o la comunidad de propietarios del sitio. Comparte métodos y lecciones, pero nunca pegues credenciales, registros de clientes ni detalles de infraestructura no públicos.

  1. 01

    Qué patrones de URL públicos generan trabajo de rastreo en tu sitio y qué evidencia te ayudó a distinguir un problema real de una variación inocua?

  2. 02

    Cómo revisa tu equipo un cambio en robots.txt junto con sitemap, canonical y decisiones de control de acceso antes de un lanzamiento?

  3. 03

    Qué señal de rollback indicaría a tu equipo que una nueva regla de rastreo está perjudicando una ruta importante para usuarios o negocio?

RECURSOS POPULARES / DE REFERENCIA

Consulta el material fuente.

Google Search CentralIntroduction to robots.txt ↗

Explica el uso previsto por Google, los límites en los resultados de búsqueda y los límites de seguridad de robots.txt.

Revisado 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

La referencia en ruta de estándares para sintaxis, coincidencia, alcance, errores, caché y límites de seguridad.

Revisado 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Muestra el uso de la metaetiqueta noindex y del encabezado HTTP y por qué la respuesta debe permanecer rastreable.

Revisado 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Cubre la colocación, la sintaxis soportada, las declaraciones de sitemap y las opciones de prueba.

Revisado 2026-09-27
Google Search CentralLearn about sitemaps ↗

Aclara los beneficios y límites del descubrimiento por sitemap y la importancia de los enlaces internos.

Revisado 2026-09-27
MDN Web DocsHTTP authentication ↗

Un resumen de control de acceso HTTP y consideraciones HTTPS para autenticación.

Revisado 2026-09-27

Política de fuentes. Este artículo usa estándares primarios y documentación oficial enlazada. Verifica la configuración específica del producto contra la documentación actual de la plataforma antes del lanzamiento.

ACLARACIONES RÁPIDAS

Preguntas comunes.

¿Puede robots.txt mantener una página fuera de Google Search?

No. Una URL bloqueada aún puede descubrirse y aparecer en los resultados. Usa noindex rastreable para contenido público que no deba indexarse y controla el acceso para contenido privado.

¿Cuál es el archivo robots.txt de inicio más seguro?

Empieza sin exclusiones a menos que puedas documentar una necesidad de gestión de rastreo. Añade solo rutas estrechas que hayas probado contra páginas y recursos importantes.

¿Debería listarse un sitemap en robots.txt?

Puede listarse. Una línea Sitemap totalmente calificada ayuda al descubrimiento de rastreadores pero no fuerza el rastreo o la indexación, y no anula un bloqueo de robots.

Status Is UP Editorial Team · Editores de Habilitación de Disponibilidad (Uptime Enablement Editors)

Revisado por Revisor técnico de SEO y plataforma web; añade revisión de seguridad para decisiones de control de acceso o contenido sensible.. Publicado 2026-09-27; actualizado 2026-09-30.