
Wybierz kryterium przynależności przed wygenerowaniem XML
Mapa witryny XML to maszyna do odczytu lista URL-i oraz opcjonalnych metadanych. Zacznij od reguły przynależności, a nie od eksportu crawlera: uwzględnij stronę tylko wtedy, gdy jest przeznaczona do wyszukiwania, publicznie dostępna i stanowi preferowaną wersję swojej treści. Trzymaj poza nią adresy katalogów z fasetami, wyniki wewnętrznej wyszukiwarki, warianty kampanii, miejsca logowania i podglądy, chyba że są one świadomymi publicznymi celami wyszukiwania.
Strony publiczne i użyteczne przeznaczone do wyszukiwania z jedną preferowaną wersją URL.
Przekierowania, błędy, duplikaty, strony z noindex i trasy prywatne.
Pomoc przy odkrywaniu nie gwarantuje crawlowania ani indeksowania.
Wypisz URL kanoniczny, nie każdy sposób jego osiągnięcia
URL kanoniczny to wersja, którą chcesz, żeby wyszukiwarki traktowały jako reprezentatywną spośród podobnych wersji. Umieszczenie w mapie witryny jest słabym sygnałem kanoniczności, więc powinno wzmacniać — a nie przeczyć — przekierowaniom, samoodwołującym się tagom canonical i linkom wewnętrznym. Wybierz jedną stabilną formę HTTPS i emituj dokładnie tę wersję.
Sprawdź http i https, wersje z www i bez, zasady dotyczące ukośników, wielkość liter, strony do druku, filtry i parametry śledzące. Jeśli URL przekierowuje, wpisuj tylko jego końcowy, kanoniczny cel. Każda niezależnie przeznaczona strona zlokalizowana powinna mieć własny URL kanoniczny; nie używaj mapy witryny do konsolidowania odrębnych, zlokalizowanych treści.
Zapisuj cały schemat i host, nie ścieżkę względną. Google crawluje URL-e tak, jak są wymienione.
Mapa witryny, tag canonical, linki wewnętrzne i polityka przekierowań powinny wskazywać tę samą stronę.
Zablokowanie duplikatu nie ustanawia preferowanej wersji.
Zadbaj, żeby XML był mały, poprawny i prawdziwy
Używaj struktury protokołu map witryn: UTF-8 XML z urlset, przestrzenią nazw mapy witryn i elementem loc dla każdego URL-a. Uciecz znaków wrażliwych dla XML w wartościach URL. Automatyzacja powinna serializować URL-e zamiast sklejać XML ręcznie.
Każda mapa witryny może zawierać maksymalnie 50 000 URL-i i mieć nie więcej niż 50 MB przed dekompresją. To limity, a nie cele. Dziel pliki wcześniej, jeśli produkty, artykuły, lokalizacje lub typy treści tworzą użyteczną granicę operacyjną.
Używaj lastmod tylko dla rzeczywistej daty istotnej zmiany strony. Google używa jej, gdy jest konsekwentnie i weryfikowalnie dokładna; aktualizacja roku praw autorskich nie kwalifikuje się. Nigdy nie znacznicz każdej pozycji czasem wygenerowania. Google ignoruje changefreq i priority, więc pomiń je.
loc jest wymagany; lastmod jest opcjonalny i musi opisywać stronę, nie wygenerowanie pliku.
Gzip może zmniejszyć rozmiar transferu, ale rozpakowany plik musi pozostać poniżej 50 MB.
Sprawdź poprawność składni XML, dostępność do pobrania i zachowanie wymienionych stron.
Używaj indeksów, aby skalować bez utraty odpowiedzialności
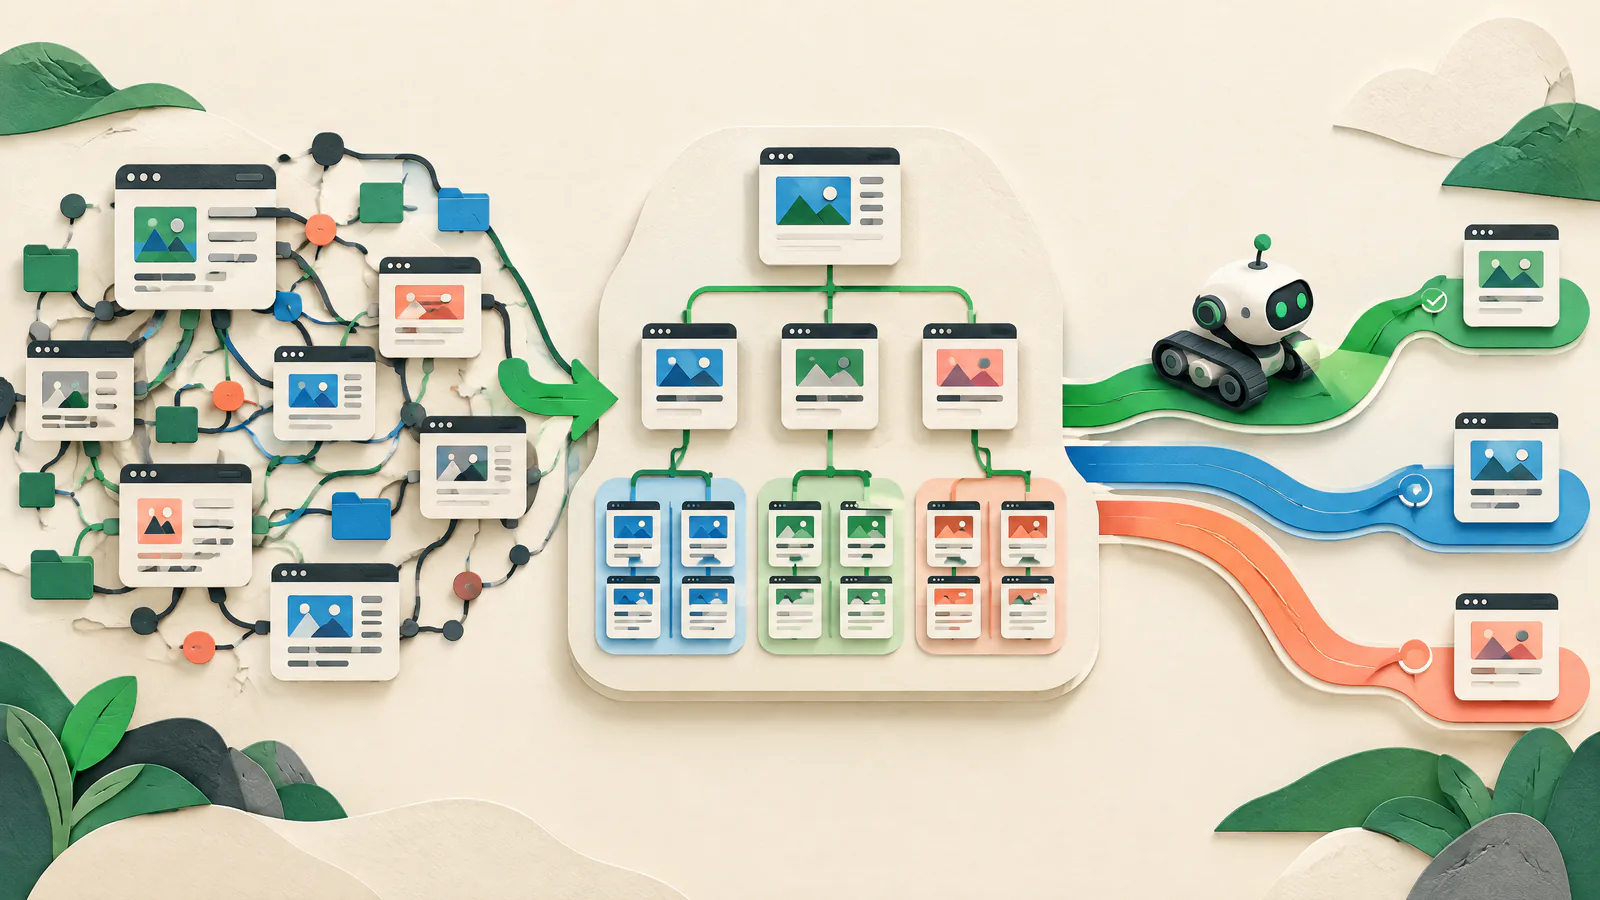
Indeks map witryn (sitemap index) wymienia pliki map witryn. Użyj go, gdy strona przekracza limit jednego pliku lub potrzebuje osobnych inwentarzy. Grupuj według redakcji, produktu lub właściciela centrum pomocy. Ma te same limity 50 000 pozycji i 50 MB przed dekompresją.
Trzymaj pliki podrzędne na zamierzonej domenie pod stabilnymi URL-ami. Protokół zazwyczaj wiąże uprawnione URL-e z hostem i lokalizacją mapy witryny; układy między różnymi witrynami wymagają zweryfikowanej własności.
Dziel wokół testowalnego celu — typ treści, sklep, zestaw językowy albo granica wdrożeniowa. Zapisz generator, właściciela i spodziewaną zawartość.
Zgłoś kompletny indeks zamiast każdego pliku podrzędnego ręcznie.
lastmod w indeksie opisuje plik mapy witryn, nie jego strony.
Publikuj, zgłaszaj i interpretuj wyniki poprawnie
Hostuj mapę witryny pod stabilnym, publicznie dostępnym adresem HTTPS, najlepiej blisko katalogu głównego. Dodaj absolutną dyrektywę Sitemap do robots.txt. Zgłoś mapę witryny lub indeks w Google Search Console i Bing Webmaster Tools, aby uzyskać szczegóły przetwarzania.
W Search Console Sukces oznacza, że mapa została pobrana i odczytana bez błędów. Ma błędy oznacza, że została odczytana z błędami; Nie udało się pobrać oznacza, że była niedostępna. Napraw dostarczanie, uwierzytelnianie, DNS, robots, przekierowania lub XML i wyślij ponownie.
Traktuj liczbę odkrytych stron jako dane diagnostyczne, a nie wynik. Odkryta strona nie jest gwarantowana do crawlowania ani indeksowania. Próbkuj URL-e względem ich kanonicznego URL, odpowiedzi serwera i raportów indeksowania.
robots.txt pomaga w odkrywaniu; zgłoszenie w narzędziach ujawnia raporty przetwarzania.
Search Console wymienia pliki zgłoszone przez raport lub API, a nie każde odnalezienie przez robots.txt.
Operuj mapą witryny jako infrastrukturą krytyczną dla wydań
Jakość mapy witryny może się pogorszyć, gdy wtyczka CMS się zmieni, wdrożenie zmieni kanoniczny host, reguły cache będą serwować przestarzały output lub masowy proces opublikuje niekompletne strony. Włącz kontrole map witryny w pracy przed wydaniem i przy rollbackach. Nie zastępuj cichego pełnego inwentarza pustym lub uszkodzonym plikiem.
Zachowaj wcześniejszą znaną dobrą mapę witryny, sygnalizuj nieoczekiwane zmiany liczby wpisów i próbkuj dodania oraz usunięcia przed publikacją. Gdy ścieżki się zmieniają, skoordynuj przekierowania, tagi canonical, linki wewnętrzne i mapy witryn jako jeden zestaw zmian. To proaktywna optymalizacja dostępności: chroń odkrywalną powierzchnię publiczną zanim crawlerzy i odwiedzający napotkają uszkodzone ścieżki.
Wstrzymaj publikację w przypadku niepoprawnego, pustego, z niewłaściwym hostem lub niekanonicznego outputu mapy witryny.
Przechowuj poprzedni artefakt i konfigurację generatora gotowe do rollbacku.