
STATUS IS UPWIKI OPTYMALIZACJI WITRYN
29Wzmacniaj
SEO i widoczność / Wzmacniaj

Audit techniczny SEO: praktyczny przewodnik właściciela

Praktyczny, oparty na dowodach audyt służący wykrywaniu technicznych barier dla odkrywalności w wyszukiwarkach i zmniejszaniu ryzyka ich powrotu.

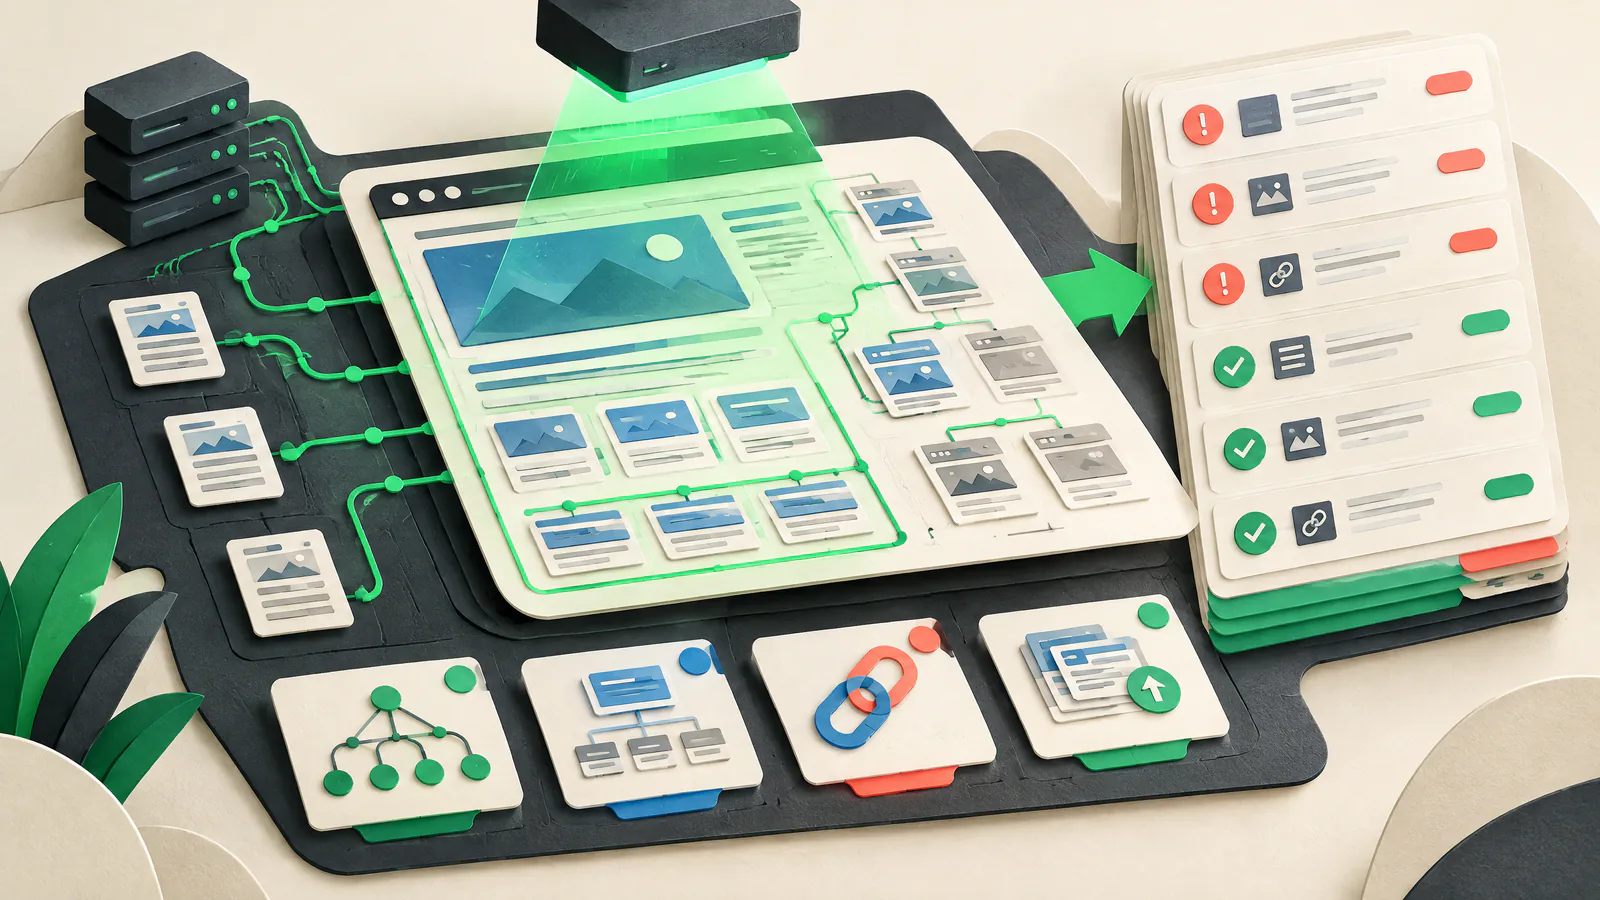
Audit techniczny SEO: praktyczny przewodnik właściciela — PRZEWODNIK WIZUALNY
CZYTAJ
8 min
ŹRÓDŁA
6
ZWERYFIKUJ PONOWNIE
2027-03-27
przejrzano
Technical SEO and web platform reviewer
KRÓTKA ODPOWIEDŹ

Zacznij od decyzji.

Przeprowadź audyt techniczny SEO jako krótką pętlę dowodową: zdecyduj, które publiczne strony powinny być odnajdywane, przetestuj ich odpowiedź i docelowy URL, sprawdź mechanizmy indeksowania i sygnały kanoniczne, porównaj źródło z wyrenderowaną treścią, a następnie uzgodnij linki i mapy witryny. Napraw najpierw wzorzec o największym wpływie i ponownie przetestuj po wdrożeniu.

Staw blokery przed tabelami ze skorami. Niezamierzony noindex, błąd serwera, nieprawidłowe przekierowanie, sprzeczny rel=canonical lub brak wyrenderowanej treści mogą uniemożliwić rozpatrzenie wartościowej strony do indeksacji. Odpowiedź 200 to tylko możliwość przetwarzania, a nie gwarancja indeksowania czy pozycji.

Utrzymuj wynik operacyjny: wykryty wzorzec, oczekiwane zachowanie, dowód, właściciel, plan wdrożenia i ścieżka rollbacku. Status Is UP wspiera proaktywne optymalizacje dostępności i naprawy, dzięki czemu ważne strony pozostają niezawodnie osiągalne i kompletne; nie jest to monitorowanie statusu w czasie rzeczywistym ani obietnica wyników wyszukiwarki.

PRZEWODNIK WIZUALNY

Zobacz pracę jako system.

Użyj tej mapy, aby połączyć decyzje z artykułu, zanim przejdziesz do poszczególnych taktyk.

SIUWzmacniaj
01Zacznij od zamierzonych stron i powtarzalnych dowodów
02Uczyń indexowalność świadomą decyzją
03Ustal jeden preferowany URL
04Sprawdź kody statusu i zachowanie przekierowań
01

Zacznij od zamierzonych stron i powtarzalnych dowodów

Wypisz publiczne strony, które chcesz, aby wyszukiwarki znajdowały: kluczowe produkty, artykuły, kategorie i przeniesione adresy URL. Dla każdej zanotuj preferowany URL, oczekiwaną odpowiedź, indexowalność, szablon, właściciela i priorytet. Trzymaj prawidłowe wyłączenia oddzielnie.

Zachowaj niezalogowaną odpowiedź, nagłówki, ścieżkę przekierowań, źródło strony, widok po renderowaniu, stan linków wewnętrznych i stan mapy witryny dla reprezentatywnych URL-i. Próbkuj każdy szablon i wzorzec URL. Dowód jest datowany: ustawienie CDN, deployment, warstwa zgody lub personalizacja mogą to zmienić później.

Testuj wzorce

Działająca strona główna nie dowodzi, że listingi, warianty produktów czy zlokalizowane ścieżki działają poprawnie.

Zapisz bazę

Przechowuj datowane nagłówki i dowody renderowania, aby móc porównać naprawy i późniejsze regresje.

02

Uczyń indexowalność świadomą decyzją

Indexowalność oznacza, że strona może zostać uwzględniona w indeksie wyszukiwarki; nie jest to tożsame z crawlowaniem czy rankingiem. Sprawdź dyrektywy meta robots w HTML i nagłówki odpowiedzi X-Robots-Tag. Dyrektywa noindex informuje wyszukiwarki, aby nie pokazywały strony; X-Robots-Tag dotyczy też plików niebędących HTML, np. PDF-ów.

Przejrzyj osobno robots.txt. Crawler musi mieć dostęp do strony, aby zobaczyć dyrektywę noindex, więc zablokowanie tego URL-a może uniemożliwić odczytanie dyrektywy. Sprawdź wdrożoną, publiczną odpowiedź, ponieważ ustawienia CMS i flagi środowiskowe mogą dodawać reguły. Noindex nie jest mechanizmem kontroli dostępu: chroń materiały wrażliwe przez uwierzytelnianie i odpowiednią ocenę bezpieczeństwa.

Znajdź przypadkowe wyłączenia

Oznacz noindex, odpowiedzi wymagające logowania, odniesienia do środowisk staging oraz zablokowane zasoby istotne dla stron przeznaczonych do indeksowania.

Sprawdź też nagłówki

Nagłówek HTTP może zawierać dyrektywę nawet tam, gdzie nie ma sekcji head HTML.

03

Ustal jeden preferowany URL

Kanoniczność identyfikuje preferowany URL spośród duplikatów lub bardzo podobnych wersji, takich jak HTTP i HTTPS, różne hosty, parametry śledzące, filtry czy wersje do druku. Porównaj element rel=canonical, linki wewnętrzne, URL w mapie witryny i miejsce docelowe przekierowania. Dla strony indexowalnej powinny one zwykle wskazywać ten sam absolutny preferowany URL.

Użyj trwałego przekierowania po stronie serwera przy wycofywaniu duplikatu. Google opisuje przekierowania trwałe i rel=canonical jako silne sygnały, podczas gdy uwzględnienie w mapie witryny jest słabsze; zgrane sygnały wzmacniają preferencję. Nie używaj robots.txt do kanonizacji ani nie dopuszczaj konkurencyjnych kanonikalnych sygnałów. Kanonikal samoodniesiony pomaga zadeklarować preferowaną wersję, ale wybór wyszukiwarki pozostaje poza twoją kontrolą.

Mapuj każdą rodzinę

S dokumentuj warianty, preferowany cel, wymagany mechanizm kontroli i właściciela.

Chroń zmiany

Przetestuj mapowania stary→nowy przed migracją i miej gotową odwracalną zmianę przekierowania.

04

Sprawdź kody statusu i zachowanie przekierowań

Kody statusu informują przeglądarki i crawlery, co się wydarzyło. Ważne strony na żywo powinny zwracać sensowną odpowiedź 2xx z zamierzoną treścią. Strona bez odpowiedniego zastępstwa powinna zwracać prawdziwe 404 lub 410; przeniesione treści powinny prowadzić do najbliższego istotnego zamiennika. Strona z odpowiedzią 200 pokazująca wyłącznie błąd może być traktowana jako soft 404.

Zapisz każdy przeskok przekierowania. Google ogólnie śledzi do 10 przeskoków dla ogólnego crawlowania, ale łańcuchy dodają opóźnienia i podatność na błędy. Google informuje, że odpowiedzi 5xx i 429 mogą tymczasowo spowolnić crawlowanie, a uporczywe błędy serwera mogą ostatecznie usunąć zindeksowane URL-e. Badaj powtarzające się awarie z właścicielem inżynieryjnym w warstwach aplikacji, CDN, origin, cache, zależności i deploymentu.

Klasyfikuj wyniki

Zapisz oryginalny URL, przeskoki, kody, finalny URL i oczekiwany stan.

Napraw zestaw reguł

Usuń nakładające się reguły CMS, CDN, hosta, lokalizacji lub ukośników zamiast dodawać kolejny przeskok.

05

Weryfikuj renderowanie JavaScript i routing

Sprawdź zarówno początkowy HTML, jak i widok po renderowaniu dla kluczowych szablonów. Potwierdź obecność głównej treści, nagłówków, linków, rel=canonical, dyrektyw robots i stanu po renderowaniu. Google opisuje oddzielne fazy crawl, render i index i stwierdza, że treść niewidoczna w wyrenderowanym HTML nie może zostać zindeksowana.

Używaj elementów anchor z wartościami href do nawigacji. Trasy oparte wyłącznie na fragmencie (fragment-only) ładujące odrębną treść nie są niezawodne dla odkrywania. Bezpośrednio żądaj nieistniejących produktów, artykułów i przefiltrowanych URL-i. Aplikacje po stronie klienta potrzebują prawdziwego stanu błędu; Google dokumentuje routing do serwerowego 404 lub dodanie noindex, aby uniknąć soft 404. Renderowanie po stronie serwera lub prerendering może pomóc, ale zweryfikuj wdrożoną odpowiedź.

Porównaj trzy widoki

Sprawdź HTML odpowiedzi, wyrenderowany HTML i widok przeglądarki dla istotnych różnic.

Utrzymaj stabilną kanonikalność

Preferuj kanonikal z HTML źródłowego; jeśli JavaScript go ustawia, upewnij się, że istnieje jedna, niesprzeczna wartość rel=canonical.

06

Utrzymuj czyste mapy witryny i linki wewnętrzne

Mapa witryny to mapa odkrywania, nie polecenie indeksowania. Uwzględniaj poprawne, zamierzone, preferowane kanoniczne URL-e; wyklucz przekierowania, błędy, strony noindex, duplikaty parametryczne i chronione URL-e. Google zaleca pełne, kwalifikowane URL-e, a uwzględnienie w mapie traktuje się jako wskazówkę kanoniczną, nie gwarancję.

Zwaliduj mapę witryny i porównaj ją z listą zamierzonych do indeksu i nawigacją. Google dokumentuje kodowanie UTF-8 i limit 50 MB nieskompresowane lub 50 000 URL-i na mapę witryny. Dla większych witryn dziel na użyteczne grupy i użyj indeksu map witryn. Aktualizuj lastmod tylko przy znaczących, weryfikowalnych zmianach strony.

Uzgodnij listy

Zbadaj znaczące różnice między zamierzonymi URL-ami, wpisami w mapie witryny i linkami wewnętrznymi.

Ponownie pobierz po wdrożeniu

Sprawdź wygenerowaną mapę witryny i próbkę zgłoszonych URL-i po zmianach routingu lub CMS.

07

Mierz wydajność i uczynij audyt częścią procesu

Używaj danych z realnego ruchu, gdy są dostępne, oraz kontrolowanych testów laboratoryjnych do badania Core Web Vitals (Podstawowe wskaźniki internetowe): Largest Contentful Paint (LCP) dla ładowania, Interaction to Next Paint (INP) dla responsywności oraz Cumulative Layout Shift (CLS) dla stabilności wizualnej. Segmentuj według typu strony i urządzenia, ponieważ średnie mogą ukrywać uszkodzony, wysoko-wartościowy szablon.

Śledź wolne lub niestabilne dostarczanie przez obrazy, CSS i JavaScript, tagi zewnętrzne, czcionki, osadzenia i cache. Wprowadź jedną mierzoną zmianę, a potem ponownie sprawdź renderowanie i ścieżki użytkownika. Dane polowe odzwierciedlają prawdziwych użytkowników; dane laboratoryjne pomagają odtworzyć problemy. Żadne z nich nie przewiduje każdego przyszłego crawlera czy odwiedzającego. Powtórz ukierunkowaną kontrolę regresji po ryzykownych wydaniach i pełniejszy audyt po migracjach lub zmianach platformy.

Priorytetyzuj ekspozycję

Napraw awarie w szablonach krytycznych dla przychodów lub intensywnie używanych przed drobnymi poprawkami punktów oceny.

Zamknij dowodem

Ponownie sprawdź odpowiedź, rel=canonical, wyrenderowaną treść, stan mapy witryny i istotne dowody wydajności przed zamknięciem zadania.

DZIAŁANIE / WERYFIKACJA

Twój praktyczny przewodnik z zadaniami.

  1. 01

    Ustal inwentarz zamierzonych do indeksu

    Wypisz kluczowe publiczne URL-e według szablonu z oczekiwanym rel=canonical, indexowalnością, priorytetem i właścicielem.

    SPRAWDŹ: Każdy główny szablon ma próbkowany, udokumentowany oczekiwany stan.
  2. 02

    Zarejestruj publiczne odpowiedzi

    Zachowaj status, nagłówki, przeskoki przekierowań, finalny URL i typ treści bez sesji zalogowanej.

    SPRAWDŹ: Żaden ze zbadanych ważnych URL-i nie ma niewyjaśnionego łańcucha ani błędu serwera.
  3. 03

    Przejrzyj mechanizmy indeksowania

    Sprawdź meta robots, X-Robots-Tag i dostępność robots.txt.

    SPRAWDŹ: Strony zamierzone do indeksu nie mają przypadkowych wyłączeń, a strony wrażliwe korzystają z kontroli dostępu.
  4. 04

    Uzgodnij sygnały kanoniczne

    Porównaj tagi kanoniczne, przekierowania, linki wewnętrzne, mapy witryny, host i wybór HTTPS.

    SPRAWDŹ: Każda rodzina duplikatów ma jeden udokumentowany preferowany URL lub pisemne odstępstwo.
  5. 05

    Przetestuj awarie i przeniesienia

    Zażądaj starych, nieistniejących, HTTP, alternatywnych hostów i usuniętych URL-i.

    SPRAWDŹ: Przeniesienia są bezpośrednie i istotne; brakująca treść nie zwraca szablonu błędu z kodem 200.
  6. 06

    Sprawdź renderowanie

    Porównaj źródło i wyrenderowany wynik pod kątem tekstu, linków, metadanych i ścieżek błędów.

    SPRAWDŹ: Istotna treść i linki możliwe do przeszukania są widoczne po renderowaniu.
  7. 07

    Zwaliduj mapę witryny i linki

    Porównaj mapę witryny, listę zamierzoną do indeksu i nawigację wewnętrzną.

    SPRAWDŹ: W mapie są tylko poprawne, preferowane URL-e przeznaczone do odkrywania.
  8. 08

    Mierz według typu strony

    Przejrzyj dowody z pola i laboratorium dotyczące wydajności, włączając zależności i zasoby.

    SPRAWDŹ: Każda poprawka wydajności ma nazwany szablon, dowód i kontrole regresji.
  9. 09

    Wydaj bezpiecznie i ponownie przetestuj

    Wdróż pogrupowane poprawki z planem rollbacku, a potem powtórz odpowiednie kontrole.

    SPRAWDŹ: Zamknięte prace o wysokim priorytecie mają dowód przed i po.
TEMATY DO DYSKUSJI

Porównuj kompromisy, nie dane prywatne.

Użyj tych pytań z zespołem lub społecznością właścicieli witryn. Dziel się metodami i lekcjami, ale nigdy nie wklejaj poświadczeń, danych klientów ani niepublicznych informacji infrastruktury.

  1. 01

    Który wzorzec URL spowodował u Ciebie najbardziej rozległy problem z odkrywalnością techniczną i jakie dowody ujawniły wspólną przyczynę?

  2. 02

    Jak decydujesz, czy duplikat powinien być przekierowany, zadeklarowany jako rel=canonical, pozostać dostępny, czy zostać wykluczony?

  3. 03

    Która kontrola wydania najlepiej wykrywa regresje renderowania, mapy witryny lub odpowiedzi, zanim dotrą one do ważnych stron?

POPULARNE / AUTORYTATYWNE ZASOBY

Otwórz materiały źródłowe.

Google Search CentralHow to specify a canonical URL with rel=canonical and other methods ↗

Sygnały kanoniczne, przekierowania, kanonikal samoodniesiony i konflikty których należy unikać.

Przejrzano 2026-09-27
Google Search CentralUnderstand the JavaScript SEO basics ↗

Poradnik dotyczący crawlowania, renderowania, tras, wstrzyknięcia kanonikalu i soft 404 dla aplikacji JavaScript.

Przejrzano 2026-09-27
Google for DevelopersHow HTTP status codes affect Google’s crawlers ↗

Odniesienie dla obsługi odpowiedzi 2xx, przekierowań, 4xx, 429 i 5xx przez crawlery.

Przejrzano 2026-09-27
Google Search CentralBuild and submit a sitemap ↗

Wybór URL-i do mapy witryny, limity, lastmod i zastrzeżenia przy zgłaszaniu.

Przejrzano 2026-09-27
Google Search CentralRobots meta tag, data-nosnippet, and X-Robots-Tag specifications ↗

Dyrektywy indeksowania, nagłówki dla plików nie-HTML oraz różnica między crawlowaniem a noindex.

Przejrzano 2026-09-27
web.devLearn Core Web Vitals ↗

Materiały pomocne przy metrykach doświadczenia podstawowego (Core Web Vitals).

Przejrzano 2026-09-27

Polityka źródeł. Oparte na oficjalnych stronach Google Search Central, Google for Developers i web.dev przeczytanych w dniu dostępu. Udokumentowane zachowanie crawlera rozróżnione jest od praktycznych zaleceń; indeksowanie i pozycjonowanie nie są gwarantowane.

SZYBKIE WYJAŚNIENIA

Często zadawane pytania.

Jak często powinienem przeprowadzać audyt techniczny SEO?

Przeprowadzaj ukierunkowane kontrole regresji po zmianach w szablonach, routingu, CMS, CDN, tagach lub zależnościach. Wykonaj pełniejszy audyt po migracji, redesignie, zmianie platformy lub dużych pracach na URL-ach. Dopasuj częstotliwość do ryzyka zmian i znaczenia biznesowego.

Czy status 200 oznacza, że strona będzie miała pozycję lub zostanie zindeksowana?

Nie. Odpowiedź 200 umożliwia przetwarzanie, ale nie gwarantuje indeksowania ani pozycji. Nadal ważne są mechanizmy indeksowania, spójność kanonikalna, dostępność użytecznej treści i ocena wyszukiwarki.

Czy powinienem blokować duplikaty w robots.txt?

Zwykle nie. Robots.txt nie jest mechanizmem kanonizacji, a blokowanie może uniemożliwić odkrycie dyrektywy noindex. Wyrównaj preferowany URL, przekierowania, sygnał kanonikalny, linki wewnętrzne i mapę witryny; użyj kontroli dostępu dla treści wrażliwych.

Status Is UP Editorial Team · Uptime Enablement Editors

Sprawdził(a): Technical SEO and web platform reviewer. Opublikowano: 2026-09-27; zaktualizowano: 2026-09-30.