
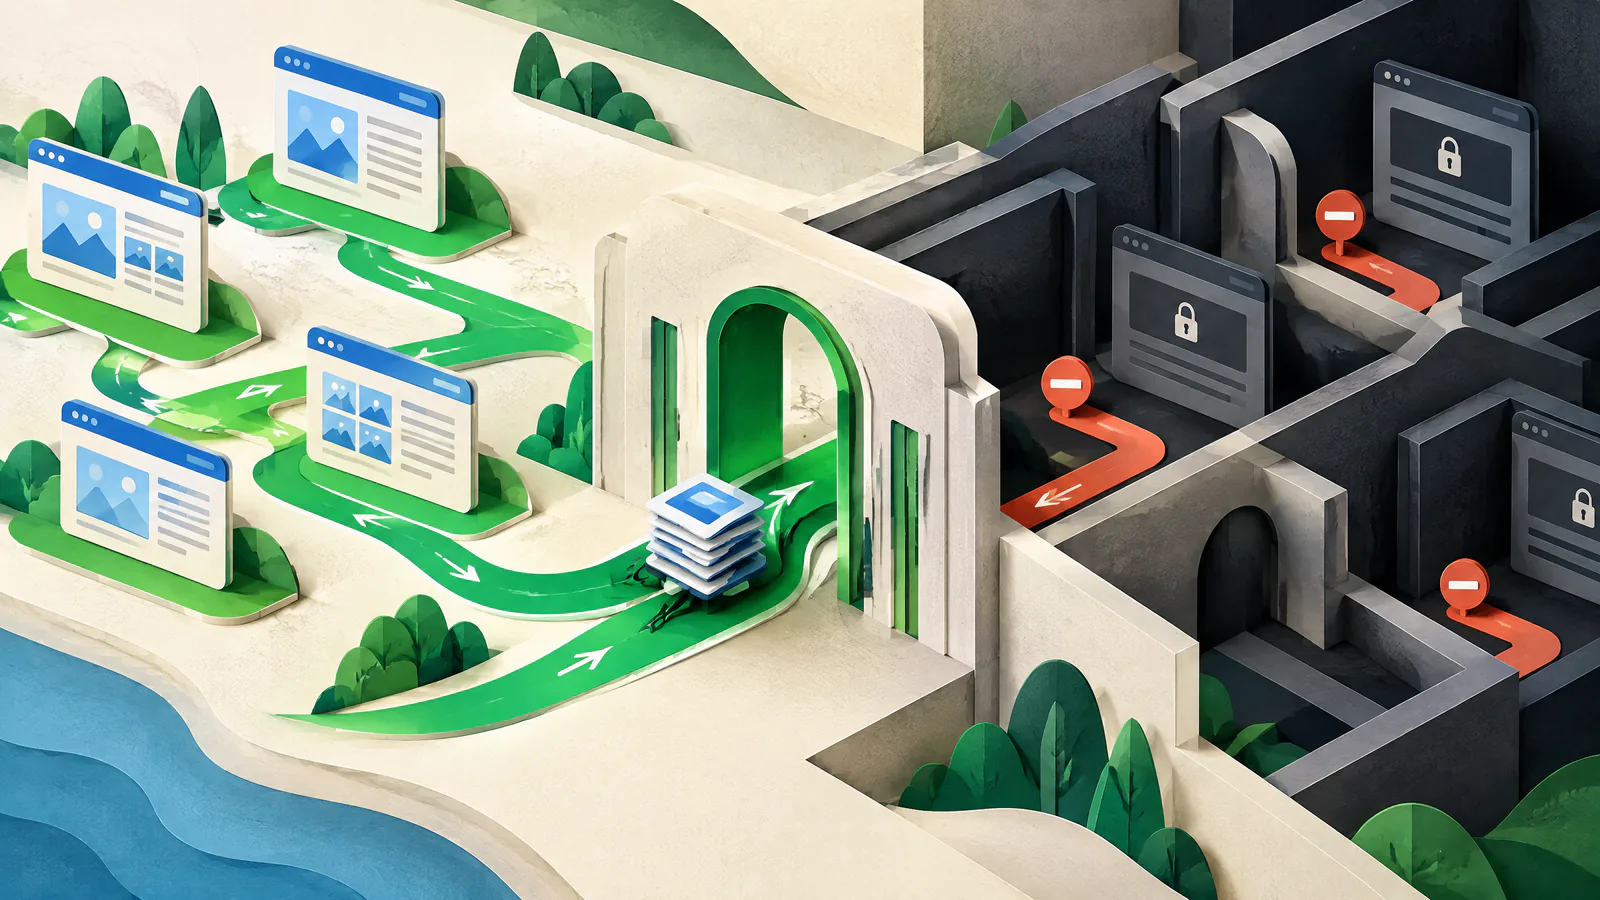
Wybierz kontrolę dopasowaną do oczekiwanego rezultatu
Crawling to zautomatyzowane pobieranie URL. Indeksowanie to decyzja wyszukiwarki o przechowywaniu i pokazywaniu informacji o URL. Kontrola dostępu decyduje, kto może uzyskać treść. Robots.txt dotyczy crawlowania, a zgodne crawlery mogą zdecydować o stosowaniu się do niego. IETF Robots Exclusion Protocol mówi, że nie jest to mechanizm autoryzacji.
Użyj reguły Disallow, aby zarządzać dostępem crawlera do publicznej ścieżki o niskiej wartości, np. kontrolowanej trasy wewnętrznej wyszukiwarki. Użyj noindex dla publicznej treści, która nie powinna pojawiać się w obsługiwanych wynikach wyszukiwania. Dla podglądów, obszarów wymagających logowania, eksportów albo danych wrażliwych stosuj realne mechanizmy dostępu na poziomie serwera lub aplikacji. Dla informacji klientów, pracowników, płatności lub regulowanych danych uzyskaj kwalifikowany przegląd bezpieczeństwa i platformy; robots.txt nigdy nie jest środkiem kompensacyjnym.
Robots.txt może zażądać, aby zgodne crawlery unikały zdefiniowanej publicznej ścieżki; nie gwarantuje to usunięcia z wyników.
Użyj noindex w HTML lub nagłówku X-Robots-Tag i pozostaw odpowiedź możliwą do pobrania, aby instrukcja mogła być odczytana.
Wymagaj uwierzytelnienia lub odpowiedniej kontroli aplikacyjnej/serwerowej, a następnie usuń URL z publicznych ścieżek odkrywania.
Stosuj podstawową składnię i zakres precyzyjnie
Opublikuj tekstowy plik robots.txt w kodowaniu UTF-8 pod /robots.txt dla każdego schematu (scheme), hosta i portu, który potrzebuje reguł. Plik pod https://www.example.com/robots.txt nie rządzi automatycznie https://example.com, subdomeną ani originem HTTP. Zweryfikuj originy używane przez kanoniczne URL-e, przekierowania, CDN i aplikację, zanim założysz, że reguła ma zastosowanie.
Grupa zaczyna się od User-agent, a następnie stosuje ścieżki Allow lub Disallow. User-agent: * to grupa ogólna. Dopasowanie jest rozróżniające wielkość liter i zaczyna się od początku ścieżki. Wygrywa najbardziej szczegółowa pasująca reguła; równie szczegółowe Allow powinno mieć pierwszeństwo nad Disallow. Disallow: (pusta) blokuje nic, natomiast Disallow: / blokuje cały origin. Standard definiuje # jako komentarz, * jako wildcard i $ jako koniec wzorca.
Jeśli nie ma udokumentowanej potrzeby zarządzania crawlingiem, nie dodawaj wykluczeń; nie twórz spekulacyjnych blokad.
Preferuj stabilny, wąski prefiks taki jak /search/ zamiast luźnego wildcarda lub nieuzasadnionej reguły odnoszącej się do nazwy pliku.
Zapisz cel reguły, właściciela i odniesienie do zmiany, ale nie traktuj komentarzy jako substytutu przeglądu.
Blokuj tylko wzorce poparte dowodami URL
Zanim napiszesz regułę, zinwentaryzuj ważne strony, niechciane ścieżki crawl, warianty zapytań, on-site search, trasy podglądu, zasoby i URL-e mapy witryny. Dla każdego przykładowego URL-a zanotuj oczekiwany wynik i pasującą regułę. Porównaj listę z kanonicznymi URL-ami i nawigacją na żywo, aby blokada nie ukryła użytecznej ścieżki.
Pozostaw zasoby krytyczne dla przeglądarki dostępne, chyba że przetestowano inaczej. Google ostrzega, że blokowanie CSS, JavaScriptu, obrazów lub innych zasobów może utrudnić analizę strony. Robots.txt nie rozwiązuje wyboru duplikatów, autoryzacji ani jakości strony; tam, gdzie to stosowne, użyj kanonikalizacji, przekierowań, kontroli dostępu lub pracy nad treścią.
Użyj rzeczywistych przykładów URL i dowodów z serwera lub crawlów, nie ogólnej listy skopiowanej z innej witryny.
Przechowuj każdy przykładowy URL, zamierzony wynik, dopasowaną regułę i odpowiedzialnego właściciela w rejestrze wydania.
Utrzymaj spójność sitemap, noindex i decyzji prywatności
Mapa witryny informuje wyszukiwarki, które URL-e i pliki uznajesz za ważne; może pomagać w odkrywaniu, ale nie gwarantuje crawlowania ani indeksowania. Silne wewnętrzne linkowanie nadal ma znaczenie. Możesz dodać w pełni kwalifikowany URL Sitemap w robots.txt, ale nie umieszczaj tam URL-i prywatnych, przekierowanych, zablokowanych przez robots ani celowo oznaczonych jako noindex. Pogódź output mapy witryny z regułami robots przy wydaniu.
Noindex nie jest dyrektywą robots.txt specyficzną dla Google. Google obsługuje ją w meta tagu HTML lub nagłówku HTTP X-Robots-Tag i musi pobrać odpowiedź, aby ją zobaczyć. Jeśli publiczna strona ma zostać usunięta z wyników Google, usuń wszelkie blokady robots, które ukrywają noindex. Jeśli treść jest niepubliczna, nie reklamuj jej ścieżki w robots.txt; egzekwuj kontrolę dostępu. Granice danych wrażliwych wymagają kwalifikowanego przeglądu.
Użyj pełnego URL, na przykład Sitemap: https://www.example.com/sitemap.xml; nie zastępuje to blokady crawlowania.
Dla HTML użyj meta noindex lub nagłówka X-Robots-Tag: noindex w odpowiedzi, a następnie przetestuj odpowiedź na żywo.
Najpierw ogranicz dostęp, gdy treść jest wrażliwa, potem skorzystaj z procesu usuwania wyszukiwarki, jeśli to odpowiednie.
Testuj i publikuj to jak krytyczny plik konfiguracyjny
Zwaliduj zatwierdzony tekst lokalnie, a następnie przetestuj dopuszczalne i zablokowane przykłady dla zamierzonej grupy crawlerów. Po wdrożeniu pobierz publiczne /robots.txt prywatnie lub przez bezpośrednie żądanie HTTP, aby potwierdzić zawartość, origin i status odpowiedzi. Google oferuje w Search Console raport robots.txt dla dostępnych plików i bibliotekę parsera open-source do testów lokalnych.
Crawlery mogą cache’ować pliki robots, więc nie oczekuj natychmiastowych zmian w odkrywaniu czy indeksowaniu. Błędy serwera powodują, że crawlery zakładają pełne zablokowanie, podczas gdy 4xx może pozwolić na dostęp. Trzymaj plik w kontroli źródła, wymagaj dodatkowego przeglądu dla blokad całej witryny lub wildcardów i zachowaj poprzednią wersję. SIU preflight i planowanie rollbacku pomagają wykryć złe wydanie zanim stanie się większym problemem dostępności lub odkrywalności.
Wymagaj drugiego recenzenta dla migracji originów, blokad całej witryny, wildcardów oraz zmian wpływających na logowanie, checkout lub trasy wsparcia.
Przywróć poprzednią wersję, gdy ważny przykładowy URL zostanie nowo zablokowany, niezbędny zasób stanie się niedostępny lub endpoint jest nieosiągalny.
Jedno testowanie crawlera nie udowadnia, że każdy zautomatyzowany klient zinterpretuje każdą regułę tak samo.