
STATUS IS UPWEBSITE‑OPTIMIERUNGS‑WIKI
29Absichern
SEO und Auffindbarkeit / Absichern

Technisches SEO-Audit: Ein praktischer Leitfaden für Website-Verantwortliche

Ein praxisorientiertes, evidenzbasiertes Audit zum Aufspüren technischer Barrieren für die Auffindbarkeit und zur Verringerung der Wahrscheinlichkeit, dass sie zurückkehren.

Technisches SEO-Audit: Ein praktischer Leitfaden für Website-Verantwortliche — VISUELLE ANLEITUNG
LESEN
8 Minuten
QUELLEN
6
ERNEUT PRÜFEN
2027-03-27
geprüft
Technical SEO and web platform reviewer
DIE KURZE ANTWORT

Mit der Entscheidung beginnen.

Führe ein technisches SEO-Audit als kurzen Evidenzzyklus durch: bestimme, welche öffentlichen Seiten gefunden werden sollen, teste deren Antwort und finale URL, prüfe Indexkontrollen und kanonische Signale, vergleiche Quell- mit gerendertem Inhalt und stimme dann Links und Sitemaps ab. Behebe zuerst das Muster mit der größten Wirkung und teste nach der Freigabe erneut.

Setze Blocker vor Scorecards. Ein unbeabsichtigtes noindex, Serverfehler, fehlerhafte Weiterleitung, widersprüchliche Canonical-Angabe oder fehlender gerenderter Inhalt kann verhindern, dass eine wertvolle Seite für das Indexieren in Betracht gezogen wird. Eine 200-Antwort ist nur eine Möglichkeit zur Verarbeitung, keine Garantie für Indexierung oder Rankings.

Halte das Ergebnis operational: betroffenes Muster, erwartetes Verhalten, Beweis, Verantwortlicher, Rollout-Plan und Rücksetzweg. Status Is UP unterstützt proaktive Uptime-Optimierung und Behebung, damit wichtige Seiten zuverlässig erreichbar und vollständig bleiben; es ist kein Live-Status-Monitoring und keine Zusage zu Suchmaschinen-Ergebnissen.

VISUELLE ANLEITUNG

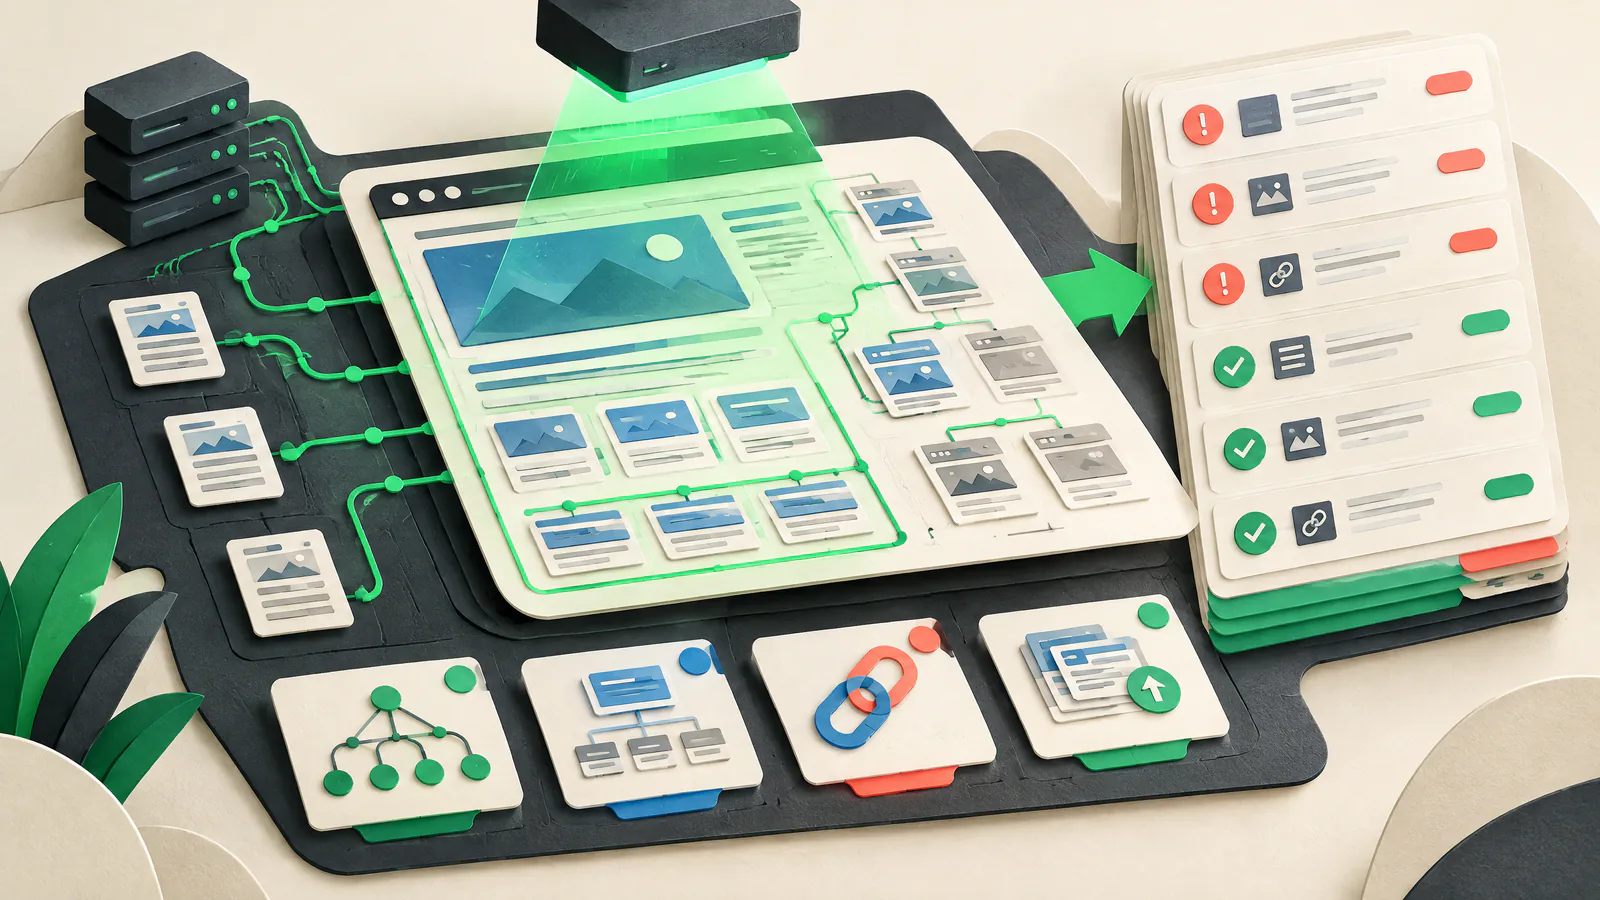
Verstehen Sie die Arbeit als zusammenhängendes System.

Nutzen Sie diese Karte, um die Entscheidungen des Artikels zu verbinden, bevor Sie einzelne Taktiken umsetzen.

SIUAbsichern
01Beginne mit den beabsichtigten Seiten und wiederverwendbaren Nachweisen
02Treffe Indexierbarkeitsentscheidungen bewusst
03Mache eine bevorzugte URL konsistent
04Prüfe Statuscodes und Weiterleitungsverhalten
01

Beginne mit den beabsichtigten Seiten und wiederverwendbaren Nachweisen

Liste die öffentlichen Seiten auf, die du für Suchende auffindbar machen möchtest: wichtige Produkte, Artikel, Kategorien und verschobene URLs. Notiere für jede die bevorzugte URL, erwartete Antwort, Indexierbarkeit, Template, Verantwortlichen und Priorität. Halte legitime Ausschlüsse separat.

Erfasse eine nicht-authentifizierte Antwort, Header, Weiterleitungspfad, Seitenquelle, gerenderte Ansicht, internen Link-Status und Sitemap-Status für repräsentative URLs. Sample jedes Template und jedes URL-Muster. Nachweise sind datiert: Eine CDN-Einstellung, ein Deployment, eine Consent-Schicht oder Personalisierung kann sie später ändern.

Teste Muster

Eine erfolgreiche Homepage beweist nicht, dass Listings, Produktvarianten oder lokalisierte Routen funktionieren.

Speichere eine Basislinie

Bewahre datierte Header und gerenderte Nachweise, damit Fixes und spätere Regressionen verglichen werden können.

02

Treffe Indexierbarkeitsentscheidungen bewusst

Indexierbarkeit bedeutet, dass eine Seite in einen Suchindex aufgenommen werden kann; es ist nicht dasselbe wie Crawling oder Ranking. Prüfe Meta-Robots-Direktiven im HTML und den X-Robots-Tag in den HTTP-Response-Headern. Die Direktive noindex sagt Suchmaschinen, eine Seite nicht anzuzeigen; X-Robots-Tag gilt auch für Nicht-HTML-Dateien wie PDFs.

Prüfe robots.txt separat. Ein Crawler muss auf eine Seite zugreifen, um ihre noindex-Direktive zu finden, daher kann das Blockieren dieser URL verhindern, dass die Direktive gesehen wird. Prüfe die bereitgestellte, öffentliche Antwort, denn CMS-Einstellungen und Umgebungsflags können Regeln hinzufügen. Noindex ist keine Zugriffskontrolle: Schütze sensible Inhalte mit Authentifizierung und einer entsprechenden Sicherheitsprüfung.

Finde unbeabsichtigte Ausschlüsse

Markiere noindex, Login-Antworten, Staging-Referenzen und blockierte essentielle Assets auf Seiten, die indexierbar sein sollen.

Prüfe auch Header

Ein HTTP-Response-Header kann eine Direktive tragen, selbst wenn kein HTML-Head vorhanden ist.

03

Mache eine bevorzugte URL konsistent

Canonicalization identifiziert die bevorzugte URL unter doppelten oder sehr ähnlichen Versionen, z. B. HTTP und HTTPS, Hosts, Tracking-Parameter, Filter oder Druckseiten. Vergleiche das rel=canonical-Element, interne Links, die Sitemap-URL und das Weiterleitungsziel. Für eine indexierbare Seite sollten sie normalerweise dieselbe absolute bevorzugte URL nennen.

Verwende eine permanente serverseitige Weiterleitung beim Zurückziehen eines Duplikats. Google beschreibt permanente Redirects und rel=canonical als starke Signale, während die Aufnahme in die Sitemap ein schwächeres Signal ist; übereinstimmende Signale verstärken die Präferenz. Verwende robots.txt nicht zur Kanonisierung und vermeide konkurrierende Canonicals. Ein selbstreferenzierendes rel=canonical hilft, die bevorzugte Version zu benennen, aber die Auswahl durch Suchmaschinen liegt außerhalb deiner Kontrolle.

Kartiere jede Familie

Dokumentiere Varianten, das bevorzugte Ziel, die erforderliche Steuerung und einen Verantwortlichen.

Schütze Änderungen

Teste Alt-zu-Neu-Zuordnungen vor einer Migration und halte eine umkehrbare Redirect-Änderung bereit.

04

Prüfe Statuscodes und Weiterleitungsverhalten

Statuscodes sagen Browsern und Crawlern, was passiert ist. Wichtige Live-Seiten sollten eine aussagekräftige 2xx-Antwort mit beabsichtigtem Inhalt zurückgeben. Eine Seite ohne relevanten Ersatz sollte eine echte 404- oder 410-Antwort liefern; verschobene Inhalte sollten ihren nächstgelegenen relevanten Ersatz erreichen. Eine 200-Seite, die nur einen Fehler anzeigt, kann als Soft-404 behandelt werden.

Erfasse jeden Weiterleitungshop. Google folgt im Allgemeinen bis zu 10 Hops beim generellen Web-Crawling, aber Ketten erhöhen Latenz und Fragilität. Google sagt, dass 5xx- und 429-Antworten das Crawling vorübergehend verlangsamen können und anhaltende Serverfehler schließlich indexierte URLs entfernen können. Untersuche wiederkehrende Fehler mit dem technischen Eigentümer über Anwendungs-, CDN-, Origin-, Cache-, Dependency- und Deployment-Schichten hinweg.

Klassifiziere Ergebnisse

Speichere Original-URL, Hops, Codes, finale URL und erwarteten Zustand.

Behebe die Regelmenge

Entferne überlappende CMS-, CDN-, Host-, Locale- oder Slash-Regeln, statt einen weiteren Hop hinzuzufügen.

05

Validiere JavaScript-Rendering und Routen

Untersuche sowohl das initiale HTML als auch eine gerenderte Ansicht für wichtige Templates. Bestätige, dass Hauptinhalt, Überschriften, Links, Canonical, Robots-Direktiven und Zustand nach dem Rendering vorhanden sind. Google beschreibt separate Crawl-, Render- und Index-Phasen und sagt, dass Inhalt, der im gerenderten HTML nicht sichtbar ist, nicht indexiert werden kann.

Verwende Anker-Elemente mit href-Werten für die Navigation. Nur-Fragment-Routen, die distincten Inhalt laden, sind für die Auffindbarkeit nicht zuverlässig. Requeste direkt nicht existierende Produkte, Artikel und gefilterte URLs. Client-seitige Anwendungen brauchen einen echten Fehlerzustand; Google dokumentiert Routing zu einem Server-404 oder das Hinzufügen von noindex, um Soft-404s zu vermeiden. Server-Side-Rendering oder Prerendering kann helfen, aber verifiziere die bereitgestellte Antwort.

Vergleiche drei Ansichten

Prüfe Response-HTML, gerendertes HTML und die menschliche Browser-Ansicht auf wesentliche Unterschiede.

Halte das Canonical stabil

Bevorzuge das Quell-HTML; wenn JavaScript es setzt, stelle sicher, dass es ein nicht-konfligierendes Canonical gibt.

06

Halte Sitemaps und interne Links sauber

Eine Sitemap ist eine Entdeckungslandkarte, kein Indexierkommando. Nimm erfolgreiche, beabsichtigte, bevorzugte Canonical-URLs auf; schließe Weiterleitungen, Fehler, noindex-Seiten, Parameterduplikate und geschützte URLs aus. Google empfiehlt vollständig qualifizierte absolute URLs und betrachtet die Aufnahme in eine Sitemap als Canonical-Hinweis, nicht als Garantie.

Validiere die Sitemap und vergleiche sie mit der Liste der beabsichtigten Index-URLs und der Navigation. Google dokumentiert UTF-8-Kodierung und ein Limit von 50 MB unkomprimiert oder 50.000 URLs pro Sitemap. Für größere Sites in sinnvolle Gruppen aufteilen und einen Index verwenden. Aktualisiere lastmod nur bei signifikanten, verifizierbaren Seitenänderungen.

Versöhne Listen

Untersuche bedeutende Unterschiede zwischen beabsichtigten URLs, Sitemap-Einträgen und internen Links.

Erneut anfordern nach Release

Prüfe die generierte Sitemap und eine Stichprobe der gelisteten URLs nach Routing- oder CMS-Änderungen.

07

Messe Leistung und institutionalisiere das Audit

Nutze Felddaten, wo verfügbar, und kontrollierte Labortests, um Core Web Vitals zu untersuchen: Largest Contentful Paint (LCP) für das Laden, Interaction to Next Paint (INP) für Reaktionsfähigkeit und Cumulative Layout Shift (CLS) für visuelle Stabilität. Segmentiere nach Seitentyp und Gerät, da Mittelwerte ein kaputtes hochprioritäres Template verschleiern können.

Verfolge langsame oder instabile Auslieferung über Bilder, CSS und JavaScript, Drittanbieter-Tags, Fonts, Einbettungen und Caching. Mache eine gemessene Änderung und prüfe dann Rendering und Nutzerflüsse erneut. Felddaten spiegeln echte Nutzer wider; Labordaten helfen bei der Reproduzierbarkeit. Keines von beiden sagt etwas über jeden zukünftigen Crawler oder Besucher aus. Wiederhole einen fokussierten Regressionscheck nach riskanten Releases und ein vollständigeres Audit nach Migrationen oder Plattformwechseln.

Priorisiere Exposure

Behebe Fehler in umsatzkritischen oder stark genutzten Templates, bevor du an kleinen Score-Gewinnen anderswo arbeitest.

Schließe mit Nachweis

Prüfe vor dem Schließen Antwort, Canonical, gerenderten Inhalt, Sitemap-Zustand und relevante Performance-Nachweise erneut.

AKTION / ÜBERPRÜFEN

Ihr praktischer To‑Do‑Leitfaden.

  1. 01

    Lege die Intended-Index-Inventarliste fest

    Liste wichtige öffentliche URLs nach Template mit erwartetem Canonical, Indexierbarkeit, Priorität und Verantwortlichem.

    ÜBERPRÜFEN: Jedes größere Template hat einen beprobten, dokumentierten erwarteten Zustand.
  2. 02

    Erfasse öffentliche Antworten

    Erfasse Status, Header, Weiterleitungs-Hops, finale URL und Content-Type ohne angemeldete Sitzung.

    ÜBERPRÜFEN: Keine beprobte wichtige URL hat eine unerklärte Kette oder einen Serverfehler.
  3. 03

    Prüfe Indexsteuerungen

    Prüfe robots-Meta, X-Robots-Tag und die Zugänglichkeit von robots.txt.

    ÜBERPRÜFEN: Beabsichtigte Indexseiten haben keine unbeabsichtigte Ausschlüsse und sensible Seiten nutzen Zugangskontrollen.
  4. 04

    Versöhne Canonical-Signale

    Vergleiche Canonical-Tags, Redirects, interne Links, Sitemaps, Host- und HTTPS-Entscheidungen.

    ÜBERPRÜFEN: Jede Duplikat-Familie hat eine dokumentierte bevorzugte URL oder eine schriftliche Ausnahme.
  5. 05

    Teste Ausfälle und Verschiebungen

    Requeste alte, nicht existierende, HTTP-, alternativer-Host- und entfernte Content-URLs.

    ÜBERPRÜFEN: Verschiebungen sind direkt und relevant; fehlender Inhalt liefert keine 200-Fehlerhülle.
  6. 06

    Untersuche Rendering

    Vergleiche Quell- und gerendertes Output für Text, Links, Metadaten und Fehler-Routen.

    ÜBERPRÜFEN: Essentieller Inhalt und crawlbare Links sind nach dem Rendering sichtbar.
  7. 07

    Validiere Sitemap und Links

    Vergleiche Sitemap, Intended-Index-Liste und interne Navigation.

    ÜBERPRÜFEN: Nur erfolgreiche, bevorzugte URLs, die für die Entdeckung vorgesehen sind, sind gelistet.
  8. 08

    Messe nach Seitentyp

    Überprüfe Feld- und Labor-Performance-Nachweise, einschließlich Abhängigkeiten und Assets.

    ÜBERPRÜFEN: Jeder Performance-Fix benennt betroffenen Template, Nachweis und Regressionschecks.
  9. 09

    Sichere Freigabe und Retest

    Veröffentliche gruppierte Fixes mit Rollback-Plan und wiederhole dann die betroffenen Prüfungen.

    ÜBERPRÜFEN: Abgeschlossene hochprioritäre Arbeiten haben Vorher-Nachher-Nachweise.
DISKUSSIONSTHEMEN

Vergleichen Sie Kompromisse, nicht private Daten.

Nutzen Sie diese Fragen mit Ihrem Team oder der Website‑Betreiber‑Community. Teilen Sie Methoden und Erkenntnisse, aber fügen Sie niemals Zugangsdaten, Kundendaten oder nicht‑öffentliche Infrastrukturdaten ein.

  1. 01

    Welches URL-Muster hat bei euch das weitreichendste technisches Auffindbarkeitsproblem verursacht und welcher Nachweis hat die gemeinsame Ursache offenbart?

  2. 02

    Woran entscheidet ihr, ob ein Duplikat weiterleiten, ein Canonical deklarieren, zugänglich bleiben oder ausgeschlossen werden soll?

  3. 03

    Welcher Release-Check fängt Rendering-, Sitemap- oder Antwort-Regressionen am besten ab, bevor sie wichtige Seiten erreichen?

BELIEBTE / MASSGEBLICHE RESSOURCEN

Öffnen Sie das Quellmaterial.

Google Search CentralHow to specify a canonical URL with rel=canonical and other methods ↗

Canonical-Signale, Redirects, selbstreferenzierende Canonicals und Konflikte, die vermieden werden sollten.

Geprüft 2026-09-27
Google Search CentralUnderstand the JavaScript SEO basics ↗

Crawl, Render, Routen, Canonical-Injektion und Soft-404-Anleitungen für JavaScript-Anwendungen.

Geprüft 2026-09-27
Google for DevelopersHow HTTP status codes affect Google’s crawlers ↗

Eine Referenz für 2xx-, Redirect-, 4xx-, 429- und 5xx-Verarbeitung durch Crawler.

Geprüft 2026-09-27
Google Search CentralBuild and submit a sitemap ↗

Sitemap-URL-Auswahl, Limits, lastmod und Hinweise zur Einreichung.

Geprüft 2026-09-27
Google Search CentralRobots meta tag, data-nosnippet, and X-Robots-Tag specifications ↗

Index-Direktiven, Header für Nicht-HTML-Dateien und Crawling vs. noindex.

Geprüft 2026-09-27
web.devLearn Core Web Vitals ↗

Ressourcen zu Kernerlebnismetriken (Core Web Vitals).

Geprüft 2026-09-27

Quellenrichtlinie. Basierend auf offiziellen Google Search Central-, Google for Developers- und web.dev-Seiten, gelesen am Zugriffsdatum. Dokumentiertes Crawler-Verhalten ist von praktischen Empfehlungen unterschieden; Indexierung und Rankings werden nicht versprochen.

KURZE KLARSTELLUNGEN

Häufige Fragen.

Wie häufig sollte ich ein technisches SEO-Audit durchführen?

Führe fokussierte Regressionschecks nach Änderungen an Templates, Routing, CMS, CDN, Tags oder Abhängigkeiten durch. Mache ein vollständigeres Audit nach Migrationen, Redesigns, Plattformwechseln oder größeren URL-Arbeiten. Passe die Häufigkeit dem Änderungsrisiko und der geschäftlichen Wichtigkeit an.

Bedeutet ein 200-Statuscode, dass eine Seite ranken oder indexiert wird?

Nein. Eine 200-Antwort ermöglicht die Verarbeitung, garantiert jedoch nicht Indexierung oder Rankings. Indexsteuerungen, Canonical-Konsistenz, zugänglicher nützlicher Inhalt und die Bewertung durch Suchmaschinen sind weiterhin entscheidend.

Sollte ich doppelte Seiten in robots.txt blockieren?

In der Regel nein. robots.txt ist keine Kanonisierung, und Blockieren kann verhindern, dass ein noindex gesehen wird. Stimme stattdessen die bevorzugte URL, Redirects, Canonical-Signal, interne Links und Sitemap ab; verwende Zugriffskontrollen für sensible Inhalte.

Status Is UP Editorial Team · Uptime Enablement Editors

Geprüft von Technical SEO and web platform reviewer. Veröffentlicht 2026-09-27; aktualisiert 2026-09-30.