
STATUS IS UPウェブサイト最適化ウィキ
29堅牢化
SEOと発見性 / 堅牢化

テクニカルSEO監査:実務オーナー向けの実践ガイド

検索での発見を妨げる技術的障壁を見つけ、再発の可能性を減らすための実証的で実務的な監査。

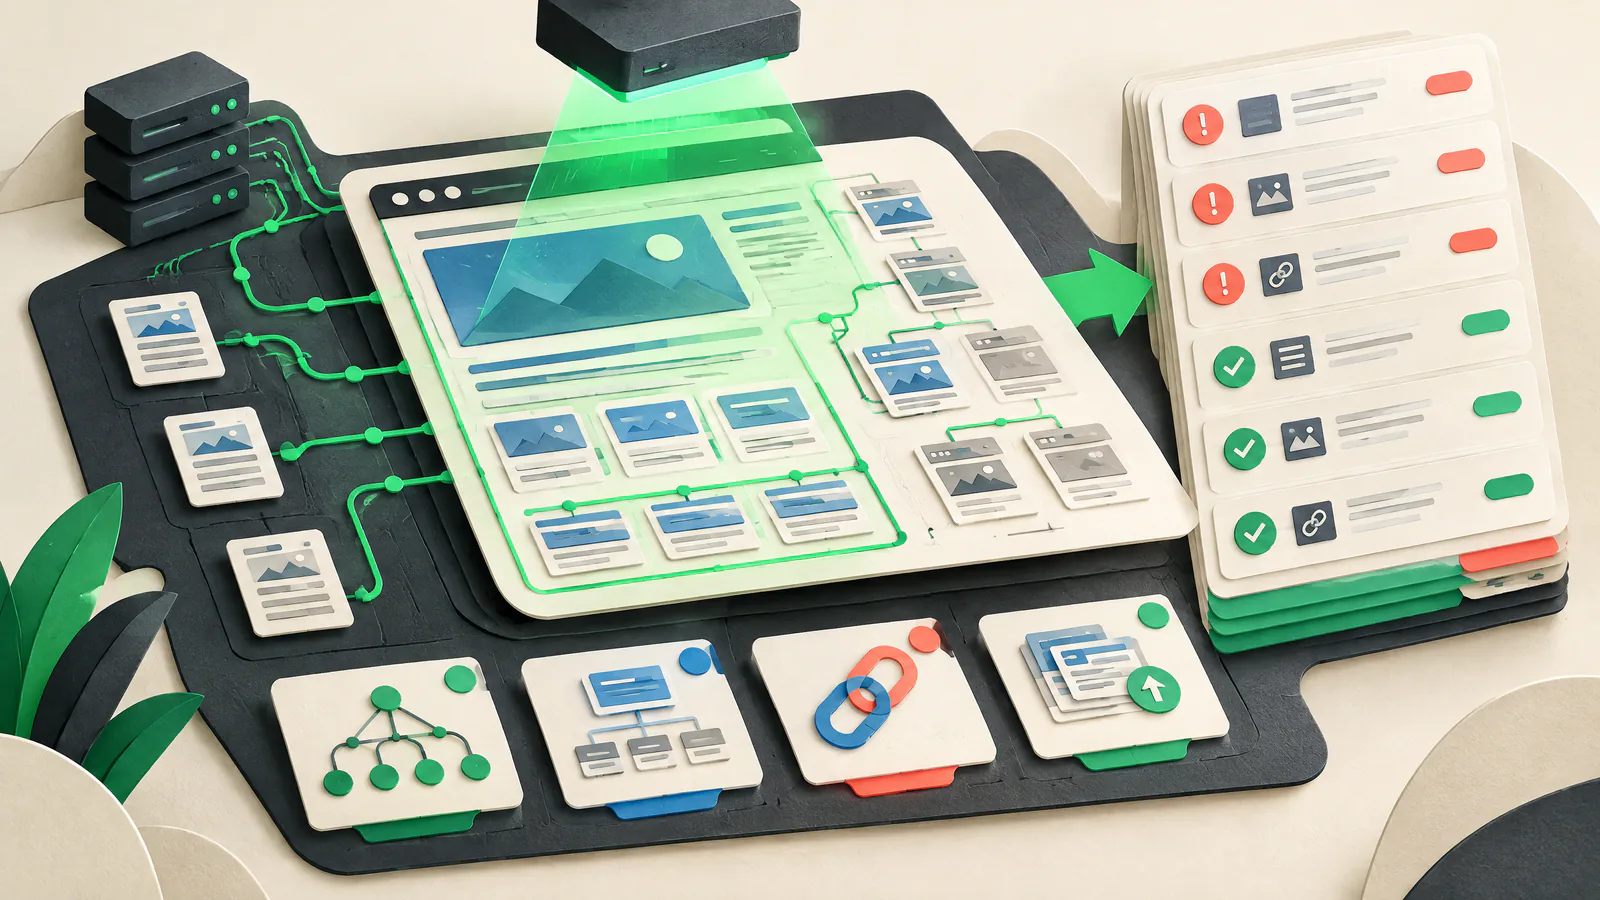
テクニカルSEO監査:実務オーナー向けの実践ガイド — ビジュアルガイド
読む
8 分
出典
6
再検証
2027-03-27
レビュー済み
テクニカルSEOとウェブプラットフォームのレビュアー
短い答え

まず決断から始める。

テクニカルSEO監査は短いエビデンスのループで実施する:公開すべきページを決め、応答と最終URLをテストし、インデックス制御やカノニカル信号を確認し、ソースとレンダリング後のコンテンツを比較し、リンクとサイトマップを照合する。最も影響の大きいパターンを優先して修正し、公開後に再テストする。

スコアカードより阻害要因を優先する。意図しない noindex、サーバーエラー、誤ったリダイレクト、競合する canonical、あるいはレンダリング後にコンテンツが欠落していることは、価値あるページがインデックス対象にならない理由になり得る。200 応答は処理の機会を与えるだけで、インデックスやランキングを保証するものではない。

成果物は運用可能な形に保つ:影響を受けるパターン、期待される挙動、証拠、オーナー、展開計画、ロールバック経路を明記する。Status Is UP は重要ページが確実に到達可能で完全であり続けるよう、プロアクティブな稼働率最適化と修復を支援するものであり、ライブ監視や検索エンジンの結果に関する保証ではない。

ビジュアルガイド

作業をシステムとして見る。

個別の戦術に取り掛かる前に、この記事の意思決定をこのマップで結び付けてください。

SIU堅牢化
01意図するページと再利用可能な証拠から始める
02インデックス可能性を意図的な決定にする
031つの優先URLを一貫させる
04ステータスコードとリダイレクト挙動を確認する
01

意図するページと再利用可能な証拠から始める

検索者に見つけてほしい公開ページを一覧にする:主要な製品、記事、カテゴリ、移行したURLなど。各ページについて、優先URL、期待応答、インデックス可能性、テンプレート、オーナー、優先度を記録する。正当な除外は別に管理する。

代表的なURLについては、未認証の応答、ヘッダ、リダイレクト経路、ページソース、レンダリング後のビュー、内部リンクの状態、サイトマップの状態を取得する。すべてのテンプレートとURLパターンをサンプリングする。証拠には日付を付ける:CDNの設定、デプロイ、同意レイヤー、パーソナライゼーションで後から変わる可能性がある。

パターンをテストする

ホームページが通れば済むとは限らない。リスティング、製品バリアント、ローカライズされたルートが機能しているかを確認する必要がある。

ベースラインを保存する

修正や後の回帰と比較できるように、日付入りのヘッダとレンダリング証拠を保管する。

02

インデックス可能性を意図的な決定にする

インデックス可能性とは、ページが検索インデックスに含まれる可能性があることを指し、クロールやランキングとは同義ではない。HTML内のmeta robots 指令と、HTTP応答ヘッダの X-Robots-Tag を確認する。noindex 指令は検索エンジンにページを表示しないよう伝えるもので、X-Robots-Tag は PDF など非HTMLファイルにも適用される。

robots.txt は別に確認する。クローラは noindex 指令を見るためにページにアクセスする必要があるため、そのURLをブロックすると指令が見えなくなる可能性がある。デプロイされた公開応答を確認すること:CMS 設定や環境フラグがルールを追加することがある。noindex はアクセス制御ではない:機密資料は認証と適切なセキュリティレビューで保護する。

偶発的な除外を見つける

意図したインデックス対象ページで noindex、ログイン応答、ステージング参照、重要なアセットのブロックをフラグする。

ヘッダも確認する

HTML head が存在しない場合でも、HTTP 応答ヘッダが指令を含むことがある。

03

1つの優先URLを一貫させる

カノニカリゼーションは、HTTP と HTTPS、ホスト、追跡パラメータ、フィルタ、印刷用ページなどの重複または類似バージョンの中で優先URLを特定することを意味する。canonical 要素、内部リンク、サイトマップのURL、リダイレクト先を比較する。インデックス可能なページでは、通常それらは同じ絶対的な優先URLを指しているべきである。

重複を廃止する際はサーバー側の恒久的リダイレクトを使用する。Google は恒久的リダイレクトと rel=canonical を強いシグナルとして説明しており、サイトマップの包含は弱いヒントである。信号を整合させることで優先度が強化される。robots.txt を使ってカノニカル化したり、1つのページに対して競合するカノニカルを与えないこと。自己参照の canonical は優先バージョンを示すのに有用だが、検索エンジンの選択は制御外である。

各ファミリーをマップする

バリアント、優先ターゲット、必要な制御、およびオーナーを文書化する。

変更を保護する

移行前に古いURLから新しいURLへのマッピングをテストし、戻せるリダイレクト変更を用意しておく。

04

ステータスコードとリダイレクト挙動を確認する

ステータスコードはブラウザやクローラに何が起きたかを伝える。重要なライブページは、意図したコンテンツを含む意味のある2xx応答を返すべきである。置換がないページは適切に404や410を返すべきで、移動したコンテンツは最も近い関連する置換先に到達するべきだ。エラーだけを表示する200ページはソフト404として扱われることがある。

すべてのリダイレクトホップを記録する。Google は一般的なウェブクロールで最大10ホップまで辿るとされるが、チェーンは遅延と脆弱性を増す。Google は 5xx と 429 応答がクロールを一時的に遅らせる可能性があり、持続するサーバーエラーは最終的にインデックスされたURLの削除につながり得ると述べている。アプリケーション、CDN、オリジン、キャッシュ、依存関係、デプロイ層にまたがって定期的な失敗をエンジニアリングオーナーと調査する。

結果を分類する

元のURL、ホップ、コード、最終URLと期待状態を保存する。

ルールセットを修正する

別のホップを追加するのではなく、CMS、CDN、ホスト、ロケール、スラッシュの重複ルールを削除する。

05

JavaScript のレンダリングとルートを検証する

主要テンプレートについては初期のHTMLとレンダリング後のビューの両方を検査する。主要コンテンツ、見出し、リンク、canonical、robots 指令、状態がレンダリング後に存在することを確認する。Google はクロール、レンダリング、インデックスのフェーズが分かれていると説明し、レンダリング後のHTMLに見えないコンテンツはインデックスされ得ないと述べている。

ナビゲーションには href 属性を持つアンカー要素を使用する。フラグメントのみのルートで異なるコンテンツを読み込む方法は発見性が安定しない。存在しない製品、記事、フィルタ済みURLを直接リクエストしてみる。クライアントサイドアプリケーションは実際のエラー状態を持つ必要がある:Google はサーバー404にルーティングするか noindex を追加してソフト404を避けることを文書化している。サーバーサイドレンダリングやプリレンダリングが助けになる場合があるが、デプロイされた応答を検証すること。

三つのビューを比較する

レスポンスHTML、レンダリング後のHTML、人間のブラウザ表示で重要な差異がないか確認する。

カノニカルを安定させる

ソースHTMLを優先する。もし JavaScript が設定する場合は、競合しない単一の canonical を確保する。

06

サイトマップと内部リンクをクリーンに保つ

サイトマップは発見の地図であり、インデックスの命令ではない。成功している意図された優先カノニカルURLを含め、リダイレクト、エラー、noindex ページ、パラメータ重複、保護されたURLは除外する。Google は完全修飾の絶対URLを推奨し、サイトマップの包含はカノニカルのヒントと扱われる。

サイトマップを検証し、意図したインデックスリストやナビゲーションと比較する。Google は UTF-8 エンコーディングと、サイトマップは未圧縮で50MBまたは50,000URLの制限があることを文書化している。大規模サイトでは有用なグループに分割し、インデックスファイルを使う。lastmod は重大で検証可能なページ変更のときのみ更新する。

リストを照合する

意図したURL、サイトマップの項目、内部リンクの間に意味のある差があれば調査する。

公開後に再取得する

ルーティングやCMS変更後に生成されたサイトマップと、記載されたURLのサンプルを確認する。

07

パフォーマンスを測定し監査を制度化する

利用可能なフィールドデータと、再現性のあるラボテストを使って Core Web Vitals(コアウェブバイタル)を調査する:読み込みでは Largest Contentful Paint(LCP)、応答性では Interaction to Next Paint(INP)、視覚的安定性では Cumulative Layout Shift(CLS)を測る。平均は壊れた高価値テンプレートを隠すことがあるので、ページタイプ別とデバイス別にセグメント化する。

画像、CSS/JavaScript、サードパーティタグ、フォント、埋め込み、キャッシュなどをたどって遅いまたは不安定な配信を追跡する。1つの測定された変更を行い、レンダリングとユーザーフローを再チェックする。フィールドデータは実ユーザーを反映し、ラボデータは再現に役立つ。どちらも将来のすべてのクローラや訪問者を予測するわけではない。リスクの高いリリース後は重点的な回帰チェックを繰り返し、移行やプラットフォーム変更の後はより完全な監査を行う。

露出を優先する

収益に直結する、または使用頻度の高いテンプレートでの失敗を、他の小さなスコア改善より先に修復する。

証拠で締める

応答、カノニカル、レンダリング後コンテンツ、サイトマップ状態、関連パフォーマンス証拠を閉鎖前に再確認する。

実行 / 検証

実践的なTo‑Doガイド。

  1. 01

    意図するインデックス在庫を設定する

    主要な公開URLをテンプレート別に、期待されるカノニカル、インデックス可能性、優先度、オーナーとともに一覧化する。

    検証: 主要なテンプレートごとにサンプル化された、文書化された期待状態がある。
  2. 02

    公開応答を記録する

    ログイン不要のセッションでステータス、ヘッダ、リダイレクトホップ、最終URL、コンテンツタイプを保存する。

    検証: サンプリングした重要なURLに不明瞭なチェーンやサーバーエラーがない。
  3. 03

    インデックス制御を確認する

    robots meta、X-Robots-Tag、robots.txt の可視性をチェックする。

    検証: 意図したインデックスページに偶発的な除外がなく、機密ページはアクセス制御を使用している。
  4. 04

    カノニカル信号を照合する

    カノニカルタグ、リダイレクト、内部リンク、サイトマップ、ホスト、HTTPS の選択を比較する。

    検証: 重複ファミリーごとに1つの文書化された優先URLか、書面による例外がある。
  5. 05

    失敗と移動を実行検証する

    古いURL、存在しないURL、HTTP、別ホスト、削除コンテンツのURLをリクエストする。

    検証: 移動は直接かつ関連性があり、欠落コンテンツが200のエラーシェルを返さない。
  6. 06

    レンダリングを検査する

    テキスト、リンク、メタデータ、エラールートについてソースとレンダリング出力を比較する。

    検証: 重要なコンテンツとクロール可能なリンクがレンダリング後に表示される。
  7. 07

    サイトマップとリンクを検証する

    サイトマップ、意図するインデックスリスト、内部ナビゲーションを比較する。

    検証: 発見を意図した成功した優先URLのみがリストに含まれている。
  8. 08

    ページタイプ別に測定する

    依存関係やアセットを含むフィールドとラボのパフォーマンス証拠を確認する。

    検証: 各パフォーマンス修正は影響を受けるテンプレート、証拠、回帰チェックを明記している。
  9. 09

    安全にリリースして再テストする

    ロールバック計画とともに修正をグループ化してリリースし、影響のあるチェックを繰り返す。

    検証: クローズされた高優先度作業には前後の証拠がある。
議論のテーマ

トレードオフを比較し、非公開データは共有しないでください。

これらのプロンプトをチームやサイトオーナーコミュニティで使ってください。手法や学びは共有して構いませんが、認証情報や顧客データ、非公開インフラの詳細を貼り付けないでください。

  1. 01

    どのURLパターンが最も広範な技術的発見問題を引き起こし、共有原因を明らかにした証拠は何でしたか?

  2. 02

    重複をリダイレクトすべきか、カノニカルを宣言すべきか、アクセス可能にしておくべきか、除外すべきかはどのように決めますか?

  3. 03

    どのリリースチェックがレンダリング、サイトマップ、または応答の回帰を重要ページに到達する前に最もよく検出しますか?

人気/信頼できる資料

出典資料を開く。

Google Search CentralHow to specify a canonical URL with rel=canonical and other methods ↗

カノニカル信号、リダイレクト、自己参照カノニカル、および避けるべき競合の解説。

レビュー日 2026-09-27
Google Search CentralUnderstand the JavaScript SEO basics ↗

JavaScript アプリケーション向けのクロール、レンダリング、ルート、カノニカル注入、ソフト404 に関するガイダンス。

レビュー日 2026-09-27
Google for DevelopersHow HTTP status codes affect Google’s crawlers ↗

2xx、リダイレクト、4xx、429、5xx のクローラ取り扱いに関するリファレンス。

レビュー日 2026-09-27
Google Search CentralBuild and submit a sitemap ↗

サイトマップのURL選択、制限、lastmod、送信上の注意点。

レビュー日 2026-09-27
Google Search CentralRobots meta tag, data-nosnippet, and X-Robots-Tag specifications ↗

インデックス指令、非HTMLファイル用ヘッダ、およびクロールと noindex の違い。

レビュー日 2026-09-27
web.devLearn Core Web Vitals ↗

コアエクスペリエンス指標(Core Web Vitals)に関する資料。

レビュー日 2026-09-27

出典ポリシー アクセス日に読んだ公式の Google Search Central、Google for Developers、および web.dev のページに基づく。文書化されたクローラの挙動は実務的な推奨と区別しており、インデックスやランキングを保証するものではない。

簡単な補足

よくある質問

テクニカルSEO監査はどのくらいの頻度で実行すべきですか?

テンプレート、ルーティング、CMS、CDN、タグ、依存関係に変更があった後は重点的な回帰チェックを行う。移行、再設計、プラットフォーム変更、大規模なURL作業の後はより完全な監査を実行する。頻度は変更のリスクとビジネス上の重要性に合わせる。

200ステータスコードはページがランク付けされたりインデックスされることを意味しますか?

いいえ。200 応答は処理の機会を与えるが、インデックスやランキングを保証するものではない。インデックス制御、カノニカルの一貫性、アクセス可能な有用コンテンツ、検索エンジンの評価が依然として重要である。

重複ページを robots.txt でブロックすべきですか?

通常は避ける。robots.txt はカノニカリゼーションではなく、ブロックすると noindex 指令が見られなくなる可能性がある。優先URL、リダイレクト、カノニカル信号、内部リンク、サイトマップを整合させ、機密コンテンツにはアクセス制御を使用する。

Status Is UP Editorial Team · Uptime Enablement 編集チーム

レビュー: テクニカルSEOとウェブプラットフォームのレビュアー。公開 2026-09-27、更新 2026-09-30。