
STATUS IS UPWIKI D'OPTIMISATION DE SITE
29Renforcer
SEO et visibilité / Renforcer

Audit SEO technique : guide pratique pour propriétaires

Un audit pratique fondé sur des preuves pour repérer les barrières techniques à la découverte par la recherche et réduire les risques qu’elles réapparaissent.

Audit SEO technique : guide pratique pour propriétaires — GUIDE VISUEL
LIRE
8 minutes
SOURCES
6
RÉVALIDER
2027-03-27
examiné
Relecteur SEO technique et plateforme web
LA RÉPONSE COURTE

Commencez par la décision.

Réalisez un audit SEO technique comme une boucle d’évidence courte : déterminez quelles pages publiques doivent être trouvées, testez leur réponse et URL finale, vérifiez les contrôles d’indexation et les signaux canoniques, comparez la source au rendu, puis réconciliez les liens et les sitemaps. Corrigez d’abord le motif à fort impact, puis retestez après la mise en production.

Priorisez les blocages plutôt que les tableaux de score. Un noindex involontaire, une erreur serveur, une redirection incorrecte, un canonical contradictoire ou du contenu rendu manquant peut empêcher une page précieuse d’être prise en compte pour l’indexation. Un code 200 n’est qu’une opportunité de traitement, pas une garantie d’indexation ou de positionnement.

Maintenez la livraison exploitable : motif affecté, comportement attendu, preuve, propriétaire, plan de déploiement et procédure de retour en arrière. Status Is UP prend en charge l’optimisation proactive de l’uptime et la remédiation pour que les pages importantes restent atteignables et complètes ; ce n’est pas du monitoring en temps réel ni une promesse concernant les résultats des moteurs de recherche.

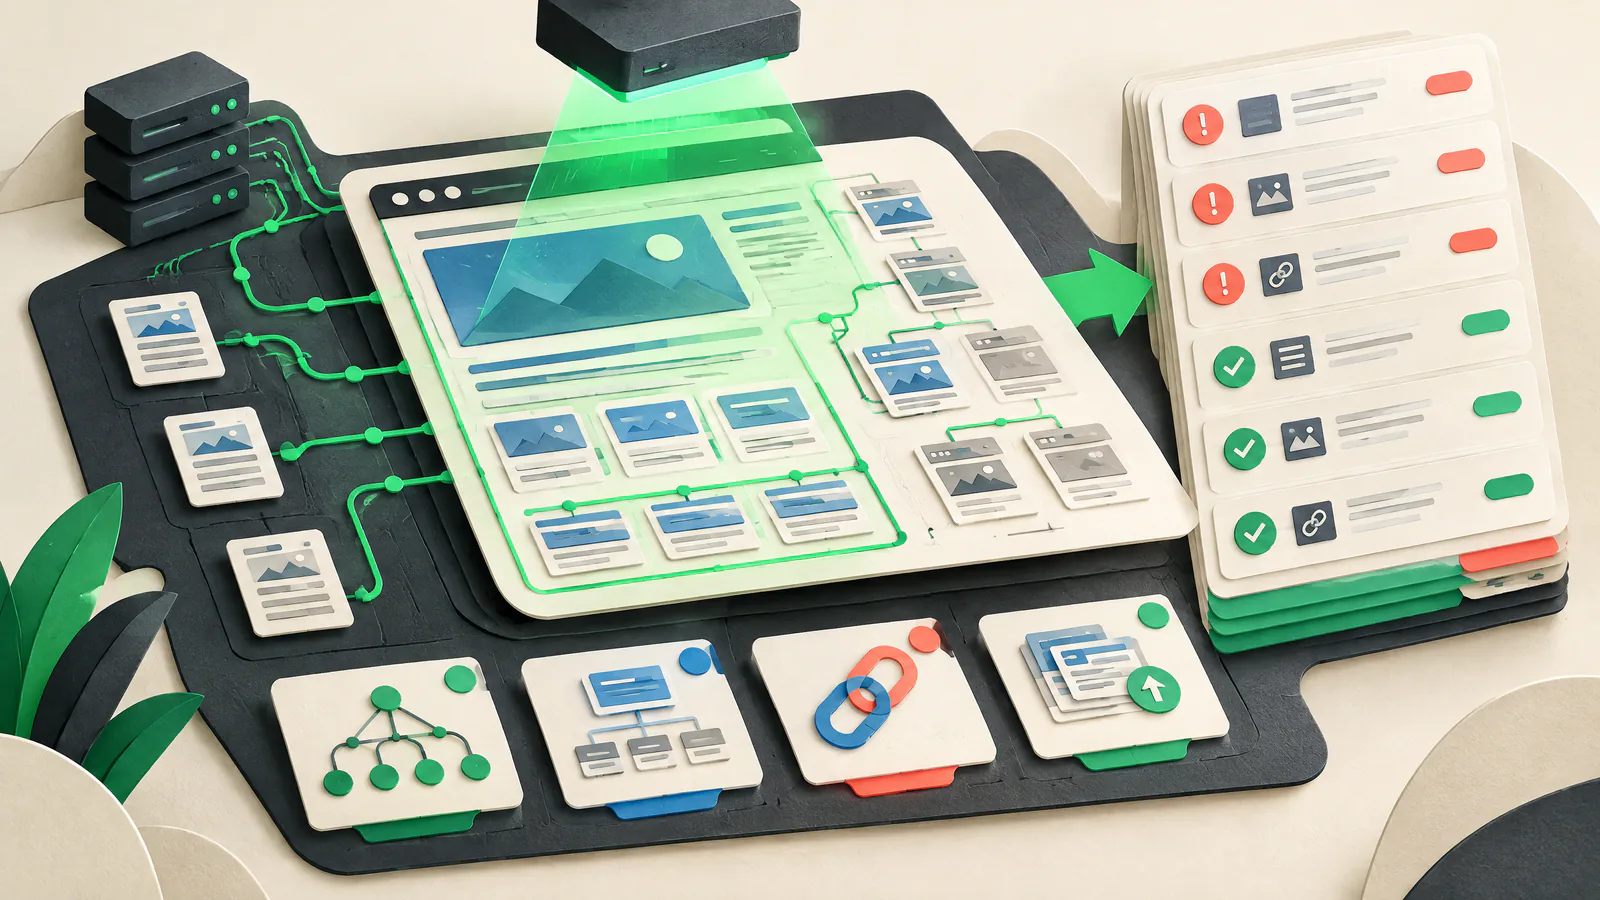
GUIDE VISUEL

Voyez le travail comme un système.

Utilisez cette carte pour relier les décisions de l'article avant d'agir sur des tactiques isolées.

SIURenforcer
01Commencez par les pages prévues et des preuves réutilisables
02Faites de l’indexabilité une décision délibérée
03Choisissez une URL préférée et gardez-la cohérente
04Vérifiez les codes d’état et le comportement des redirections
01

Commencez par les pages prévues et des preuves réutilisables

Dressez la liste des pages publiques que vous voulez voir trouvées par la recherche : produits clés, articles, catégories et URL déplacées. Pour chacune, enregistrez l’URL préférée, la réponse attendue, l’indexabilité, le template, le propriétaire et la priorité. Tenez séparées les exclusions légitimes.

Capturez une réponse non authentifiée, les en-têtes, le chemin de redirection, le code source, la vue rendue, l’état des liens internes et l’état dans le sitemap pour des URL représentatives. Échantillonnez chaque template et chaque motif d’URL. Les preuves sont datées : un réglage CDN, un déploiement, une couche de consentement ou une personnalisation peuvent les modifier plus tard.

Tester les motifs

Une homepage qui passe ne prouve pas que les listings, variantes produit ou routes localisées fonctionnent.

Sauvegarder une base

Conservez des en-têtes et des preuves rendues datés afin de comparer les corrections et les régressions ultérieures.

02

Faites de l’indexabilité une décision délibérée

L’indexabilité signifie qu’une page peut être incluse dans un index de recherche ; ce n’est pas identique au crawl ou au positionnement. Vérifiez les directives meta robots dans le HTML et les en-têtes de réponse X-Robots-Tag. La directive noindex indique aux moteurs de recherche de ne pas afficher une page ; X-Robots-Tag s’applique aussi aux fichiers non-HTML comme les PDF.

Passez en revue le fichier robots.txt séparément. Un crawler doit pouvoir accéder à une page pour voir sa directive noindex ; bloquer cette URL peut empêcher la directive d’être lue. Contrôlez la réponse publique déployée car des paramètres CMS et des flags d’environnement peuvent ajouter des règles. noindex n’est pas un contrôle d’accès : protégez le contenu sensible par authentification et une revue de sécurité appropriée.

Repérer les exclusions accidentelles

Signalez les noindex, réponses de type login, références à des environnements de staging et actifs essentiels bloqués sur des pages destinées à l’indexation.

Vérifier aussi les en-têtes

Un en-tête HTTP peut porter une directive même s’il n’y a pas de head HTML.

03

Choisissez une URL préférée et gardez-la cohérente

La canonicalisation identifie l’URL préférée parmi des versions dupliquées ou très similaires, par exemple HTTP vs HTTPS, hôtes, paramètres de suivi, filtres ou pages d’impression. Comparez la balise canonical, les liens internes, l’URL dans le sitemap et la destination des redirections. Pour une page indexable, ils devraient normalement indiquer la même URL absolue préférée.

Utilisez une redirection permanente côté serveur lorsque vous retirez un doublon. Google décrit les redirections permanentes et rel=canonical comme des signaux forts, tandis que l’inclusion dans le sitemap est plus faible ; des signaux alignés renforcent la préférence. N’utilisez pas robots.txt pour canonicaliser et n’envoyez pas de canonicals concurrents. Un canonical auto-référent aide à indiquer la version préférée, mais la sélection finale par le moteur reste hors de votre contrôle.

Cartographier chaque famille

Documentez les variantes, la cible préférée, le contrôle requis et un propriétaire.

Protéger les changements

Testez les mappings ancien→nouveau avant une migration et conservez une modification de redirection réversible prête.

04

Vérifiez les codes d’état et le comportement des redirections

Les codes d’état indiquent aux navigateurs et aux crawlers ce qui s’est passé. Les pages importantes en production doivent renvoyer une réponse 2xx significative avec le contenu prévu. Une page sans remplacement pertinent doit retourner un 404 ou 410 authentique ; le contenu déplacé doit atteindre son remplacement pertinent le plus proche. Une page 200 qui n’affiche qu’une erreur peut être traitée comme un soft 404.

Enregistrez chaque saut de redirection. Google suit généralement jusqu’à 10 sauts pour le crawling général, mais les chaînes ajoutent latence et fragilité. Google indique que les réponses 5xx et 429 peuvent ralentir temporairement le crawl et que des erreurs serveur persistantes peuvent finalement entraîner la suppression d’URL indexées. Enquêtez sur les échecs récurrents avec le propriétaire technique à travers application, CDN, origin, cache, dépendances et couches de déploiement.

Classer les résultats

Sauvegardez l’URL d’origine, les sauts, les codes, l’URL finale et l’état attendu.

Corriger le jeu de règles

Supprimez les règles CMS, CDN, hôte, locale ou slash qui se chevauchent au lieu d’ajouter un saut.

05

Validez le rendu JavaScript et les routes

Inspectez à la fois le HTML initial et une vue rendue pour les templates clés. Confirmez que le contenu principal, les titres, les liens, le canonical, les directives robots et l’état existent après rendu. Google décrit des phases séparées de crawl, rendu et indexation et indique que le contenu non visible dans le HTML rendu ne peut pas être indexé.

Utilisez des éléments anchor avec attribut href pour la navigation. Les routes uniquement basées sur des fragments qui chargent du contenu distinct ne sont pas fiables pour la découverte. Demandez directement des produits inexistants, des articles supprimés et des URLs filtrées. Les applications côté client ont besoin d’un vrai état d’erreur ; Google documente le routage vers un 404 serveur ou l’ajout d’un noindex pour éviter les soft 404. Le rendu côté serveur ou le prerendering peut aider, mais vérifiez la réponse déployée.

Comparer trois vues

Vérifiez le HTML de réponse, le HTML rendu et la vue humaine du navigateur pour des différences matérielles.

Garder le canonical stable

Privilégiez le HTML source ; si le JavaScript le définit, assurez-vous qu’il n’y a pas de canonical contradictoire.

06

Gardez sitemaps et liens internes propres

Un sitemap est une carte de découverte, pas un ordre d’indexation. Incluez les URL canoniques préférées réussies ; excluez les redirections, erreurs, pages noindex, doublons paramétriques et URL protégées. Google recommande des URLs absolues entièrement qualifiées et considère l’inclusion dans le sitemap comme un indice canonique, pas une garantie.

Validez le sitemap et comparez-le avec la liste des pages destinées à l’indexation et la navigation. Google documente l’encodage UTF-8 et une limite de 50 Mo non compressés ou 50 000 URLs par sitemap. Pour les sites plus grands, segmentez en groupes utiles et utilisez un index. Mettez à jour lastmod uniquement pour des changements significatifs et vérifiables de la page.

Réconcilier les listes

Analysez les différences significatives entre les URLs prévues, les entrées du sitemap et les liens internes.

Refetch après mise en production

Vérifiez le sitemap généré et un échantillon d’URLs listées après des changements de routage ou CMS.

07

Mesurer la performance et institutionnaliser l’audit

Utilisez des données de terrain lorsque disponibles et des tests de laboratoire contrôlés pour investiguer les Core Web Vitals : Largest Contentful Paint (LCP) pour le chargement, Interaction to Next Paint (INP) pour la réactivité, et Cumulative Layout Shift (CLS) pour la stabilité visuelle. Segmentez par type de page et par appareil car les moyennes peuvent masquer un template à fort enjeu dégradé.

Tracez les livraisons lentes ou instables à travers les images, CSS et JavaScript, balises tierces, polices, embeds et cache. Faites un changement mesuré à la fois, puis revérifiez le rendu et les parcours utilisateurs. Les données de terrain reflètent de vrais utilisateurs ; les données de laboratoire aident à reproduire. Aucune ne prédit tous les crawlers ou visiteurs futurs. Répétez une vérification de régression ciblée après des déploiements risqués et un audit plus complet après migrations ou changements de plateforme.

Prioriser l’exposition

Réparez les échecs sur les templates critiques pour le chiffre d’affaires ou très utilisés avant d’optimiser de petits gains de score ailleurs.

Clore avec une preuve

Revérifiez la réponse, le canonical, le contenu rendu, l’état du sitemap et les preuves de performance pertinentes avant clôture.

ACTION / VÉRIFIER

Votre guide pratique des actions à mener.

  1. 01

    Définir l’inventaire destiné à l’indexation

    Listez les URLs publiques clés par template avec canonical attendu, indexabilité, priorité et propriétaire.

    VÉRIFIER: Chaque template majeur a un état attendu échantillonné et documenté.
  2. 02

    Enregistrer les réponses publiques

    Capturez le statut, les en-têtes, les sauts de redirection, l’URL finale et le type de contenu sans session authentifiée.

    VÉRIFIER: Aucune URL importante échantillonnée n’a de chaîne inexplicable ou d’erreur serveur.
  3. 03

    Vérifier les contrôles d’index

    Contrôlez les meta robots, X-Robots-Tag et l’accessibilité de robots.txt.

    VÉRIFIER: Les pages destinées à l’indexation n’ont pas d’exclusion accidentelle et les pages sensibles utilisent des contrôles d’accès.
  4. 04

    Réconcilier les signaux canoniques

    Comparez les balises canonical, redirections, liens internes, sitemaps, choix d’hôte et HTTPS.

    VÉRIFIER: Chaque famille de doublons a une URL préférée documentée ou une exception écrite.
  5. 05

    Exercer les échecs et déplacements

    Demandez les anciennes URLs, les URLs inexistantes, HTTP, hôtes alternatifs et le contenu supprimé.

    VÉRIFIER: Les déplacements sont directs et pertinents ; le contenu manquant ne renvoie pas une coquille 200.
  6. 06

    Inspecter le rendu

    Comparez source et rendu pour le texte, les liens, les métadonnées et les routes d’erreur.

    VÉRIFIER: Le contenu essentiel et les liens crawlables sont visibles après rendu.
  7. 07

    Valider sitemap et liens

    Comparez le sitemap, la liste destinée à l’indexation et la navigation interne.

    VÉRIFIER: Seules les URLs préférées réussies et destinées à la découverte sont listées.
  8. 08

    Mesurer par type de page

    Passez en revue preuves de performance terrain et laboratoire, y compris dépendances et actifs.

    VÉRIFIER: Chaque correction de performance nomme le template affecté, la preuve et les vérifications de régression.
  9. 09

    Déployer en sécurité et retester

    Livrez des corrections groupées avec un plan de rollback, puis répétez les contrôles affectés.

    VÉRIFIER: Le travail fermé à haute priorité dispose d’une preuve avant-après.
SUJETS DE DISCUSSION

Comparez les compromis, pas les données privées.

Utilisez ces propositions avec votre équipe ou la communauté de propriétaires de sites. Partagez des méthodes et des enseignements, mais ne collez jamais d'identifiants, d'enregistrements clients ou de détails d'infrastructure non publics.

  1. 01

    Quel motif d’URL a causé votre problème de découverte technique le plus étendu, et quelle preuve a révélé la cause commune ?

  2. 02

    Comment décidez-vous si un doublon doit rediriger, déclarer un canonical, rester accessible ou être exclu ?

  3. 03

    Quel contrôle de release détecte le mieux les régressions de rendu, sitemap ou réponse avant qu’elles n’affectent des pages importantes ?

RESSOURCES POPULAIRES / DE RÉFÉRENCE

Consultez le matériel source.

Google Search CentralHow to specify a canonical URL with rel=canonical and other methods ↗

Signaux canoniques, redirections, canonicals auto-référents et conflits à éviter.

Examiné le 2026-09-27
Google Search CentralUnderstand the JavaScript SEO basics ↗

Guides sur le crawl, le rendu, les routes, l’injection de canonical et les soft 404 pour les applications JavaScript.

Examiné le 2026-09-27
Google for DevelopersHow HTTP status codes affect Google’s crawlers ↗

Référence pour la gestion par les crawlers des 2xx, redirections, 4xx, 429 et 5xx.

Examiné le 2026-09-27
Google Search CentralBuild and submit a sitemap ↗

Sélection des URLs pour le sitemap, limites, lastmod et remarques de soumission.

Examiné le 2026-09-27
Google Search CentralRobots meta tag, data-nosnippet, and X-Robots-Tag specifications ↗

Directives d’indexation, en-têtes pour les fichiers non-HTML et différenciation crawl vs noindex.

Examiné le 2026-09-27
web.devLearn Core Web Vitals ↗

Ressources pour les métriques d’expérience essentielles (Core Web Vitals).

Examiné le 2026-09-27

Politique des sources. Basé sur les pages officielles Google Search Central, Google for Developers et web.dev consultées à la date d’accès. Le comportement documenté des crawlers est distingué des recommandations pratiques ; l’indexation et le positionnement ne sont pas garantis.

CLARIFICATIONS RAPIDES

Questions fréquentes.

À quelle fréquence dois-je exécuter un audit SEO technique ?

Exécutez des vérifications de régression ciblées après des changements de templates, routage, CMS, CDN, tags ou dépendances. Effectuez un audit plus complet après une migration, une refonte, un changement de plateforme ou un travail important sur les URLs. Adaptez la fréquence au risque des changements et à l’importance métier.

Un code 200 signifie-t-il qu’une page va se classer ou être indexée ?

Non. Une réponse 200 permet le traitement, mais ne garantit ni l’indexation ni le positionnement. Les contrôles d’indexation, la cohérence canonique, l’accès au contenu utile et l’évaluation par le moteur demeurent déterminants.

Dois-je bloquer les pages dupliquées via robots.txt ?

Généralement non. robots.txt n’est pas un mécanisme de canonicalisation et le blocage peut empêcher la découverte d’une directive noindex. Alignez plutôt l’URL préférée, les redirections, le signal canonical, les liens internes et le sitemap ; utilisez des contrôles d’accès pour le contenu sensible.

Status Is UP Editorial Team · Rédacteurs Uptime Enablement

Examiné par Relecteur SEO technique et plateforme web. Publié 2026-09-27; mis à jour 2026-09-30.