
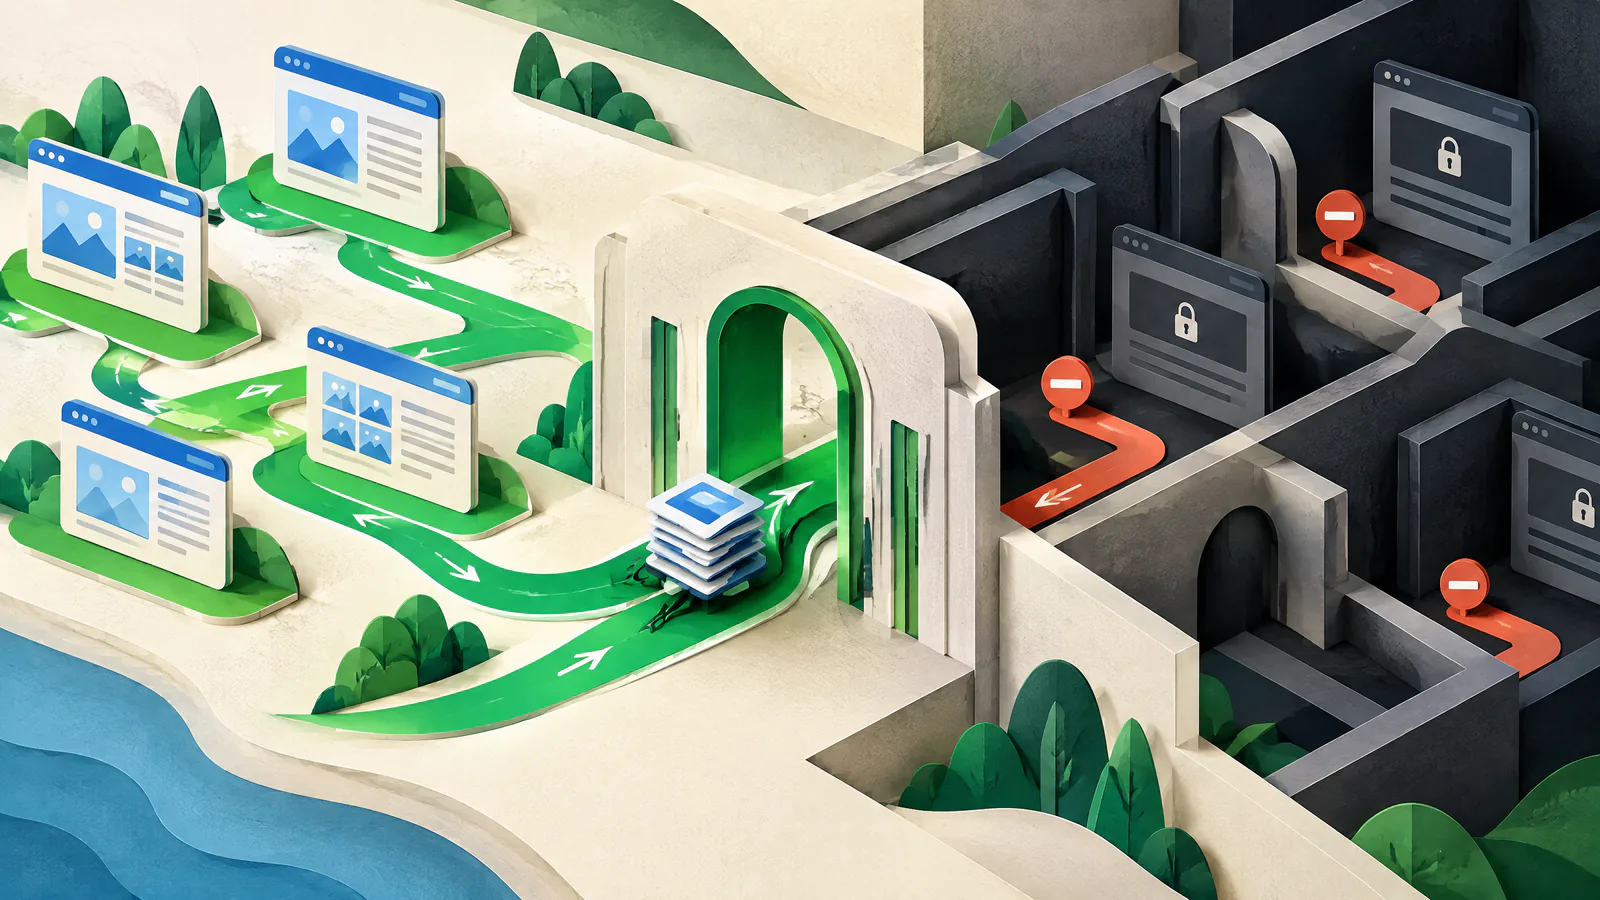
Wählen Sie die Kontrolle, die das gewünschte Ergebnis liefert
Crawling ist die automatisierte Abfrage einer URL. Indexierung ist die Entscheidung einer Suchmaschine, ob sie Informationen zu dieser URL speichert und anzeigt. Zugriffskontrolle bestimmt, wer Inhalte erhalten kann. Robots.txt betrifft das Crawling; konforme Crawler entscheiden, ob sie ihr folgen. Das IETF Robots Exclusion Protocol stellt klar, dass es keine Autorisierung ist.
Verwenden Sie eine Disallow‑Regel, um Crawler‑Zugriff auf einen öffentlichen, wenig wertvollen Pfad zu steuern, z. B. eine gesteuerte interne Such‑Route. Verwenden Sie noindex für öffentliche Inhalte, die nicht in unterstützten Suchergebnissen erscheinen sollen. Verwenden Sie echte Zugriffskontrollen für Previews, Kontobereiche, Exporte oder sensible Daten. Für Kunden-, Mitarbeiter-, Zahlungs‑ oder regulierte Informationen ist eine qualifizierte Sicherheits‑ und Plattformevaluierung erforderlich; robots.txt ist niemals ein kompensierender Kontrollmechanismus.
Robots.txt kann konforme Crawler bitten, einen definierten öffentlichen Pfad zu meiden; es garantiert nicht die Entfernung aus Suchergebnissen.
Verwenden Sie noindex im HTML‑Meta‑Tag oder per X‑Robots‑Tag‑Header, und lassen Sie die Antwort crawlbar, damit die Anweisung gelesen werden kann.
Erfordern Sie Authentifizierung oder eine geeignete Anwendungs‑/Serverkontrolle und entfernen Sie die URL aus öffentlichen Entdeckungswegen.
Verwenden Sie Kernsyntax und Umfang präzise
Veröffentlichen Sie eine UTF‑8‑Plain‑Text‑robots.txt unter /robots.txt für jedes Protokoll, jeden Host und Port, die Regeln benötigen. Eine Datei unter https://www.example.com/robots.txt gilt nicht automatisch für https://example.com, eine Subdomain oder ein HTTP‑Origin. Verifizieren Sie die durch kanonische URLs, Redirects, CDN und Anwendung bedienten Origins, bevor Sie annehmen, dass eine Regel gilt.
Eine Gruppe beginnt mit User‑agent und verwendet dann Allow oder Disallow‑Pfadregeln. User‑agent: * ist die allgemeine Gruppe. Das Matching ist case‑sensitive und beginnt am Pfadanfang. Die spezifischste passende Regel gewinnt; eine gleich spezifizierte Allow‑Regel sollte vor einer Disallow‑Regel gewinnen. Disallow: (ohne Pfad) blockiert nichts, während Disallow: / das gesamte Origin blockiert. Der Standard definiert # für Kommentare, * als Wildcard und $ für das Ende eines Musters.
Wenn kein dokumentierter Bedarf an Crawl‑Steuerung besteht, fügen Sie keine Ausschlüsse hinzu; erstellen Sie keine spekulativen Blockierungen.
Bevorzugen Sie ein stabiles, schmales Präfix wie /search/ gegenüber einem vagen Wildcard‑Muster oder einer nicht erklärten Dateinamensregel.
Dokumentieren Sie Zweck, Owner und Änderungsreferenz der Regel, aber behandeln Sie Kommentare nicht als Ersatz für eine Review.
Blockieren Sie nur Muster, die durch URL‑Beweise gestützt sind
Bevor Sie eine Regel schreiben, inventarisieren Sie wichtige Seiten, unerwünschte Crawl‑Pfade, Query‑Varianten, On‑Site‑Suche, Preview‑Routen, Assets und Sitemap‑URLs. Erfassen Sie für jede Beispiel‑URL das erwartete Ergebnis und die passende Regel. Vergleichen Sie die Liste mit kanonischen URLs und der Live‑Navigation, damit ein Block keinen nützlichen Pfad verdeckt.
Halten Sie browserkritische Ressourcen verfügbar, sofern nicht anders getestet. Google warnt, dass das Blockieren von CSS, JavaScript, Bildern oder anderen Ressourcen eine Seite schwerer analysierbar machen kann. Robots.txt löst keine Probleme mit Duplikatauswahl, Autorisierung oder Seitenqualität; verwenden Sie Canonical‑Tags, Redirects, Zugriffskontrollen oder Inhaltsarbeit, wo es angebracht ist.
Verwenden Sie echte URL‑Beispiele und Server‑ oder Crawl‑Belege, nicht eine generische Liste, die von einer anderen Site kopiert wurde.
Führen Sie für jede Beispiel‑URL das erwartete Ergebnis, die getroffene Regel und den verantwortlichen Owner im Release‑Record.
Halten Sie Sitemap‑Discovery, noindex und Datenschutzentscheidungen konsistent
Eine Sitemap teilt Suchmaschinen mit, welche URLs und Dateien Sie für wichtig halten; sie kann die Entdeckung unterstützen, garantiert aber kein Crawling oder Indexierung. Starke interne Verlinkung bleibt wichtig. Sie können eine vollständig qualifizierte Sitemap‑URL in robots.txt eintragen, listen Sie dort jedoch keine privaten, weitergeleiteten, robots‑blockierten oder absichtlich mit noindex versehenen URLs auf. Stimmen Sie die Sitemap‑Ausgabe mit Robots‑Regeln bei Releases ab.
Noindex ist keine robots.txt‑Direktive von Google. Google unterstützt sie im HTML‑Meta‑Tag oder im X‑Robots‑Tag HTTP‑Response‑Header und muss die Antwort crawlen, um sie zu sehen. Wenn eine öffentliche Seite aus Google‑Ergebnissen entfernt werden soll, entfernen Sie jede robots‑Sperre, die das noindex verbirgt. Wenn Inhalte nicht öffentlich sind, publizieren Sie ihren Pfad nicht in robots.txt; erzwingen Sie Zugriffskontrollen. Grenzen für sensible Daten benötigen qualifizierte Review.
Verwenden Sie eine vollständige URL, z. B. Sitemap: https://www.example.com/sitemap.xml; sie überschreibt keinen Crawl‑Block.
Verwenden Sie ein meta noindex für HTML oder einen X‑Robots‑Tag: noindex‑Response‑Header, wo es passt, und testen Sie dann die Live‑Antwort.
Beschränken Sie zuerst den Zugang, wenn Inhalte sensibel sind, und verwenden Sie dann ggf. den Entfernen‑Prozess der Suchmaschine.
Testen und veröffentlichen Sie es wie eine kritische Konfigurationsdatei
Validieren Sie den freigegebenen Text lokal und testen Sie dann erlaubte und blockierte Beispiele für die beabsichtigte Crawler‑Gruppe. Nach der Bereitstellung rufen Sie public /robots.txt privat oder per direkter HTTP‑Anfrage ab, um Inhalt, Origin und Response‑Status zu bestätigen. Google bietet im Search Console einen robots.txt‑Bericht für erreichbare Dateien und eine Open‑Source‑Parserbibliothek für lokale Tests.
Crawler können robots‑Dateien cachen; rechnen Sie also nicht mit sofortiger Wirkung bei Entdeckung oder Indexierungsänderungen. Server‑ oder Netzwerkfehler führen dazu, dass Crawler vollständige Disallow annehmen, während ein 4xx Zugriff erlauben kann. Bewahren Sie die Datei in Source‑Controlled‑Konfiguration auf, verlangen Sie zusätzliche Reviews für ganze Site‑ oder Wildcard‑Änderungen und behalten Sie die vorherige Version. SIU‑Preflights und Rollback‑Planung helfen, einen schlechten Release zu erkennen, bevor er zu einem größeren Verfügbarkeits‑ oder Auffindbarkeitsproblem wird.
Erfordern Sie einen zweiten Reviewer für Origin‑Migrationen, ganze Site‑Blöcke, Wildcards und Änderungen, die Anmeldung, Checkout oder Support‑Routen betreffen.
Stellen Sie die vorherige Version wieder her, wenn eine wichtige Beispiel‑URL neu blockiert wird, ein notwendiges Asset unzugänglich ist oder das Endpoint nicht erreichbar ist.
Ein Crawlertest beweist nicht, dass jeder automatisierte Client jede Regel auf dieselbe Weise interpretiert.