
STATUS IS UPWIKI DI OTTIMIZZAZIONE DEL SITO
29Rafforza
SEO e visibilità / Rafforza

Audit SEO tecnico: Guida operativa per proprietari

Un audit pratico e basato su prove per individuare le barriere tecniche alla scoperta tramite ricerca e ridurre la probabilità che si ripresentino.

Audit SEO tecnico: Guida operativa per proprietari — GUIDA VISIVA
LEGGI
8 minuti
FONTI
6
RIVALIDA
2027-03-27
rivisto
Revisore tecnico SEO e piattaforma web
LA RISPOSTA BREVE

Inizia dalla decisione.

Esegui un audit SEO tecnico come un breve ciclo di evidenza operativa: decidi quali pagine pubbliche devono essere trovate, testa la loro risposta e URL finale, verifica i controlli di indicizzazione e i segnali canonici, confronta il sorgente con il contenuto renderizzato, poi riconcilia link e sitemap. Risolvi prima i pattern a maggior impatto e ritesta dopo il rilascio.

Dai priorità ai blocchi rispetto ai punteggi. Un noindex involontario, un errore server, un redirect errato, un canonical in conflitto o contenuto renderizzato mancante possono impedire che una pagina preziosa venga presa in considerazione per l'indicizzazione. Una risposta 200 è solo un'opportunità di elaborazione, non una garanzia di indicizzazione o posizionamento.

Mantieni il deliverable operativo: pattern interessato, comportamento atteso, prova, owner, piano di rollout e percorso di rollback. Status Is UP supporta l'ottimizzazione proattiva dell'uptime e la rimedio affinché le pagine importanti rimangano raggiungibili e complete; non è monitoraggio di stato live né una promessa sugli esiti dei motori di ricerca.

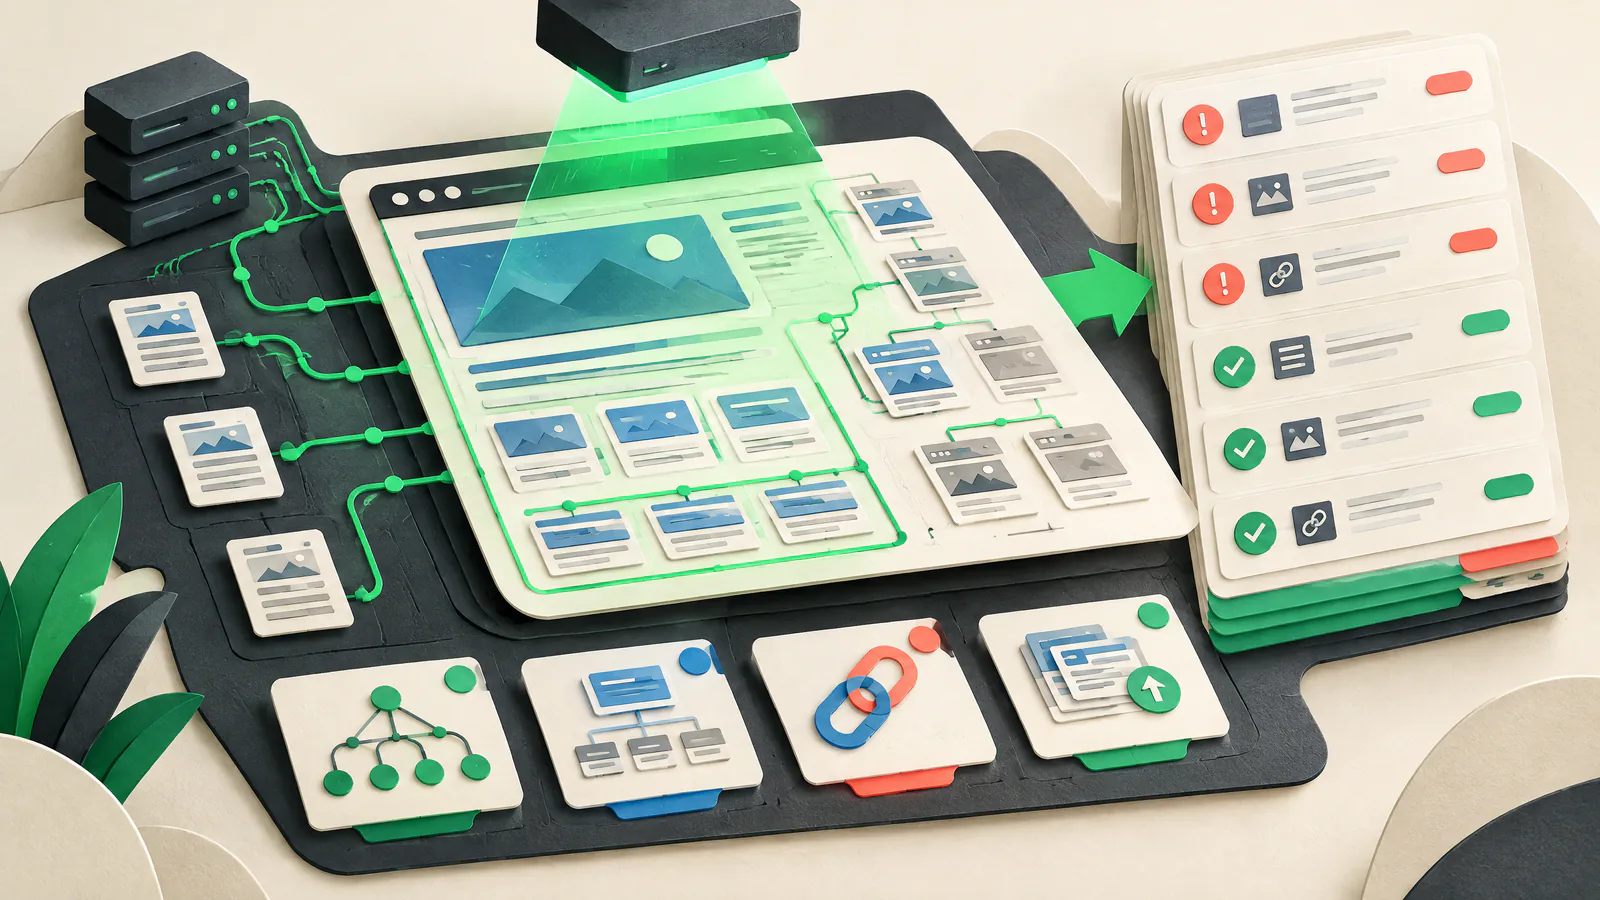
GUIDA VISIVA

Vedi il lavoro come un sistema.

Usa questa mappa per collegare le decisioni dell'articolo prima di agire su singole tattiche.

SIURafforza
01Inizia dalle pagine desiderate e prova riutilizzabile
02Rendi l'indicizzabilità una decisione deliberata
03Mantieni un unico URL preferito coerente
04Verifica codici di stato e comportamento dei redirect
01

Inizia dalle pagine desiderate e prova riutilizzabile

Elenca le pagine pubbliche che vuoi che gli utenti trovino tramite ricerca: prodotti chiave, articoli, categorie e URL spostati. Per ciascuna registra l'URL preferito, la risposta attesa, l'indexability, il template, l'owner e la priorità. Tieni separate le esclusioni legittime.

Cattura una risposta non autenticata, le intestazioni, il percorso dei redirect, il sorgente della pagina, la vista renderizzata, lo stato dei link interni e lo stato nella sitemap per URL rappresentativi. Campiona ogni template e pattern di URL. L'evidenza è datata: un'impostazione CDN, un deployment, un livello di consenso o una personalizzazione possono cambiarla in seguito.

Testa i pattern

Una homepage che passa i test non dimostra che listing, varianti prodotto o route localizzate funzionino.

Salva una baseline

Conserva intestazioni datate e prove renderizzate così da poter comparare correzioni e regressioni successive.

02

Rendi l'indicizzabilità una decisione deliberata

L'indicizzabilità significa che una pagina può essere inclusa in un indice di ricerca; non è la stessa cosa del crawling o del posizionamento. Controlla le direttive meta robots nell'HTML e l'intestazione di risposta X-Robots-Tag. La direttiva noindex dice ai motori di ricerca di non mostrare una pagina; X-Robots-Tag si applica anche a file non-HTML come PDF.

Revisiona robots.txt separatamente. Un crawler deve poter accedere a una pagina per trovare la direttiva noindex, quindi bloccare quell'URL può impedire che la direttiva venga vista. Verifica la risposta pubblica distribuita perché impostazioni CMS e flag di ambiente possono aggiungere regole. Noindex non è controllo di accesso: proteggi materiale sensibile con autenticazione e una revisione di sicurezza appropriata.

Individua esclusioni accidentali

Segnala noindex, risposte di login, riferimenti a staging e asset essenziali bloccati sulle pagine destinate all'indicizzazione.

Controlla anche le intestazioni

Un'intestazione HTTP può trasportare una direttiva anche quando non esiste un head HTML.

03

Mantieni un unico URL preferito coerente

La canonicalizzazione individua l'URL preferito tra versioni duplicate o molto simili, come HTTP e HTTPS, host differenti, parametri di tracciamento, filtri o pagine di stampa. Confronta l'elemento canonical, i link interni, l'URL in sitemap e la destinazione del redirect. Per una pagina indicizzabile dovrebbero normalmente identificarsi lo stesso URL preferito assoluto.

Usa un redirect permanente lato server quando ritiri un duplicato. Google descrive i redirect permanenti e rel=canonical come segnali forti, mentre l'inclusione in sitemap è un segnale più debole; segnali allineati rafforzano la preferenza. Non usare robots.txt per canonicalizzare né dare a una pagina canonicali concorrenti. Un canonical che si autoreferenzia aiuta a dichiarare la versione preferita, ma la selezione finale da parte del motore di ricerca resta fuori dal tuo controllo.

Mappa ogni famiglia

Documenta le varianti, il target preferito, il controllo richiesto e un owner.

Proteggi le modifiche

Testa le mappature vecchio→nuovo prima di una migrazione e mantieni pronta una modifica di redirect reversibile.

04

Verifica codici di stato e comportamento dei redirect

I codici di stato dicono ai browser e ai crawler cosa è successo. Le pagine live importanti dovrebbero restituire una risposta 2xx significativa con il contenuto previsto. Una pagina senza un sostituto rilevante dovrebbe restituire un autentico 404 o 410; il contenuto spostato dovrebbe raggiungere il suo sostituto più pertinente. Una pagina 200 che mostra solo un errore può essere trattata come soft 404.

Registra ogni hop di redirect. Google in genere segue fino a 10 hop per il crawling generale, ma le catene aggiungono latenza e fragilità. Google segnala che risposte 5xx e 429 possono rallentare temporaneamente il crawling e che errori server persistenti possono infine rimuovere URL indicizzati. Indaga sulle cadute ricorrenti con l'owner di ingegneria attraverso application, CDN, origin, cache, dipendenze e layer di deployment.

Classifica gli esiti

Salva URL originale, hop, codici, URL finale e stato atteso.

Sistema il set di regole

Rimuovi regole sovrapposte di CMS, CDN, host, localizzazione o slash invece di aggiungere un altro hop.

05

Valida il rendering JavaScript e le route

Ispeziona sia l'HTML iniziale sia una vista renderizzata per i template chiave. Conferma che il contenuto principale, gli heading, i link, il canonical, le direttive robots e lo stato esistano dopo il rendering. Google descrive fasi separate di crawl, render e indicizzazione e dice che il contenuto non visibile nell'HTML renderizzato non può essere indicizzato.

Usa elementi anchor con valori href per la navigazione. Route basate solo su fragment che caricano contenuti distinti non sono affidabili per la scoperta. Richiedi direttamente prodotti, articoli e URL filtrati non esistenti. Le applicazioni client-side hanno bisogno di un reale stato di errore; Google documenta il routing verso un 404 server o l'aggiunta di noindex per evitare soft 404. Il rendering lato server o il prerendering possono aiutare, ma verifica la risposta effettivamente distribuita.

Confronta tre viste

Controlla HTML di risposta, HTML renderizzato e la vista browser umana per differenze materiali.

Mantieni il canonical stabile

Prediligi l'HTML sorgente; se il JavaScript lo imposta, assicurati che ci sia un solo canonical non conflittuale.

06

Mantieni sitemap e link interni puliti

Una sitemap è una mappa di scoperta, non un comando di indicizzazione. Includi URL preferiti canonical di successo e previsti; escludi redirect, errori, pagine noindex, duplicati di parametri e URL protetti. Google raccomanda URL assoluti completamente qualificati e tratta l'inclusione in sitemap come un suggerimento canonico, non una garanzia.

Valida la sitemap e confrontala con la lista delle pagine destinate all'indicizzazione e con la navigazione. Google documenta la codifica UTF-8 e un limite di 50 MB non compresso o 50.000 URL per sitemap. Per siti più grandi, suddividi in gruppi utili e usa un index. Aggiorna lastmod solo per modifiche significative e verificabili della pagina.

Riconcilia le liste

Indaga differenze significative tra URL previsti, voci di sitemap e link interni.

Rifletti dopo il rilascio

Controlla la sitemap generata e un campione di URL elencati dopo cambi di routing o del CMS.

07

Misura le prestazioni e istituzionalizza l'audit

Usa dati field quando disponibili e test di laboratorio controllati per investigare i Core Web Vitals: Largest Contentful Paint per il caricamento, Interaction to Next Paint per la reattività e Cumulative Layout Shift per la stabilità visiva. Segmenta per tipo di pagina e dispositivo perché le medie possono nascondere un template ad alto valore rotto.

Traccia consegne lente o instabili attraverso immagini, CSS e JavaScript, tag di terze parti, font, embed e caching. Fai una modifica misurata per volta, poi ricontrolla rendering e flussi utente. I dati field riflettono utenti reali; i dati lab aiutano nella riproduzione. Nessuno dei due predice ogni futuro crawler o visitatore. Ripeti un controllo di regressione focalizzato dopo rilasci rischiosi e un audit più completo dopo migrazioni o cambi di piattaforma.

Prioritizza l'esposizione

Ripara i fallimenti sui template critici per i ricavi o ad alto utilizzo prima di piccoli guadagni di punteggio altrove.

Chiudi con prova

Ricontrolla risposta, canonical, contenuto renderizzato, stato della sitemap e evidenze di performance rilevanti prima di chiudere.

AZIONE / VERIFICA

La tua guida pratica alle attività.

  1. 01

    Imposta l'inventario delle pagine destinate all'indice

    Elenca URL pubblici chiave per template con canonical atteso, indicizzabilità, priorità e owner.

    VERIFICA: Ogni template principale ha uno stato atteso campionato e documentato.
  2. 02

    Registra le risposte pubbliche

    Cattura stato, intestazioni, hop di redirect, URL finale e content type senza sessione autenticata.

    VERIFICA: Nessun URL importante campionato ha una catena o un errore server inspiegato.
  3. 03

    Controlla i controlli di indicizzazione

    Verifica meta robots, X-Robots-Tag e accessibilità di robots.txt.

    VERIFICA: Le pagine destinate all'indice non hanno esclusioni accidentali e le pagine sensibili usano controlli di accesso.
  4. 04

    Riconcilia i segnali canonical

    Confronta tag canonical, redirect, link interni, sitemap, host e scelte HTTPS.

    VERIFICA: Ogni famiglia di duplicati ha un URL preferito documentato o un'eccezione scritta.
  5. 05

    Esercita fallimenti e spostamenti

    Richiedi URL vecchi, inesistenti, HTTP, alternate-host e contenuti rimossi.

    VERIFICA: Gli spostamenti sono diretti e pertinenti; i contenuti mancanti non restituiscono una shell 200 di errore.
  6. 06

    Ispeziona il rendering

    Confronta sorgente e output renderizzato per testo, link, metadata e route di errore.

    VERIFICA: Contenuti essenziali e link crawlabili sono visibili dopo il rendering.
  7. 07

    Valida sitemap e link

    Confronta sitemap, lista destinata all'indice e navigazione interna.

    VERIFICA: Sono elencati solo URL preferiti di successo destinati alla scoperta.
  8. 08

    Misura per tipo di pagina

    Revisiona evidenze di performance field e lab, incluse dipendenze e asset.

    VERIFICA: Ogni fix di performance nomina template interessato, evidenza e controlli di regressione.
  9. 09

    Rilascia in sicurezza e ritesta

    Spedisci fix raggruppati con piano di rollback, poi ripeti i controlli interessati.

    VERIFICA: Il lavoro ad alta priorità chiuso ha evidenza before-and-after.
ARGOMENTI DI DISCUSSIONE

Confronta i compromessi, non i dati privati.

Usa questi spunti con il tuo team o la community dei proprietari di siti. Condividi metodi e lezioni, ma non incollare mai credenziali, dati dei clienti o dettagli infrastrutturali non pubblici.

  1. 01

    Quale pattern di URL ha causato il tuo problema più diffuso di scoperta tecnica e quale evidenza ha rivelato la causa condivisa?

  2. 02

    Come decidi se un duplicato dovrebbe reindirizzare, dichiarare un canonical, rimanere accessibile o essere escluso?

  3. 03

    Quale controllo di rilascio cattura meglio regressioni di rendering, sitemap o risposta prima che raggiungano pagine importanti?

RISORSE POPOLARI / AUTOREVOLI

Apri il materiale di riferimento.

Google Search CentralHow to specify a canonical URL with rel=canonical and other methods ↗

Segnali canonicali, redirect, canonical autoreferenziali e conflitti da evitare.

Rivisto 2026-09-27
Google Search CentralUnderstand the JavaScript SEO basics ↗

Guida su crawl, render, route, injection di canonical e soft 404 per applicazioni JavaScript.

Rivisto 2026-09-27
Google for DevelopersHow HTTP status codes affect Google’s crawlers ↗

Riferimento per gestione crawler di 2xx, redirect, 4xx, 429 e 5xx.

Rivisto 2026-09-27
Google Search CentralBuild and submit a sitemap ↗

Selezione URL in sitemap, limiti, lastmod e avvertenze di invio.

Rivisto 2026-09-27
Google Search CentralRobots meta tag, data-nosnippet, and X-Robots-Tag specifications ↗

Direttive di indicizzazione, intestazioni per file non-HTML e crawling vs noindex.

Rivisto 2026-09-27
web.devLearn Core Web Vitals ↗

Risorse per metriche dell'esperienza core (Core Web Vitals).

Rivisto 2026-09-27

Politica delle fonti. Basato su pagine ufficiali di Google Search Central, Google for Developers e web.dev lette alla data di accesso. Il comportamento documentato del crawler è distinto dalle raccomandazioni pratiche; indicizzazione e posizionamento non sono promessi.

Chiarimenti rapidi

Domande comuni.

Quanto spesso dovrei eseguire un audit SEO tecnico?

Esegui controlli di regressione focalizzati dopo cambi a template, routing, CMS, CDN, tag o dipendenze. Esegui un audit più completo dopo una migrazione, redesign, cambio di piattaforma o lavori importanti sugli URL. Allinea la frequenza al rischio di cambiamento e all'importanza per il business.

Un codice di stato 200 significa che una pagina verrà indicizzata o si posizionerà?

No. Una risposta 200 permette l'elaborazione, ma non garantisce indicizzazione o posizionamento. Contano i controlli di indicizzazione, la coerenza canonical, contenuti utili accessibili e la valutazione del motore di ricerca.

Dovrei bloccare le pagine duplicate in robots.txt?

Di solito no. Robots.txt non canonicalizza e bloccare può impedire la scoperta di una direttiva noindex. Allinea URL preferito, redirect, segnale canonical, link interni e sitemap; usa controlli di accesso per contenuti sensibili.

Status Is UP Editorial Team · Uptime Enablement Editors

Revisionato da Revisore tecnico SEO e piattaforma web. Pubblicato 2026-09-27; aggiornato 2026-09-30.