
STATUS IS UPWIKI D'OPTIMISATION DE SITE
32Renforcer
SEO et visibilité / Renforcer

Guide robots.txt : contrôler le crawl sans masquer les erreurs

Utilisez robots.txt pour orienter l’accès des crawlers, puis associez-le à la bonne méthode d’indexation ou de contrôle d’accès selon l’objectif.

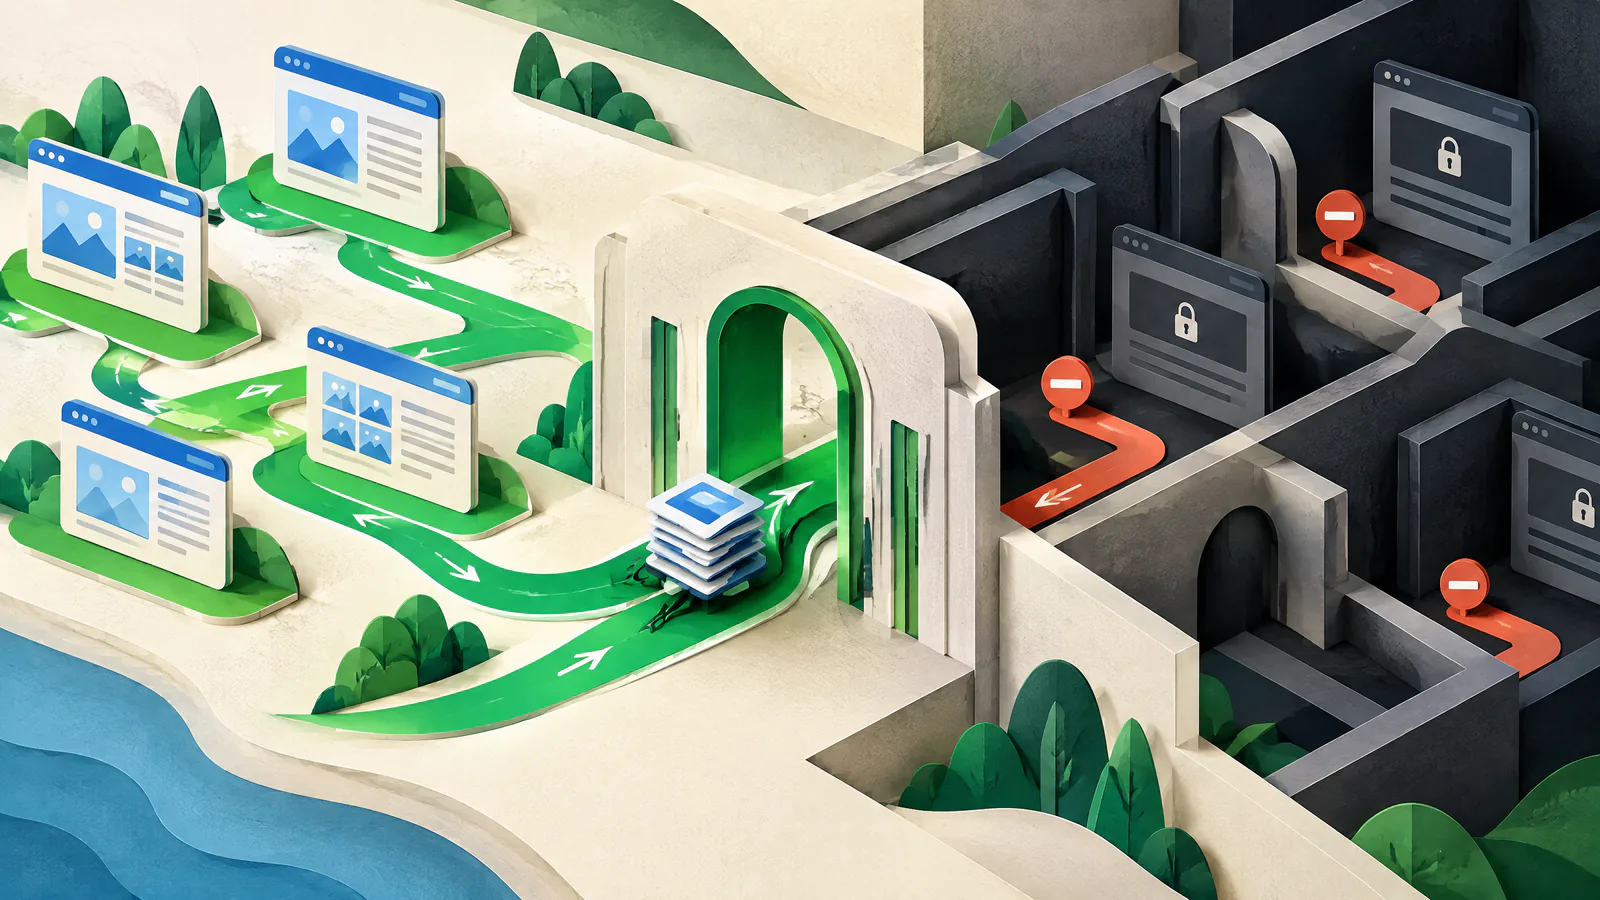
Guide robots.txt : contrôler le crawl sans masquer les erreurs — GUIDE VISUEL
LIRE
8 minutes
SOURCES
6
RÉVALIDER
2027-03-27
examiné
Relecteur SEO technique et plateforme web ; ajouter une revue sécurité pour les décisions de contrôle d’accès ou de contenu sensible.
LA RÉPONSE COURTE

Commencez par la décision.

Utilisez robots.txt pour demander aux crawlers conformes d’éviter des motifs d’URL publics spécifiques qui génèrent du travail de crawl inutile. Publiez un fichier texte brut UTF-8 à la racine de l’origine exacte du site et commencez par peu de règles. C’est un signal d’accès pour les crawlers, pas une serrure, et cela ne cache jamais une erreur.

Robots.txt ne protège pas de manière fiable une page ni ne la rend invisible. Une URL bloquée peut toujours être découverte via des liens. Pour du contenu public qui ne doit pas être indexé, utilisez noindex tout en autorisant le crawler à récupérer la réponse. Pour du contenu privé, appliquez des contrôles d’accès côté serveur ou application.

Traitez les modifications comme une configuration de production : identifiez l’origine, testez des URL nommées, récupérez le /robots.txt en production et gardez la version précédente prête. SIU prend en charge la disponibilité proactive et la remédiation via une discipline de préflight et de rollback, pas par des alertes d’indisponibilité ou des rapports d’état.

GUIDE VISUEL

Voyez le travail comme un système.

Utilisez cette carte pour relier les décisions de l'article avant d'agir sur des tactiques isolées.

SIURenforcer
01Choisissez le contrôle qui correspond à l’objectif
02Utilisez la syntaxe et la portée de base avec précision
03Bloquez uniquement des motifs soutenus par des preuves d’URL
04Alignez sitemap, noindex et décisions de confidentialité
01

Choisissez le contrôle qui correspond à l’objectif

Le crawling est la récupération automatisée d’une URL. L’indexation est la décision d’un moteur de recherche de stocker et d’afficher des informations la concernant. Le contrôle d’accès décide qui peut obtenir du contenu. Robots.txt concerne le crawling, et les crawlers conformes décident de le suivre ou non. Le protocole d’exclusion des robots de l’IETF indique qu’il ne s’agit pas d’une autorisation.

Utilisez une règle Disallow pour gérer l’accès des crawlers à un chemin public de faible valeur, comme une route de recherche interne contrôlée. Utilisez noindex pour du contenu public qui ne doit pas apparaître dans les résultats pris en charge. Utilisez de véritables contrôles d’accès pour les aperçus, les zones nécessitant une connexion, les exports ou les données sensibles. Pour les informations clients, employés, paiement ou réglementées, obtenez une revue qualifiée de sécurité et de plateforme ; robots.txt n’est jamais un contrôle compensatoire.

Gestion du crawl

Robots.txt peut demander aux crawlers conformes d’éviter un chemin public défini ; il ne garantit pas la suppression des résultats.

Contrôle d’indexation

Utilisez noindex dans le HTML ou un en-tête HTTP X-Robots-Tag, et laissez la réponse crawlable pour que l’instruction puisse être lue.

Contenu privé

Exigez une authentification ou un contrôle applicatif/serveur approprié, puis retirez l’URL des chemins de découverte publics.

02

Utilisez la syntaxe et la portée de base avec précision

Publiez un robots.txt texte brut UTF-8 à /robots.txt pour chaque scheme, hôte et port qui nécessite des règles. Un fichier à https://www.example.com/robots.txt ne gouverne pas automatiquement https://example.com, un sous-domaine ou une origine HTTP. Vérifiez les origines servies par les URL canoniques, les redirections, le CDN et l’application avant de supposer qu’une règle s’applique.

Un groupe commence par User-agent puis utilise Allow ou Disallow pour des chemins. User-agent: * est le groupe général. La correspondance est sensible à la casse et débute au début du chemin. La règle la plus spécifique gagne ; un Allow d’égale spécificité devrait l’emporter sur un Disallow. Disallow: ne bloque rien, tandis que Disallow: / bloque toute l’origine. La norme définit # pour les commentaires, * pour le joker, et $ pour la fin d’un motif.

Petit socle minimal

S’il n’existe pas de besoin documenté de gestion du crawl, n’ajoutez aucune exclusion ; n’introduisez pas de blocages spéculatifs.

Motif sûr

Privilégiez un préfixe stable et étroit comme /search/ plutôt qu’un joker lâche ou une règle de nom de fichier non expliquée.

Commentaires

Notez l’objet de la règle, le propriétaire et la référence de changement, mais ne traitez pas les commentaires comme un substitut à une revue formelle.

03

Bloquez uniquement des motifs soutenus par des preuves d’URL

Avant d’écrire une règle, dressez l’inventaire des pages importantes, des chemins de crawl indésirables, des variantes de requête, de la recherche interne, des routes d’aperçu, des assets et des URL de sitemap. Pour chaque URL d’exemple, enregistrez le résultat attendu et la règle correspondante. Comparez la liste avec les URL canoniques et la navigation en direct afin qu’un blocage ne masque pas une route utile.

Conservez accessibles les ressources critiques pour le rendu dans le navigateur à moins d’un test contraire. Google met en garde contre le blocage de CSS, JavaScript, images ou autres ressources qui peut rendre une page plus difficile à analyser. Robots.txt ne résout pas la sélection de contenu dupliqué, l’autorisation ou la qualité d’une page ; utilisez la canonicalisation, les redirections, les contrôles d’accès ou le travail de contenu là où c’est approprié.

Preuves d’abord

Utilisez des échantillons d’URL réels et des preuves serveur ou de crawl, pas une liste générique copiée d’un autre site.

Tableau de changements

Conservez pour chaque URL d’exemple le résultat attendu, la règle correspondante et le propriétaire responsable dans le dossier de lancement.

04

Alignez sitemap, noindex et décisions de confidentialité

Un sitemap indique aux moteurs quelles URL et quels fichiers vous jugez importants ; il peut aider à la découverte mais ne garantit ni le crawl ni l’indexation. Des liens internes forts restent déterminants. Vous pouvez ajouter une URL Sitemap entièrement qualifiée dans robots.txt, mais ne listez pas d’URL privées, redirigées, bloquées par robots ou volontairement noindexées. Réconciliez la sortie du sitemap avec les règles robots lors du déploiement.

Noindex n’est pas une directive de robots.txt spécifique à Google. Google la prend en charge via une balise meta dans le HTML ou un en-tête HTTP X-Robots-Tag, et doit crawler la réponse pour la voir. Si une page publique doit être retirée des résultats Google, supprimez tout bloc robots qui masque le noindex. Si le contenu est non public, n’annoncez pas son chemin dans robots.txt ; appliquez un contrôle d’accès. Les frontières liées aux données sensibles nécessitent une revue qualifiée.

Déclaration de sitemap

Utilisez une URL complète, par exemple Sitemap: https://www.example.com/sitemap.xml ; cela n’annule pas un blocage de crawl.

HTML et fichiers

Utilisez meta noindex pour le HTML ou un en-tête X-Robots-Tag: noindex lorsque c’est approprié, puis testez la réponse en production.

Exposition urgente

Restreignez d’abord l’accès lorsque le contenu est sensible, puis utilisez le processus de suppression du moteur de recherche si nécessaire.

05

Testez et publiez-le comme un fichier de configuration critique

Validez le texte approuvé localement, puis testez des exemples autorisés et interdits pour le groupe de crawlers visé. Après déploiement, récupérez le /robots.txt public en privé ou par requête HTTP directe pour confirmer le contenu, l’origine et le statut de la réponse. Google propose un rapport robots.txt dans Search Console pour les fichiers accessibles et une bibliothèque d’analyse open-source pour les tests locaux.

Les crawlers peuvent mettre en cache les fichiers robots, donc ne comptez pas sur une découverte ou des changements d’indexation immédiats. Les erreurs serveur ou réseau amènent les crawlers à supposer un disallow complet, tandis qu’un 4xx peut permettre l’accès. Conservez le fichier dans la configuration contrôlée par le code, exigez une revue renforcée pour les blocs sur tout le site ou les jokers, et conservez la version précédente. Les préflights SIU et la planification du rollback aident à détecter un mauvais déploiement avant qu’il ne devienne un problème d’accessibilité ou de découvrabilité plus large.

Porte de sortie

Exigez un deuxième relecteur pour les migrations d’origine, les blocages « tout le site », les jokers et les changements affectant l’authentification, le paiement ou les routes de support.

Signal de rollback

Restaurez la version antérieure lorsqu’une URL d’échantillon importante est nouvellement bloquée, qu’un asset nécessaire est inaccessible ou que le point de terminaison est indisponible.

Limite

Un seul test de crawler ne prouve pas que chaque client automatisé interprète chaque règle de la même façon.

ACTION / VÉRIFIER

Votre guide pratique des actions à mener.

  1. 01

    Classer l’objectif

    Choisissez gestion du crawl, exclusion d’indexation ou accès privé avant de sélectionner un contrôle.

    VÉRIFIER: Chaque URL affectée a un objectif documenté et un propriétaire responsable.
  2. 02

    Cartographier l’origine

    Identifiez le protocole exact, l’hôte, le port, le sous-domaine, le CDN et l’origine applicative impliqués.

    VÉRIFIER: Aucune origine n’est supposée hériter des règles robots d’une autre origine.
  3. 03

    Lister des URL représentatives

    Incluez pages importantes, cibles, variantes, assets, entrées de sitemap et routes privées.

    VÉRIFIER: Un tableau nomme le résultat attendu pour chaque URL de test.
  4. 04

    Rédiger des règles étroites

    Utilisez des User-agent, Allow et Disallow clairs ; évitez les jokers larges sauf nécessité.

    VÉRIFIER: Un relecteur peut expliquer la portée et les exceptions de chaque règle.
  5. 05

    Mettre en œuvre noindex correctement

    Utilisez une balise meta ou un en-tête de réponse pour le contenu public exclu de Google.

    VÉRIFIER: La cible en production est crawlable et expose le noindex au crawler.
  6. 06

    Protéger le matériel non public

    Utilisez l’authentification ou des contrôles serveur et applicatifs, pas robots.txt.

    VÉRIFIER: Une requête non authentifiée ne peut pas obtenir le contenu sensible.
  7. 07

    Publier le fichier approuvé

    Déployez le texte brut UTF-8 à la racine de l’origine.

    VÉRIFIER: L’URL /robots.txt en production renvoie le fichier revu.
  8. 08

    Tester le comportement en production

    Vérifiez des exemples autorisés et bloqués avec les outils appropriés.

    VÉRIFIER: Les résultats correspondent au tableau de lancement, y compris les exceptions.
  9. 09

    Réconcilier les entrées de découverte

    Maintenez cohérence entre sitemap et liens internes avec les décisions de crawl et d’index.

    VÉRIFIER: Aucune URL intentionnellement privée, redirigée, noindex ou bloquée n’apparaît dans le sitemap sans raison.
  10. 10

    Garder un rollback prêt

    Stockez le fichier précédent et ajoutez le changement de règle aux procédures de lancement et de récupération.

    VÉRIFIER: Une version connue bonne et un propriétaire de rollback sont immédiatement identifiables.
SUJETS DE DISCUSSION

Comparez les compromis, pas les données privées.

Utilisez ces propositions avec votre équipe ou la communauté de propriétaires de sites. Partagez des méthodes et des enseignements, mais ne collez jamais d'identifiants, d'enregistrements clients ou de détails d'infrastructure non publics.

  1. 01

    Quelles motifs d’URL publiques génèrent du travail de crawl sur votre site, et quelles preuves vous ont aidé à distinguer un vrai problème d’une variation inoffensive ?

  2. 02

    Comment votre équipe révise-t-elle un changement de robots.txt conjointement avec sitemap, canonical et décisions de contrôle d’accès avant un lancement ?

  3. 03

    Quel signal de rollback indiquerait à votre équipe qu’une nouvelle règle de crawler nuit à un parcours utilisateur ou commercial important ?

RESSOURCES POPULAIRES / DE RÉFÉRENCE

Consultez le matériel source.

Google Search CentralIntroduction to robots.txt ↗

Explique l’usage prévu par Google, les limites dans les résultats de recherche et les limites de sécurité de robots.txt.

Examiné le 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

La référence normative pour la syntaxe, la correspondance, la portée, les erreurs, la mise en cache et les limites de sécurité.

Examiné le 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Montre l’utilisation du meta-tag noindex et de l’en-tête HTTP et pourquoi la réponse doit rester crawlable.

Examiné le 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Couvre le placement, la syntaxe prise en charge, les déclarations Sitemap et les options de test.

Examiné le 2026-09-27
Google Search CentralLearn about sitemaps ↗

Précise les avantages et limites de la découverte via sitemap et l’importance des liens internes.

Examiné le 2026-09-27
MDN Web DocsHTTP authentication ↗

Un aperçu du contrôle d’accès HTTP et des considérations HTTPS pour l’authentification.

Examiné le 2026-09-27

Politique des sources. Cet article utilise des standards primaires liés et de la documentation officielle. Vérifiez la configuration spécifique au produit contre la documentation de plateforme en vigueur avant déploiement.

CLARIFICATIONS RAPIDES

Questions fréquentes.

Robots.txt peut-il empêcher une page d’apparaître dans Google Search ?

Non. Une URL bloquée peut toujours être découverte et apparaître dans les résultats. Utilisez un noindex crawlable pour le contenu public à exclure, et des contrôles d’accès pour le contenu privé.

Quel est le fichier robots.txt de départ le plus sûr ?

Commencez sans exclusions sauf si vous pouvez documenter un besoin de gestion du crawl. N’ajoutez que des chemins étroits testés contre les pages et ressources importantes.

Faut-il lister un sitemap dans robots.txt ?

Cela peut se faire. Une ligne Sitemap entièrement qualifiée aide la découverte par les crawlers mais n’impose pas le crawl ou l’indexation, et n’annule pas un blocage robots.

Status Is UP Editorial Team · Rédacteurs Uptime Enablement

Examiné par Relecteur SEO technique et plateforme web ; ajouter une revue sécurité pour les décisions de contrôle d’accès ou de contenu sensible.. Publié 2026-09-27; mis à jour 2026-09-30.