
STATUS IS UPWIKI DI OTTIMIZZAZIONE DEL SITO
32Rafforza
SEO e visibilità / Rafforza

Guida robots.txt: gestire il crawling senza nascondere errori

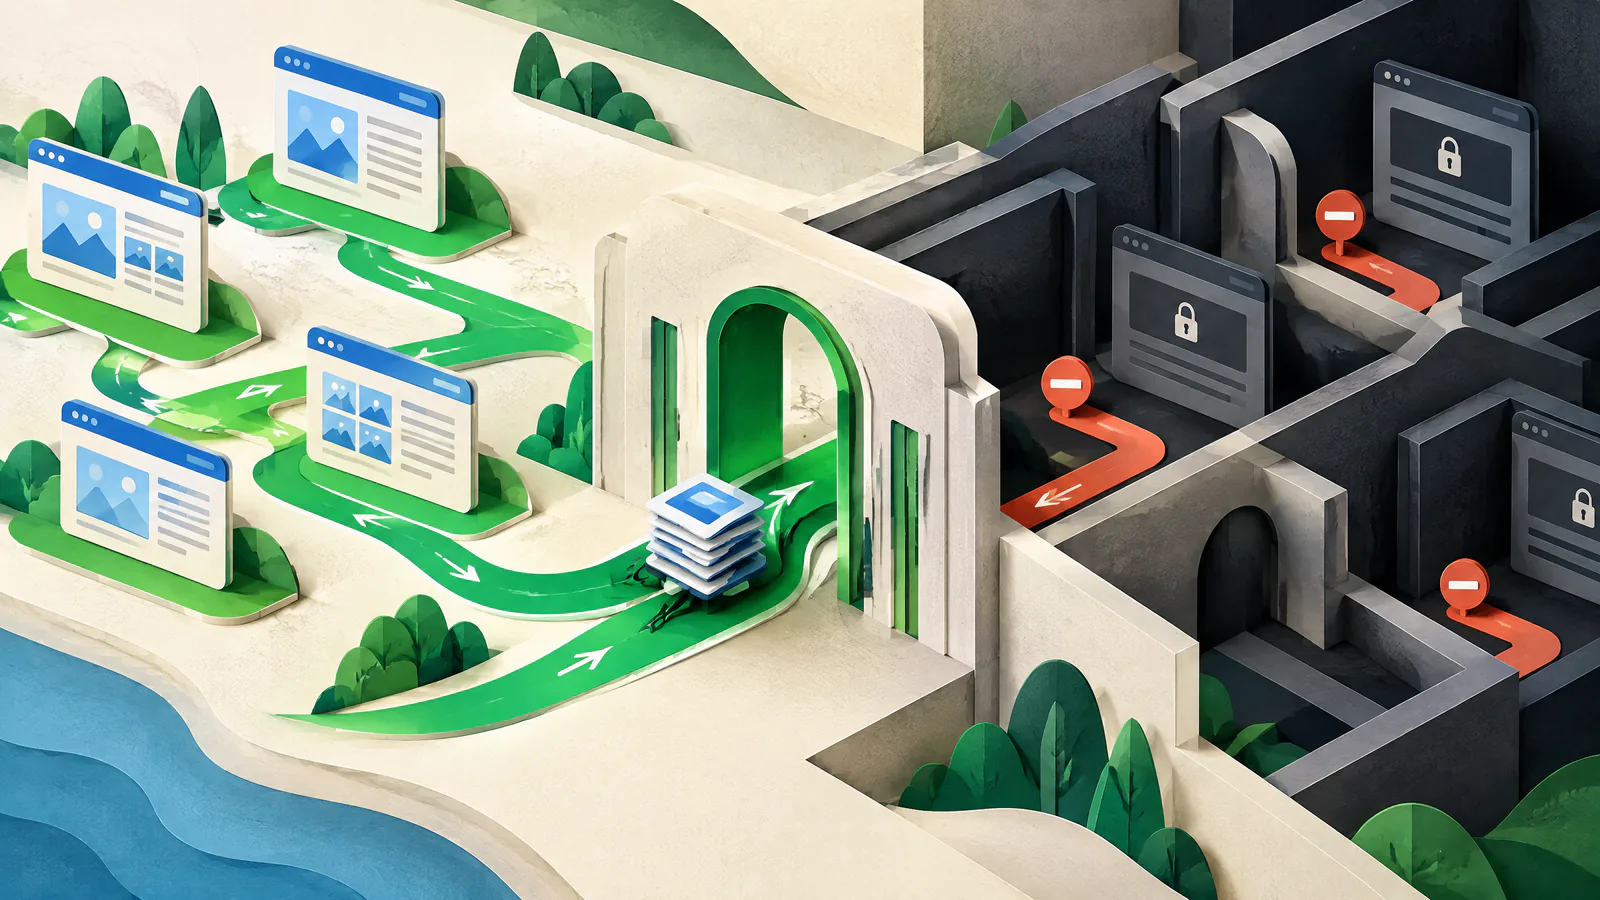
Usa robots.txt per indirizzare l'accesso dei crawler, poi abbinalo al metodo di indicizzazione o controllo accessi giusto per lo scopo.

Guida robots.txt: gestire il crawling senza nascondere errori — GUIDA VISIVA
LEGGI
8 minuti
FONTI
6
RIVALIDA
2027-03-27
rivisto
Revisore Technical SEO e piattaforma web; aggiungere revisione di sicurezza per decisioni su controllo accessi o contenuti sensibili.
LA RISPOSTA BREVE

Inizia dalla decisione.

Usa robots.txt per indirizzare i crawler conformi lontano da pattern di URL pubblici che creano lavoro di crawl non necessario. Pubblica un file di testo semplice UTF-8 alla radice dell'esatta origine del sito e parti con poche regole. È un segnale di accesso per i crawler, non una serratura, e non nasconde mai un errore.

Robots.txt non nasconde né protegge affidabilmente una pagina. Un URL bloccato può comunque essere scoperto tramite link. Per contenuti pubblici che non devono essere indicizzati, usa noindex lasciando il crawler in grado di recuperare la risposta. Per materiale privato, applica i controlli di accesso sul server o nell'applicazione.

Tratta le modifiche come configurazione di produzione: identifica l'origine, testa URL nominati, recupera il /robots.txt live e tieni pronta la versione precedente. SIU supporta disponibilità proattiva e rimedio tramite disciplina di preflight e rollback, non tramite allerte di outage o report di stato.

GUIDA VISIVA

Vedi il lavoro come un sistema.

Usa questa mappa per collegare le decisioni dell'articolo prima di agire su singole tattiche.

SIURafforza
01Scegli il controllo che corrisponde all'esito desiderato
02Usa la sintassi e l'ambito di base con precisione
03Blocca solo pattern supportati da evidenza sugli URL
04Mantieni coerenti sitemap, noindex e decisioni sulla privacy
01

Scegli il controllo che corrisponde all'esito desiderato

Il crawling è il recupero automatizzato di un URL. L'indicizzazione è la decisione di un motore di ricerca di memorizzare e mostrare informazioni su quell'URL. Il controllo accessi determina chi può ottenere il contenuto. Robots.txt riguarda il crawling e i crawler conformi scelgono se seguirlo. L'IETF Robots Exclusion Protocol afferma che non è autorizzazione.

Usa una regola Disallow per gestire l'accesso dei crawler a un percorso pubblico a basso valore, come una route di ricerca interna controllata. Usa noindex per contenuto pubblico che non dovrebbe apparire nei risultati supportati. Usa veri controlli di accesso per anteprime, aree con login, esportazioni o dati sensibili. Per informazioni di clienti, dipendenti, pagamenti o regolate, ottieni revisione qualificata di sicurezza e piattaforma; robots.txt non è mai un controllo compensativo.

Gestione del crawl

Robots.txt può chiedere ai crawler conformi di evitare un percorso pubblico definito; non garantisce la rimozione dai risultati.

Controllo dell'indice

Usa noindex in HTML o un header X-Robots-Tag, e lascia la risposta crawlable in modo che l'istruzione possa essere letta.

Contenuto privato

Richiedi autenticazione o un controllo appropriato a livello di applicazione o server, poi rimuovi l'URL dai percorsi di scoperta pubblica.

02

Usa la sintassi e l'ambito di base con precisione

Pubblica un robots.txt in testo semplice UTF-8 in /robots.txt per ogni schema, host e porta che richiede regole. Un file a https://www.example.com/robots.txt non governa automaticamente https://example.com, un sottodominio o un'origine HTTP. Verifica le origini servite dagli URL canonici, redirect, CDN e applicazione prima di presumere che una regola si applichi.

Un gruppo inizia con User-agent e poi usa Allow o Disallow sui path. User-agent: * è il gruppo generale. Il matching è case-sensitive e parte dall'inizio del path. La regola più specifica vince; un Allow ugualmente specifico dovrebbe prevalere su Disallow. Disallow: non blocca nulla, mentre Disallow: / blocca l'intera origine. Lo standard definisce # per i commenti, * per il wildcard e $ per la fine di un pattern.

Baseline più piccola

Se non esiste un bisogno documentato di gestione del crawl, non aggiungere esclusioni; non creare blocchi speculativi.

Pattern sicuro

Preferisci un prefisso stabile e stretto come /search/ a un wildcard generico o a una regola di filename non spiegata.

Commenti

Registra lo scopo della regola, il proprietario e il riferimento alla modifica, ma non trattare i commenti come sostituto della revisione.

03

Blocca solo pattern supportati da evidenza sugli URL

Prima di scrivere una regola, inventaria le pagine importanti, i percorsi di crawl indesiderati, le varianti di query, la ricerca on-site, le route di anteprima, le risorse e gli URL delle sitemap. Per ogni URL di esempio registra il risultato atteso e la regola corrispondente. Confronta l'elenco con gli URL canonici e la navigazione live in modo che un blocco non nasconda una route utile.

Mantieni disponibili le risorse critiche per il browser a meno che non sia stato testato il contrario. Google avverte che bloccare CSS, JavaScript, immagini o altre risorse può rendere una pagina più difficile da analizzare. Robots.txt non risolve la selezione del contenuto duplicato, l'autorizzazione o la qualità della pagina; usa canonicalizzazione, redirect, controlli di accesso o lavoro sul contenuto dove appropriato.

Evidenza prima di tutto

Usa campioni reali di URL e evidenza del server o del crawl, non una lista generica copiata da un altro sito.

Tabella delle modifiche

Tieni per ogni esempio l'URL campione, il risultato previsto, la regola abbinata e il proprietario responsabile nel record di rilascio.

04

Mantieni coerenti sitemap, noindex e decisioni sulla privacy

Una sitemap dice ai motori di ricerca quali URL e file consideri importanti; può aiutare la scoperta ma non garantisce crawling o indicizzazione. Forti link interni sono comunque importanti. Puoi aggiungere un URL Sitemap completamente qualificato in robots.txt, ma non inserire URL privati, redirectati, bloccati da robots o intenzionalmente noindex. Riconcilia l'output della sitemap con le regole robots al rilascio.

Noindex non è una direttiva di robots.txt per Google. Google la supporta in un meta tag HTML o nell'header di risposta HTTP X-Robots-Tag, e deve poter effettuare il crawl della risposta per vederla. Se una pagina pubblica deve uscire dai risultati Google, rimuovi qualsiasi blocco robots che nasconde il noindex. Se il contenuto è non pubblico, non pubblicizzare il suo percorso in robots.txt; applica il controllo di accesso. I confini sui dati sensibili richiedono revisione qualificata.

Dichiarazione della sitemap

Usa un URL completo, per esempio Sitemap: https://www.example.com/sitemap.xml; non sovrascrive un blocco di crawling.

HTML e file

Usa un meta noindex per l'HTML o un header X-Robots-Tag: noindex nella risposta HTTP quando adatto, poi testa la risposta live.

Esposizione urgente

Restringi prima l'accesso quando il contenuto è sensibile, poi usa il processo di rimozione del motore di ricerca se appropriato.

05

Testalo e rilascialo come un file di configurazione critico

Valida il testo approvato in locale, poi testa esempi consentiti e bloccati per il gruppo di crawler previsto. Dopo il deployment, recupera il /robots.txt pubblico in privato o tramite richiesta HTTP diretta per confermare contenuto, origine e stato della risposta. Google offre un report robots.txt in Search Console per file accessibili e una libreria parser open-source per test locali.

I crawler possono memorizzare nella cache i file robots, quindi non promettere cambiamenti immediati di discovery o indicizzazione. Errori di server o di rete portano i crawler ad assumere disallow completo, mentre un 4xx può permettere l'accesso. Tieni il file sotto controllo di versione, richiedi revisione extra per modifiche che coinvolgono l'intero sito o wildcard, e conserva la versione precedente. I preflight e la pianificazione di rollback di SIU aiutano a intercettare un rilascio sbagliato prima che diventi un problema più esteso di disponibilità o discoverability.

Gate di rilascio

Richiedi un secondo revisore per migrazioni di origine, blocchi sull'intero sito, wildcard e cambi che interessano route di login, checkout o supporto.

Segnale di rollback

Ripristina la versione precedente quando un URL campione importante viene appena bloccato, una risorsa necessaria è inaccessibile o l'endpoint non è disponibile.

Limite

Un singolo test crawler non prova che ogni client automatizzato interpreti ogni regola allo stesso modo.

AZIONE / VERIFICA

La tua guida pratica alle attività.

  1. 01

    Classifica l'obiettivo

    Scegli gestione del crawl, esclusione dall'indice o accesso privato prima di selezionare un controllo.

    VERIFICA: Ogni URL interessato ha uno scopo documentato e un proprietario responsabile.
  2. 02

    Mappa l'origine

    Identifica il protocollo esatto, host, porta, sottodominio, CDN e origine dell'app coinvolti.

    VERIFICA: Nessuna origine è assunta come erede delle regole robots di un'altra origine.
  3. 03

    Elenca URL rappresentativi

    Includi pagine importanti, target, varianti, risorse, voci di sitemap e route private.

    VERIFICA: Una tabella nomina il risultato atteso per ogni URL di test.
  4. 04

    Scrivi regole strette

    Usa chiari User-agent, Allow e Disallow sui path; evita wildcard ampi a meno che non siano necessari.

    VERIFICA: Un revisore può spiegare l'ambito e le eccezioni di ogni regola.
  5. 05

    Implementa correttamente noindex

    Usa un meta tag o un header di risposta per contenuto pubblico escluso da Google.

    VERIFICA: L'obiettivo live è crawlable ed espone noindex al crawler.
  6. 06

    Proteggi il materiale non pubblico

    Usa autenticazione o controlli di server e applicazione, non robots.txt.

    VERIFICA: Una richiesta non autenticata non può ottenere contenuto sensibile.
  7. 07

    Pubblica il file approvato

    Deploya testo semplice UTF-8 nella root dell'origine.

    VERIFICA: L'URL live /robots.txt restituisce il file revisionato.
  8. 08

    Testa il comportamento live

    Controlla esempi consentiti e bloccati con gli strumenti appropriati.

    VERIFICA: I risultati corrispondono alla tabella di rilascio, incluse le eccezioni.
  9. 09

    Riconcilia gli input di discovery

    Mantieni sitemap e link interni coerenti con le decisioni di crawl e indice.

    VERIFICA: Nessun URL intenzionalmente privato, redirectato, noindex o bloccato è nella sitemap senza una ragione.
  10. 10

    Tieni pronto il rollback

    Conserva il file precedente e aggiungi la modifica della regola alle procedure di lancio e recovery.

    VERIFICA: Una versione nota-good e un owner di rollback sono immediatamente identificabili.
ARGOMENTI DI DISCUSSIONE

Confronta i compromessi, non i dati privati.

Usa questi spunti con il tuo team o la community dei proprietari di siti. Condividi metodi e lezioni, ma non incollare mai credenziali, dati dei clienti o dettagli infrastrutturali non pubblici.

  1. 01

    Quali pattern di URL pubblici creano lavoro di crawler sul tuo sito, e quale evidenza ti ha aiutato a distinguere un problema reale da una variazione innocua?

  2. 02

    Come rivede il tuo team una modifica a robots.txt insieme a sitemap, canonical e decisioni di controllo accessi prima di un lancio?

  3. 03

    Quale segnale di rollback direbbe al tuo team che una nuova regola per i crawler sta danneggiando un percorso utente o aziendale importante?

RISORSE POPOLARI / AUTOREVOLI

Apri il materiale di riferimento.

Google Search CentralIntroduction to robots.txt ↗

Spiega l'uso previsto da Google, i limiti nei risultati di ricerca e i limiti di sicurezza per robots.txt.

Rivisto 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

La referenza standard-track per sintassi, matching, ambito, errori, caching e limiti di sicurezza.

Rivisto 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Mostra l'uso del meta-tag noindex e dell'header HTTP e perché la risposta deve rimanere crawlable.

Rivisto 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Tratta il posizionamento, la sintassi supportata, le dichiarazioni sitemap e le opzioni di test.

Rivisto 2026-09-27
Google Search CentralLearn about sitemaps ↗

Chiarisce i benefici e i limiti della scoperta tramite sitemap e l'importanza dei link interni.

Rivisto 2026-09-27
MDN Web DocsHTTP authentication ↗

Una panoramica dei controlli di accesso HTTP e delle considerazioni HTTPS per l'autenticazione.

Rivisto 2026-09-27

Politica delle fonti. Questo articolo usa standard primari e documentazione ufficiale linkati. Verifica la configurazione specifica del prodotto rispetto alla documentazione della piattaforma corrente prima del rilascio.

Chiarimenti rapidi

Domande comuni.

Robots.txt può tenere una pagina fuori da Google Search?

No. Un URL bloccato può comunque essere scoperto e comparire nei risultati. Usa noindex crawlable per contenuto pubblico che non deve essere indicizzato, e usa il controllo accessi per contenuto privato.

Qual è il file robots.txt di partenza più sicuro?

Inizia senza esclusioni a meno che tu non possa documentare un bisogno di gestione del crawl. Aggiungi solo path stretti che hai testato rispetto a pagine e risorse importanti.

Una sitemap dovrebbe essere elencata in robots.txt?

Può esserlo. Una linea Sitemap completamente qualificata aiuta la scoperta dei crawler ma non forza crawling o indicizzazione, e non sovrascrive un blocco robots.

Status Is UP Editorial Team · Uptime Enablement Editors

Revisionato da Revisore Technical SEO e piattaforma web; aggiungere revisione di sicurezza per decisioni su controllo accessi o contenuti sensibili.. Pubblicato 2026-09-27; aggiornato 2026-09-30.