
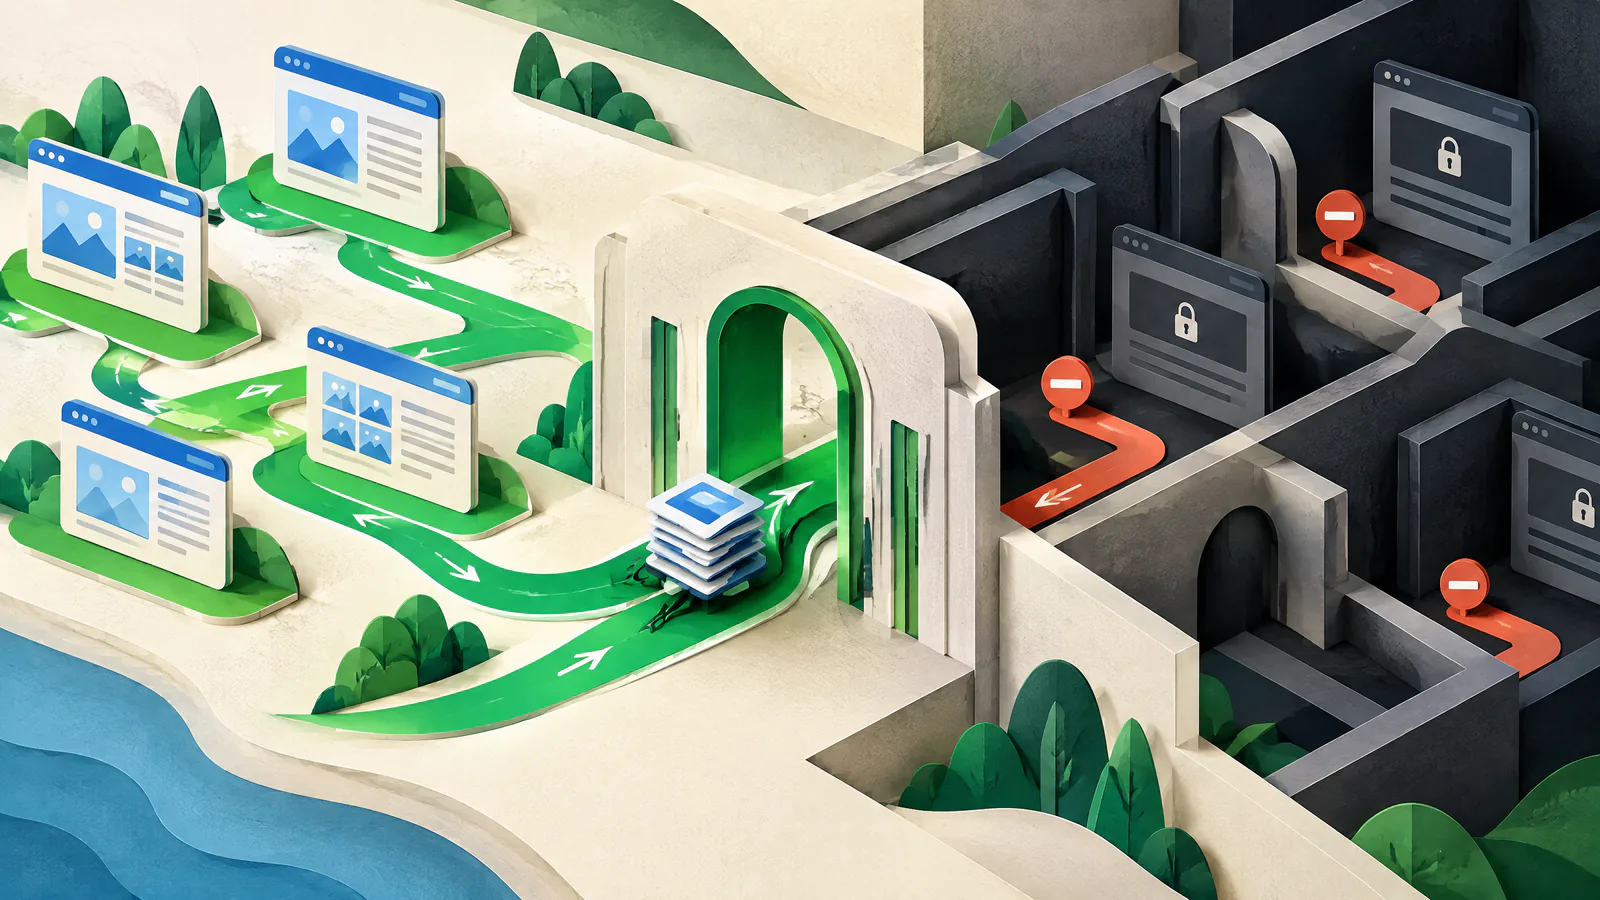
目的に合った制御手段を選ぶ
クロールは URL の自動取得を指し、インデックス登録は検索エンジンが情報を保存・表示するかの判断です。アクセス制御は誰がコンテンツを取得できるかを決めます。robots.txt はクロールに関するもので、準拠するクローラーが従うかどうかを選択します。IETF の Robots Exclusion Protocol は認可(authorization)ではないと明言しています。
公開されている低価値パス(例えば制御されたサイト内検索ルート)に対しては Disallow ルールでクロール管理を行います。公開コンテンツで検索結果に出したくない場合は noindex を使います。プレビュー、アカウント領域、エクスポート、機密データなどは実際の認証やサーバー/アプリケーションのアクセス制御を適用してください。顧客情報、従業員データ、支払い情報、規制対象データについては適格なセキュリティとプラットフォームのレビューを受けてください。robots.txt は代替のセキュリティ対策にはなりません。
robots.txt は準拠クローラーに対して公開パスの回避を要求できますが、検索結果からの削除を保証するものではありません。
HTML の noindex や X-Robots-Tag ヘッダーを使い、指示を読み取ってもらうためにレスポンスはクロール可能なままにします。
プレビューや機密領域は認証やサーバー/アプリケーション制御を要求し、公開の発見経路から URL を除外してください。
基本構文と適用範囲を正確に使う
各スキーム、ホスト、ポートごとに /robots.txt を UTF-8 のプレーンテキストで公開してください。https://www.example.com/robots.txt にあるファイルが自動的に https://example.com やサブドメイン、HTTP オリジンを支配するわけではありません。正規 URL、リダイレクト、CDN、アプリケーションが提供するオリジンを確認してからルールの適用を想定してください。
グループは User-agent 行で開始し、その後に Allow または Disallow のパスを並べます。一般グループは User-agent: * です。マッチは大文字小文字を区別し、パスの先頭から行われます。最も具体的にマッチするルールが優先され、同等の具体性の Allow がある場合は Disallow より Allow が勝つべきです。"Disallow:"(空の値)は何もブロックしない一方で、"Disallow: /" はオリジン全体をブロックします。標準では # をコメント、* をワイルドカード、$ をパターン末尾示唆に使います。
クロール管理の必要性が文書化されていないなら除外を追加しないでください。推測によるブロックは避けます。
緩いワイルドカードや説明のないファイル名ルールより、/search/ のような安定して狭いプレフィックスを優先してください。
ルールの目的、オーナー、変更参照をコメントに記録してください。ただしコメントをレビューの代替にしてはいけません。
URL 証拠に基づくパターンのみをブロックする
ルールを書く前に、重要ページ、不要なクロール経路、クエリバリアント、サイト内検索、プレビュールート、アセット、サイトマップの URL を棚卸ししてください。各サンプル URL について期待される結果と一致させるルールを記録します。リストを正規 URL やライブナビゲーションと比較して、ブロックが有用な経路を隠していないか確認してください。
ブラウザにとって重要なリソースは、別途テストで問題がないことを確認するまでは公開しておいてください。Google は CSS、JavaScript、画像などのブロックがページ解析を難しくすると注意を促しています。robots.txt は重複コンテンツの選択、認可、ページ品質の問題を解決しないため、適切な場合は正規化、リダイレクト、アクセス制御、コンテンツの改善を検討してください。
他サイトからコピーした一般リストではなく、実際の URL サンプルとサーバーやクロールの証拠を使って判断してください。
各サンプル URL、意図する結果、マッチしたルール、責任者をリリース記録に残してください。
サイトマップ、noindex、プライバシー判断を整合させる
サイトマップは検索エンジンにとって重要と考える URL やファイルを伝えるもので、発見を助けますがクロールやインデックスを保証するものではありません。内部リンクの強さは依然として重要です。robots.txt に完全修飾の Sitemap URL を追加できますが、プライベート、リダイレクト、robots でブロックされた、または意図的に noindex の URL を列挙しないでください。リリース時にサイトマップ出力と robots ルールを照合してください。
noindex は Google の robots.txt ディレクティブではありません。Google は HTML の meta タグや X-Robots-Tag HTTP レスポンスヘッダーでの noindex をサポートしており、それを確認するためにレスポンスをクロールする必要があります。Google の検索結果から公開ページを除外したい場合は、noindex を見せる前に robots ブロックで隠さないでください。非公開のコンテンツは robots.txt でパスを広告せず、アクセス制御を適用してください。機密データ境界については適格なレビューが必要です。
例:Sitemap: https://www.example.com/sitemap.xml のように完全修飾 URL を使ってください。これはクロールブロックを上書きしません。
HTML には meta noindex、ファイルや非HTML には X-Robots-Tag: noindex レスポンスヘッダーを使い、ライブレスポンスで検証してください。
コンテンツが機密性を帯びる場合はまずアクセスを制限し、その後必要に応じて検索エンジンの削除手続きなどを利用してください。
重要な構成ファイルとしてテストしてリリースする
承認済みのテキストをローカルで検証し、許可・不許可のサンプルを対象クローラーでテストしてください。デプロイ後はプライベートに、または直接 HTTP リクエストで公開された /robots.txt を取得して内容、オリジン、HTTP ステータスを確認します。Google は Search Console の robots.txt レポートや、ローカルテスト用のオープンソースパーサーを提供しています。
クローラーは robots ファイルをキャッシュするため、即時に変更が反映されるとは限りません。サーバーやネットワークエラーがあるとクローラーは完全な拒否と判断する場合があり、4xx はアクセスを許可する挙動を招くこともあります。ファイルをソース管理された設定として保持し、サイト全体ブロックやワイルドカード変更には追加のレビューを要求し、前のバージョンを保存してください。SIU の事前検証(preflight)とロールバック計画は、悪いリリースが可用性や発見性の大きな問題になる前に検出するのに役立ちます。
オリジン移行、サイト全体ブロック、ワイルドカード、サインインやチェックアウト、サポートルートに影響する変更には二次レビュワーを要求してください。
重要なサンプル URL が新たにブロックされた、必要なアセットにアクセスできない、またはエンドポイントが利用不能になった場合は前のバージョンに戻してください。
1 回のクローラーテストだけでは、すべての自動クライアントが同じようにルールを解釈することを証明するものではありません。