
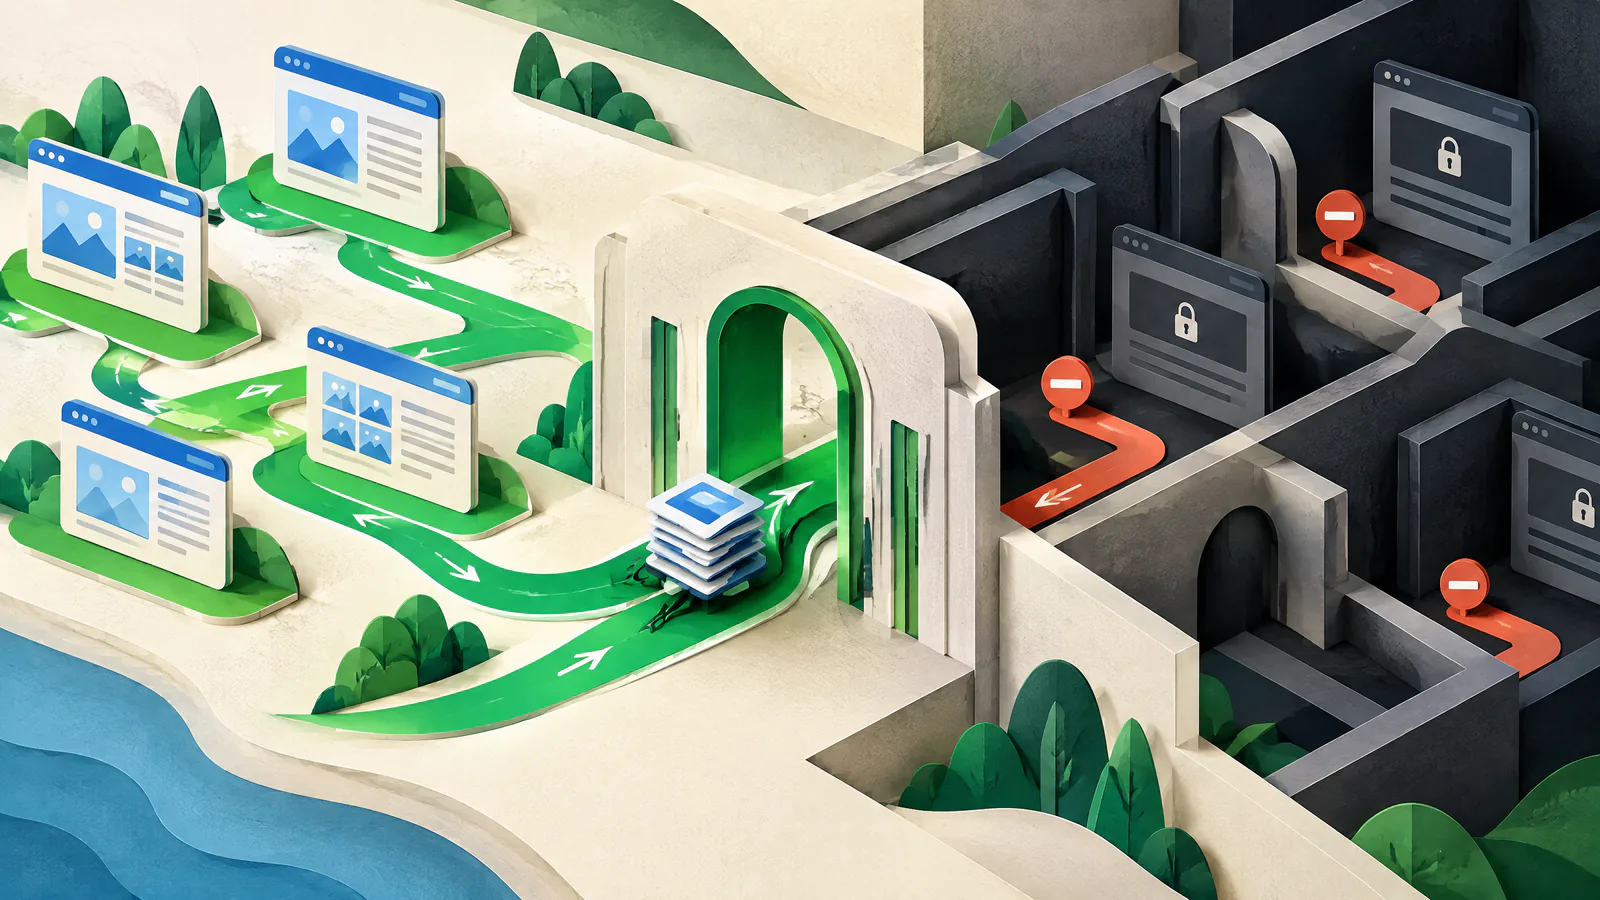
اختر التحكم الذي يتوافق مع النتيجة
الزحف (Crawling) هو الاسترجاع الآلي لعنوان URL. الفهرسة (Indexing) هي قرار محرك البحث بتخزين وعرض معلومات عنه أم لا. التحكم في الوصول يحدد من يمكنه الحصول على المحتوى. ملف robots.txt يتعلق بالزحف، والزواحف الملتزمة تقرر ما إذا كانت ستتبع قواعده. توضح بروتوكولات IETF Robots Exclusion أن robots.txt ليست وسيلة تفويض (authorization).
استخدم قاعدة Disallow لإدارة وصول الزواحف إلى مسار عام منخفض القيمة، مثل مسار بحث داخلي مُتحكم به. استخدم noindex للمحتوى العام الذي لا ينبغي ظهوره في نتائج البحث المدعومة. استخدم ضوابط وصول حقيقية للمعاينات، ومناطق الحساب، والتصديرات، أو البيانات الحساسة. للمعلومات المتعلقة بالعملاء أو الموظفين أو المدفوعات أو المعلومات المنظمة، احصل على مراجعة مؤهلة للأمن والمنصة؛ robots.txt ليست أبدًا ضابطًا تعويضيًا.
يمكن لملف Robots.txt أن يطلب من الزواحف الملتزمة تجنب مسار عام محدد؛ لكنه لا يضمن إزالة ذلك من النتائج.
استخدم noindex في HTML أو في رأس استجابة X-Robots-Tag، واترك الرد قابلاً للزحف حتى يمكن قراءة التعليمة.
تطلب المصادقة أو ضابط تطبيق/خادم مناسب، ثم أزل عنوان URL من مسارات الاكتشاف العامة.
استخدم الصياغة الأساسية والنطاق بدقة
انشر ملف robots.txt نصي عادي UTF-8 في /robots.txt لكل مخطط (scheme) ومضيف (host) ومنفذ (port) يحتاج إلى قواعد. ملف في https://www.example.com/robots.txt لا يحكم تلقائيًا https://example.com أو نطاقًا فرعيًا أو أصل HTTP مختلف. تحقق من الأصول التي تقدمها عناوين URL المعيارية (canonical)، وإعادات التوجيه، وCDN، والتطبيق قبل افتراض أن القاعدة تنطبق.
تبدأ مجموعة بقسم User-agent ثم تستخدم مسارات Allow أو Disallow. User-agent: * هي المجموعة العامة. المطابقة حساسة لحالة الحروف وتبدأ من بداية المسار. القاعدة الأكثر تحديدًا هي التي تُطبق؛ وإذا كانت قاعدة Allow بنفس مستوى التحديد فيجب أن تتغلب على Disallow. Disallow: لا يمنع شيئًا، بينما Disallow: / يمنع الأصل بأكمله. يحدد المعيار # للتعليقات، و* للبلاييند (wildcard)، و$ لنهاية النمط.
إذا لم تكن هناك حاجة موثقة لإدارة الزحف، أضف عدم استثناءات؛ لا تنشئ حظرًا تكهنيًا.
أفضّل بادئة ثابتة ومحصورة مثل /search/ على استخدام بدل واسع أو قاعدة اسم ملف غير مبررة.
سجل غرض القاعدة، والمالك، ومرجع التغيير، لكن لا تعامل التعليقات كبديل للمراجعة.
احظر الأنماط المدعومة بأدلة URL فقط
قبل كتابة قاعدة، قم بجرد الصفحات المهمة، ومسارات الزحف غير المرغوبة، ومتغيرات الاستعلام، والبحث داخل الموقع، ومسارات المعاينة، والموجودات (assets)، وعناوين خريطة الموقع. لكل مثال URL، سجّل النتيجة المتوقعة والقاعدة المطابقة. قارن القائمة بعناوين URL المعيارية (canonical) والتصفح الحي حتى لا يخفي الحظر مسارًا مفيدًا.
احتفظ بالموارد الضرورية للمتصفح متاحة ما لم تختبر خلاف ذلك. تحذر Google من أن حظر CSS أو JavaScript أو الصور أو الموارد الأخرى يمكن أن يجعل صفحة أصعب على التحليل. robots.txt لا يحل اختيار المحتوى المكرر، أو التفويض، أو جودة الصفحة؛ استخدم التقييس (canonicalization)، أو إعادة التوجيه، أو ضوابط الوصول، أو عمل المحتوى حيثما كان مناسبًا.
استخدم عينات URL حقيقية وأدلة من الخادم أو الزحف، لا قائمة عامة منسوخة من موقع آخر.
احتفظ بكل عنوان URL نموذجي، والنتيجة المقصودة، والقاعدة المتطابقة، والمالك المسؤول في سجل الإصدار.
حافظ على اتساق اكتشاف خريطة الموقع وnoindex وقرارات الخصوصية
تخبر خريطة الموقع محركات البحث بعناوين URL والملفات التي تعتبرها مهمة؛ يمكن أن تساعد في الاكتشاف لكنها لا تضمن الزحف أو الفهرسة. الروابط الداخلية القوية لا تزال مهمة. يمكنك إضافة عنوان Sitemap مؤهل بالكامل في robots.txt، لكن لا تدرج عناوين URL خاصة أو محالة أو محجوبة بقاعدة robots، أو عناوين مقصودة بـ noindex. صلِح إخراج خريطة الموقع مع قواعد robots عند الإصدار.
noindex ليست توجيهًا في robots.txt بالنسبة إلى Google. تدعم Google ذلك في وسم meta داخل HTML أو في رأس استجابة HTTP X-Robots-Tag، ويجب أن تزحف إلى الاستجابة لرؤيته. إذا كانت صفحة عامة بحاجة إلى الخروج من نتائج Google، أزل أي حظر robots يخفي noindex. إذا كان المحتوى غير عام، فلا تروّج لمساره في robots.txt؛ طبق ضوابط الوصول. حدود البيانات الحساسة تتطلب مراجعة مؤهلة.
استخدم عنوانًا كاملاً، على سبيل المثال Sitemap: https://www.example.com/sitemap.xml؛ هذا لا يلغي حظر الزحف.
استخدم meta noindex للـ HTML أو رأس استجابة X-Robots-Tag: noindex حيثما كان مناسبًا، ثم اختبر الاستجابة الحية.
قيد الوصول أولًا عندما يكون المحتوى حساسًا، ثم استخدم عملية الإزالة الخاصة بمحرك البحث حيثما كان مناسبًا.
اختبر وأصدره مثل ملف إعدادات حرج
تحقق من النص المعتمد محليًا، ثم اختبر أمثلة مسموح بها وممنوعة للمجموعة المستهدفة من الزواحف. بعد النشر، استرجع /robots.txt العام بشكل خاص أو عبر طلب HTTP مباشر لتأكيد المحتوى والأصل وحالة الاستجابة. تقدم Google تقريرًا عن robots.txt في Search Console للملفات المتاحة ومكتبة محلل مفتوحة المصدر للاختبار المحلي.
يمكن للزواحف تخزين ملفات robots في ذاكرة مؤقتة، لذلك لا تعد بالاكتشاف الفوري أو تغييرات الفهرسة. تؤدي أخطاء الخادم أو الشبكة إلى افتراض الزواحف منعًا كاملاً، بينما قد تسمح استجابة 4xx بالوصول. احتفظ بالملف في إعدادات خاضعة لتحكم المصدر، واطلب مراجعة إضافية للتغييرات التي تؤثر على الموقع بأكمله أو تستخدم بدلًا واسعًا، واحتفظ بالإصدار السابق. تساعد اختبارات SIU المسبقة وخطط التراجع في اكتشاف إصدار سيئ قبل أن يتحول إلى مشكلة أكبر في التوفر أو القابلية للاكتشاف.
اشترط وجود مراجع ثانٍ لترحيلات الأصول، وحظر الموقع بأكمله، والبدائل العامة، والتغييرات التي تؤثر على تسجيل الدخول أو الدفع أو مسارات الدعم.
استعد الإصدار السابق عندما يتم حظر عنوان URL نموذجي مهم حديثًا، أو يصبح أصل ضروري غير متاح، أو يكون الطرف النهائي غير متاح.
اختبار زاحف واحد لا يثبت أن كل عميل آلي يفسر كل قاعدة بنفس الطريقة.