
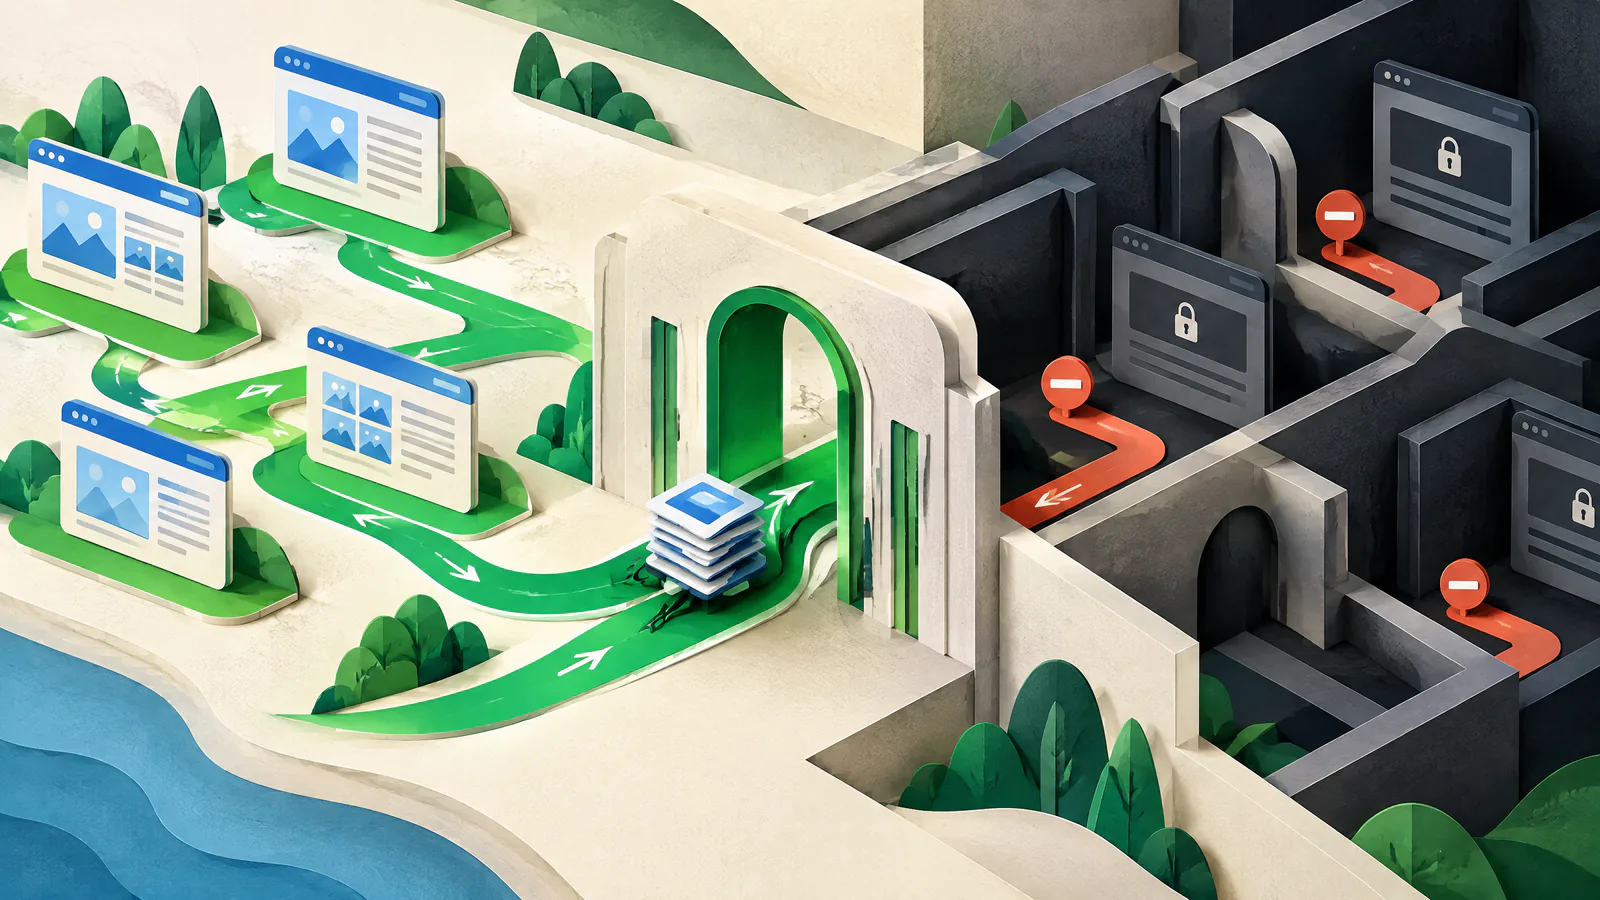
Chọn phương pháp kiểm soát phù hợp với kết quả mong muốn
Thu thập (crawling) là việc tự động lấy một URL. Lập chỉ mục (indexing) là quyết định của công cụ tìm kiếm về việc lưu trữ và hiển thị thông tin về URL đó. Kiểm soát truy cập quyết định ai có thể lấy nội dung. Robots.txt liên quan đến thu thập, và các crawler tuân thủ sẽ quyết định có theo hay không. IETF Robots Exclusion Protocol quy định đây không phải là ủy quyền (authorization).
Dùng quy tắc Disallow để quản lý truy cập của crawler tới một đường dẫn công khai có giá trị thấp, chẳng hạn route tìm kiếm nội bộ. Dùng noindex cho nội dung công khai không muốn xuất hiện trong kết quả hỗ trợ. Dùng kiểm soát truy cập thực sự cho bản xem trước, khu vực cần đăng nhập, export hoặc dữ liệu nhạy cảm. Với thông tin khách hàng, nhân viên, thanh toán hoặc được điều chỉnh, cần có đánh giá bảo mật và nền tảng; robots.txt không bao giờ là biện pháp bù trừ.
Robots.txt có thể yêu cầu các crawler tuân thủ tránh một đường dẫn công khai xác định; nó không đảm bảo loại khỏi kết quả.
Dùng noindex trong HTML hoặc header X-Robots-Tag, và để phản hồi có thể được crawl để chỉ thị có thể được đọc.
Yêu cầu xác thực hoặc kiểm soát phù hợp ở ứng dụng hoặc server, rồi loại URL khỏi các đường dẫn có thể phát hiện công khai.
Dùng cú pháp và phạm vi cơ bản một cách chính xác
Công bố tệp robots.txt văn bản thuần UTF-8 tại /robots.txt cho mỗi scheme, host, và port cần quy tắc. Một tệp tại https://www.example.com/robots.txt không tự động điều chỉnh https://example.com, một subdomain, hay origin HTTP. Xác minh các origin được phục vụ bởi URL chuẩn (canonical), redirect, CDN và ứng dụng trước khi giả định quy tắc áp dụng.
Một group bắt đầu bằng User-agent và sau đó dùng Allow hoặc Disallow với các path. User-agent: * là nhóm chung. Việc so khớp phân biệt chữ hoa thường và bắt đầu từ đầu path. Quy tắc khớp cụ thể nhất sẽ thắng; một Allow có mức độ cụ thể bằng Disallow nên thắng. Disallow: không chặn gì, trong khi Disallow: / chặn toàn bộ origin. Tiêu chuẩn định nghĩa # cho chú thích, * cho wildcard, và $ cho cuối mẫu.
Nếu không có nhu cầu quản lý crawl được ghi nhận, không thêm loại trừ; đừng tạo chặn mang tính suy đoán.
Ưu tiên tiền tố ổn định, hẹp như /search/ thay vì wildcard lỏng lẻo hoặc quy tắc tên tệp không rõ ràng.
Ghi lại mục đích quy tắc, chủ sở hữu và tham chiếu thay đổi, nhưng đừng coi chú thích thay cho quy trình xem xét.
Chỉ chặn các mẫu được hỗ trợ bởi bằng chứng URL
Trước khi viết quy tắc, lập danh mục các trang quan trọng, đường dẫn thu thập không mong muốn, biến thể query, tìm kiếm nội bộ, route xem trước, tài nguyên, và URL sitemap. Với mỗi URL mẫu, ghi kết quả mong đợi và quy tắc khớp. So sánh danh sách với URL chuẩn và điều hướng trực tiếp để chặn không che giấu một route hữu ích.
Giữ các tài nguyên quan trọng cho trình duyệt khả dụng trừ khi đã kiểm tra ngược lại. Google cảnh báo rằng chặn CSS, JavaScript, hình ảnh hoặc tài nguyên khác có thể làm một trang khó phân tích hơn. Robots.txt không giải quyết chọn lựa trùng lặp nội dung, ủy quyền, hay chất lượng trang; sử dụng canonicalization, redirects, kiểm soát truy cập, hoặc cải thiện nội dung khi thích hợp.
Dùng các mẫu URL thật và bằng chứng từ server hoặc crawl, không sao chép danh sách chung chung từ site khác.
Giữ mỗi URL mẫu, kết quả dự kiến, quy tắc khớp và chủ sở hữu có trách nhiệm trong hồ sơ phát hành.
Giữ nhất quán giữa việc công bố sitemap, noindex và quyết định về quyền riêng tư
Sitemap cho công cụ tìm kiếm biết các URL và tệp bạn coi là quan trọng; nó có thể giúp phát hiện nhưng không đảm bảo crawl hay lập chỉ mục. Liên kết nội bộ mạnh vẫn quan trọng. Bạn có thể thêm một URL Sitemap đầy đủ trong robots.txt, nhưng đừng liệt kê URL riêng tư, được redirect, bị chặn bởi robots, hoặc bị noindex cố ý. Điều chỉnh đầu ra sitemap với quy tắc robots khi phát hành.
Noindex không phải là chỉ thị robots.txt của Google. Google hỗ trợ nó trong thẻ meta HTML hoặc header HTTP X-Robots-Tag, và phải crawl phản hồi để thấy chỉ thị. Nếu một trang công khai cần rời khỏi kết quả Google, hãy bỏ chặn robots trước để noindex có thể được đọc. Nếu nội dung không công khai, đừng quảng cáo đường dẫn trong robots.txt; thực thi kiểm soát truy cập. Ranh giới dữ liệu nhạy cảm cần đánh giá chuyên môn.
Dùng một URL đầy đủ, ví dụ Sitemap: https://www.example.com/sitemap.xml; nó không ghi đè chặn crawl.
Dùng meta noindex cho HTML hoặc header X-Robots-Tag: noindex trong phản hồi khi phù hợp, rồi kiểm tra phản hồi trực tiếp.
Hạn chế truy cập trước khi khi nội dung nhạy cảm, rồi dùng quy trình gỡ bỏ của công cụ tìm kiếm nếu cần.
Kiểm tra và phát hành như một tệp cấu hình quan trọng
Xác thực văn bản đã duyệt ở môi trường local, rồi kiểm thử các ví dụ được phép và bị cấm cho nhóm crawler dự kiến. Sau triển khai, lấy /robots.txt công khai một cách riêng tư hoặc bằng yêu cầu HTTP trực tiếp để xác nhận nội dung, origin và mã trạng thái phản hồi. Google cung cấp báo cáo robots.txt trong Search Console cho các tệp có thể truy cập và một thư viện parser mã nguồn mở để kiểm thử cục bộ.
Crawlers có thể cache tệp robots, vì vậy đừng hứa hẹn thay đổi sẽ được áp dụng ngay lập tức. Lỗi server hoặc mạng khiến crawler giả định disallow toàn bộ, trong khi mã 4xx có thể cho phép truy cập. Giữ tệp trong source-controlled configuration, yêu cầu xem xét thêm cho các thay đổi chặn toàn site hoặc wildcard, và giữ lại phiên bản trước. SIU preflight và kế hoạch rollback giúp phát hiện lỗi phát hành trước khi nó trở thành vấn đề khả dụng hoặc khả năng phát hiện lớn hơn.
Yêu cầu người đánh giá thứ hai cho di chuyển origin, chặn toàn site, wildcard, và các thay đổi ảnh hưởng sign-in, checkout, hoặc route hỗ trợ.
Khôi phục phiên bản trước khi một URL mẫu quan trọng bị chặn mới, một tài nguyên cần thiết không truy cập được, hoặc endpoint không khả dụng.
Một lần kiểm tra crawler không chứng minh mọi client tự động sẽ diễn giải mọi quy tắc theo cùng một cách.