
STATUS IS UPWIKI DE OTIMIZAÇÃO DE SITES
32Fortalecer
SEO e descoberta / Fortalecer

Guia do robots.txt: controlar o rastreamento sem ocultar erros

Use o robots.txt para orientar o acesso de rastreadores e combine-o com o método correto de indexação ou controle de acesso para cada caso.

Guia do robots.txt: controlar o rastreamento sem ocultar erros — GUIA VISUAL
LER
8 minutos
FONTES
6
REVALIDAR
2027-03-27
revisado
Revisor técnico de SEO e plataforma web; adicione revisão de segurança para decisões de controle de acesso ou conteúdo sensível.
A RESPOSTA CURTA

Comece pela decisão.

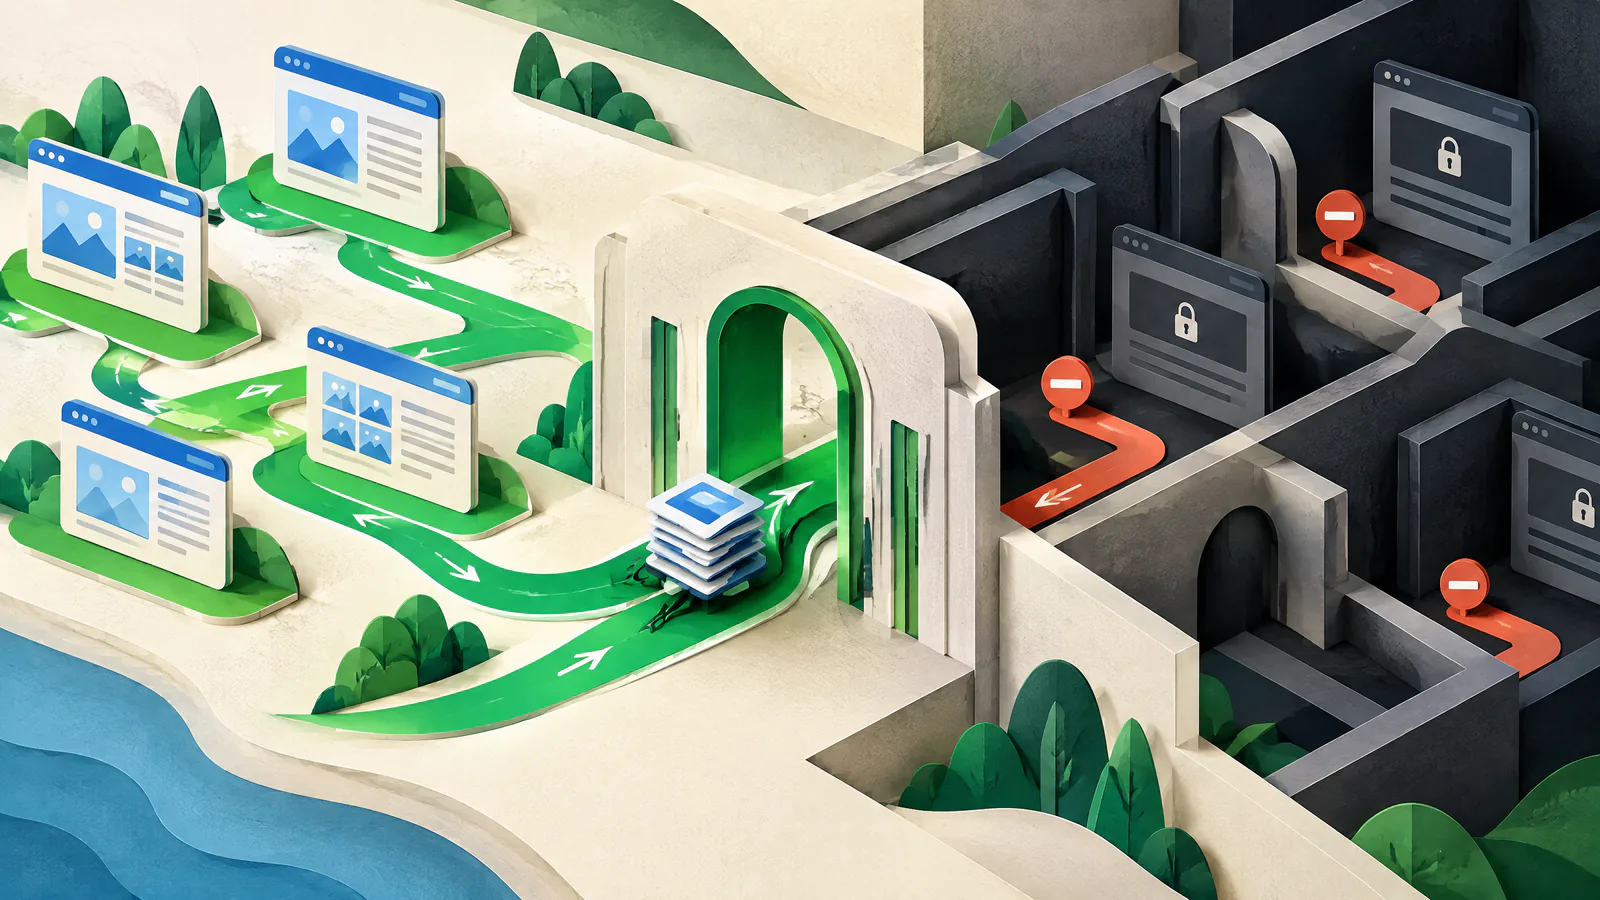
Use o robots.txt para orientar rastreadores compatíveis a evitar padrões públicos de URL específicos que geram trabalho de rastreamento desnecessário. Publique um arquivo de texto simples UTF-8 na raiz da origem exata do site e comece com poucas regras. É um sinal de acesso para rastreadores, não uma trava, e nunca oculta um erro.

Robots.txt não protege nem oculta uma página de forma confiável. Uma URL bloqueada ainda pode ser descoberta por links. Para conteúdo público que não deve ser indexado, use noindex permitindo que o rastreador obtenha a resposta. Para material privado, aplique controles de acesso no servidor ou na aplicação.

Trate edições como configuração de produção: identifique a origem, teste URLs nomeadas, recupere o /robots.txt ao vivo e mantenha a versão anterior disponível. SIU suporta disponibilidade proativa e remediação por meio de pré-verificação e disciplina de rollback, não por alertas de interrupção ou relatórios de status.

GUIA VISUAL

Veja o trabalho como um sistema.

Use este mapa para conectar as decisões do artigo antes de agir sobre táticas individuais.

SIUFortalecer
01Escolha o controle que produz o resultado desejado
02Use a sintaxe e o escopo básicos com precisão
03Bloqueie apenas padrões suportados por evidência de URL
04Mantenha sitemap, noindex e decisões de privacidade consistentes
01

Escolha o controle que produz o resultado desejado

Rastreamento é a recuperação automatizada de uma URL. Indexação é a decisão de um motor de busca de armazenar e mostrar informações sobre ela. Controle de acesso decide quem pode obter o conteúdo. Robots.txt trata do rastreamento, e rastreadores compatíveis escolhem se o seguem. O Robots Exclusion Protocol do IETF diz que não é autorização.

Use uma regra Disallow para gerenciar o acesso de rastreadores a um caminho público de baixo valor, como uma rota de busca interna controlada. Use noindex para conteúdo público que não deve aparecer em resultados suportados. Use controles reais de acesso para pré-visualizações, áreas de conta, exportações ou dados sensíveis. Para informações de clientes, funcionários, pagamento ou reguladas, obtenha revisão qualificada de segurança e plataforma; robots.txt nunca é um controle compensatório.

Gerenciamento de rastreamento

Robots.txt pode solicitar que rastreadores compatíveis evitem um caminho público definido; isso não garante remoção dos resultados.

Controle de indexação

Use noindex em HTML ou no cabeçalho HTTP X-Robots-Tag, e deixe a resposta rastreável para que a instrução possa ser lida.

Conteúdo privado

Exija autenticação ou um controle apropriado na aplicação ou no servidor e, então, remova a URL dos caminhos de descoberta pública.

02

Use a sintaxe e o escopo básicos com precisão

Publique texto simples UTF-8 em /robots.txt para cada esquema, host e porta que precisa de regras. Um arquivo em https://www.example.com/robots.txt não governa automaticamente https://example.com, um subdomínio ou uma origem HTTP. Verifique as origens servidas por URLs canônicos, redirecionamentos, CDN e aplicação antes de assumir que uma regra se aplica.

Um grupo começa com User-agent e depois usa Allow ou Disallow em caminhos. User-agent: * é o grupo geral. A correspondência é sensível a maiúsculas e minúsculas e começa no início do caminho. A regra mais específica que corresponder vence; um Allow igualmente específico deve vencer um Disallow. Disallow: (sem nada) não bloqueia nada, enquanto Disallow: / bloqueia toda a origem. O padrão define # para comentários, * para curinga e $ para o fim de um padrão.

Menor baseline

Se não houver necessidade documentada de gerenciamento de rastreamento, não adicione exclusões; não crie bloqueios especulativos.

Padrão seguro

Prefira um prefixo estável e estreito como /search/ em vez de um curinga amplo ou uma regra de nome de arquivo sem explicação.

Comentários

Registre o propósito da regra, o responsável e a referência de alteração, mas não trate comentários como substituto de revisão.

03

Bloqueie apenas padrões suportados por evidência de URL

Antes de escrever uma regra, inventarie páginas importantes, caminhos de rastreamento indesejados, variantes de query, busca no site, rotas de pré-visualização, assets e URLs do sitemap. Para cada URL de amostra, registre o resultado esperado e a regra que deve corresponder. Compare a lista com URLs canônicos e navegação ao vivo para que um bloqueio não esconda uma rota útil.

Mantenha recursos críticos para navegadores disponíveis, a menos que testado em contrário. O Google alerta que bloquear CSS, JavaScript, imagens ou outros recursos pode dificultar a análise de uma página. Robots.txt não resolve seleção de conteúdo duplicado, autorização ou qualidade de página; use canonicalização, redirecionamentos, controles de acesso ou trabalho de conteúdo onde for adequado.

Evidência primeiro

Use amostras reais de URL e evidência de servidor ou de rastreamento, não uma lista genérica copiada de outro site.

Tabela de mudanças

Mantenha cada URL de amostra, resultado pretendido, regra correspondente e proprietário responsável no registro de lançamento.

04

Mantenha sitemap, noindex e decisões de privacidade consistentes

Um sitemap informa aos motores de busca quais URLs e arquivos você considera importantes; ele pode ajudar a descoberta, mas não garante rastreamento ou indexação. Links internos fortes ainda importam. Você pode adicionar um Sitemap totalmente qualificado em robots.txt, mas não liste URLs privadas, redirecionadas, bloqueadas por robots ou intencionalmente com noindex. Reconciliar a saída do sitemap com as regras do robots durante o lançamento.

Noindex não é uma diretiva do robots.txt do Google. O Google suporta noindex em uma meta tag HTML ou no cabeçalho de resposta HTTP X-Robots-Tag, e deve rastrear a resposta para vê-la. Se uma página pública precisa sair dos resultados do Google, remova qualquer bloqueio de robots que esconda o noindex. Se o conteúdo for não público, não anuncie seu caminho em robots.txt; aplique controle de acesso. Limites de dados sensíveis exigem revisão qualificada.

Declaração de sitemap

Use uma URL completa, por exemplo Sitemap: https://www.example.com/sitemap.xml; isso não substitui um bloqueio de rastreamento.

HTML e arquivos

Use um meta noindex para HTML ou um cabeçalho de resposta X-Robots-Tag: noindex quando apropriado, depois teste a resposta ao vivo.

Exposição urgente

Restrinja o acesso primeiro quando o conteúdo for sensível, depois use o processo de remoção do motor de busca quando adequado.

05

Teste e libere como um arquivo de configuração crítico

Valide o texto aprovado localmente e depois teste exemplos permitidos e negados para o grupo de rastreadores pretendido. Após a implantação, recupere /robots.txt público de forma privada ou por requisição HTTP direta para confirmar o conteúdo, a origem e o status da resposta. O Google oferece um relatório de robots.txt no Search Console para arquivos acessíveis e uma biblioteca de parser open-source para testes locais.

Rastreadores podem cachear arquivos de robots, portanto não prometa descobertas ou mudanças de indexação imediatas. Erros de servidor ou rede levam rastreadores a assumir disallow completo, enquanto um 4xx pode permitir acesso. Mantenha o arquivo em controle de versão, exija revisão extra para mudanças de bloqueio em todo o site ou com curingas, e retenha a versão anterior. Pré-verificações e planejamento de rollback da SIU ajudam a detectar um lançamento ruim antes que vire um problema maior de disponibilidade ou descoberta.

Portão de liberação

Exija um segundo revisor para migrações de origem, bloqueios em todo o site, curingas e mudanças que afetem rotas de login, checkout ou suporte.

Sinal de rollback

Restaure a versão anterior quando uma URL de amostra importante for recém-bloqueada, um asset necessário ficar inacessível ou o endpoint ficar indisponível.

Limitação

Um teste de rastreador não prova que todo cliente automatizado interpreta cada regra da mesma forma.

AÇÃO / VERIFICAR

Seu guia prático de tarefas.

  1. 01

    Classificar o objetivo

    Escolha gerenciamento de rastreamento, exclusão de indexação ou acesso privado antes de selecionar um controle.

    VERIFICAR: Cada URL afetada tem um propósito documentado e um responsável.
  2. 02

    Mapear a origem

    Identifique o protocolo exato, host, porta, subdomínio, CDN e origem da aplicação envolvidos.

    VERIFICAR: Nenhuma origem é assumida como herdando regras robots de outra origem.
  3. 03

    Listar URLs representativas

    Inclua páginas importantes, alvos, variantes, assets, entradas do sitemap e rotas privadas.

    VERIFICAR: Uma tabela nomeia o resultado esperado para cada URL de teste.
  4. 04

    Escrever regras estreitas

    Use User-agent, Allow e Disallow claros; evite curingas amplos salvo quando necessário.

    VERIFICAR: Um revisor consegue explicar o escopo e as exceções de cada regra.
  5. 05

    Implementar noindex corretamente

    Use uma meta tag ou cabeçalho de resposta para conteúdo público excluído do Google.

    VERIFICAR: O alvo ao vivo é rastreável e expõe o noindex ao rastreador.
  6. 06

    Proteger material não público

    Use autenticação ou controles de servidor e aplicação, não robots.txt.

    VERIFICAR: Uma requisição não autenticada não obtém conteúdo sensível.
  7. 07

    Publicar o arquivo aprovado

    Implemente texto simples UTF-8 na raiz da origem.

    VERIFICAR: A URL /robots.txt ao vivo retorna o arquivo revisado.
  8. 08

    Testar o comportamento ao vivo

    Verifique amostras permitidas e bloqueadas com ferramentas apropriadas.

    VERIFICAR: Resultados correspondem à tabela de lançamento, incluindo exceções.
  9. 09

    Reconciliar entradas de descoberta

    Mantenha sitemap e alvos de links internos consistentes com decisões de rastreamento e indexação.

    VERIFICAR: Nenhuma URL intencionalmente privada, redirecionada, com noindex ou bloqueada está no sitemap sem motivo.
  10. 10

    Manter rollback pronto

    Armazene o arquivo anterior e adicione a mudança de regra aos procedimentos de lançamento e recuperação.

    VERIFICAR: Uma versão conhecida e boa e um responsável pelo rollback são identificáveis imediatamente.
TÓPICOS DE DISCUSSÃO

Compare as compensações, não dados privados.

Use essas sugestões com sua equipe ou comunidade de proprietários de sites. Compartilhe métodos e aprendizados, mas nunca cole credenciais, registros de clientes ou detalhes de infraestrutura não públicos.

  1. 01

    Quais padrões públicos de URL geram trabalho de rastreamento no seu site, e qual evidência ajudou a distinguir um problema real de uma variação inofensiva?

  2. 02

    Como sua equipe revisa uma mudança no robots.txt junto com sitemap, canônicos e decisões de controle de acesso antes de um lançamento?

  3. 03

    Qual sinal de rollback diria à sua equipe que uma nova regra de rastreamento está prejudicando uma rota importante de usuário ou negócio?

RECURSOS POPULARES / AUTORITATIVOS

Abra o material de origem.

Google Search CentralIntroduction to robots.txt ↗

Explica o uso pretendido pelo Google, limites de resultado de busca e limites de segurança para robots.txt.

Revisado 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

A referência em standards para sintaxe, correspondência, escopo, erros, cache e limites de segurança.

Revisado 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Mostra o uso da meta-tag noindex e do cabeçalho HTTP e por que a resposta precisa permanecer rastreável.

Revisado 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Cobre posicionamento, sintaxe suportada, declarações de sitemap e opções de teste.

Revisado 2026-09-27
Google Search CentralLearn about sitemaps ↗

Esclarece benefícios e limites da descoberta por sitemap e a importância de links internos.

Revisado 2026-09-27
MDN Web DocsHTTP authentication ↗

Uma visão geral de controle de acesso HTTP e considerações HTTPS para autenticação.

Revisado 2026-09-27

Política de fontes. Este artigo usa padrões primários vinculados e documentação oficial. Verifique a configuração específica do produto contra a documentação atual da plataforma antes de lançar.

ESCLARECIMENTOS RÁPIDOS

Perguntas comuns.

O robots.txt pode manter uma página fora do Google Search?

Não. Uma URL bloqueada ainda pode ser descoberta e aparecer nos resultados. Use noindex rastreável para conteúdo público que não deve ser indexado e controles de acesso para conteúdo privado.

Qual é o arquivo robots.txt inicial mais seguro?

Comece sem exclusões a menos que você possa documentar uma necessidade de gerenciamento de rastreamento. Adicione apenas caminhos estreitos que você tenha testado contra páginas e recursos importantes.

Um sitemap deve ser listado em robots.txt?

Pode ser. Uma linha Sitemap totalmente qualificada ajuda na descoberta pelos rastreadores, mas não força rastreamento ou indexação, e não substitui um bloqueio do robots.

Status Is UP Editorial Team · Editores de Habilitação de Uptime

Revisado por Revisor técnico de SEO e plataforma web; adicione revisão de segurança para decisões de controle de acesso ou conteúdo sensível.. Publicado 2026-09-27; atualizado 2026-09-30.