
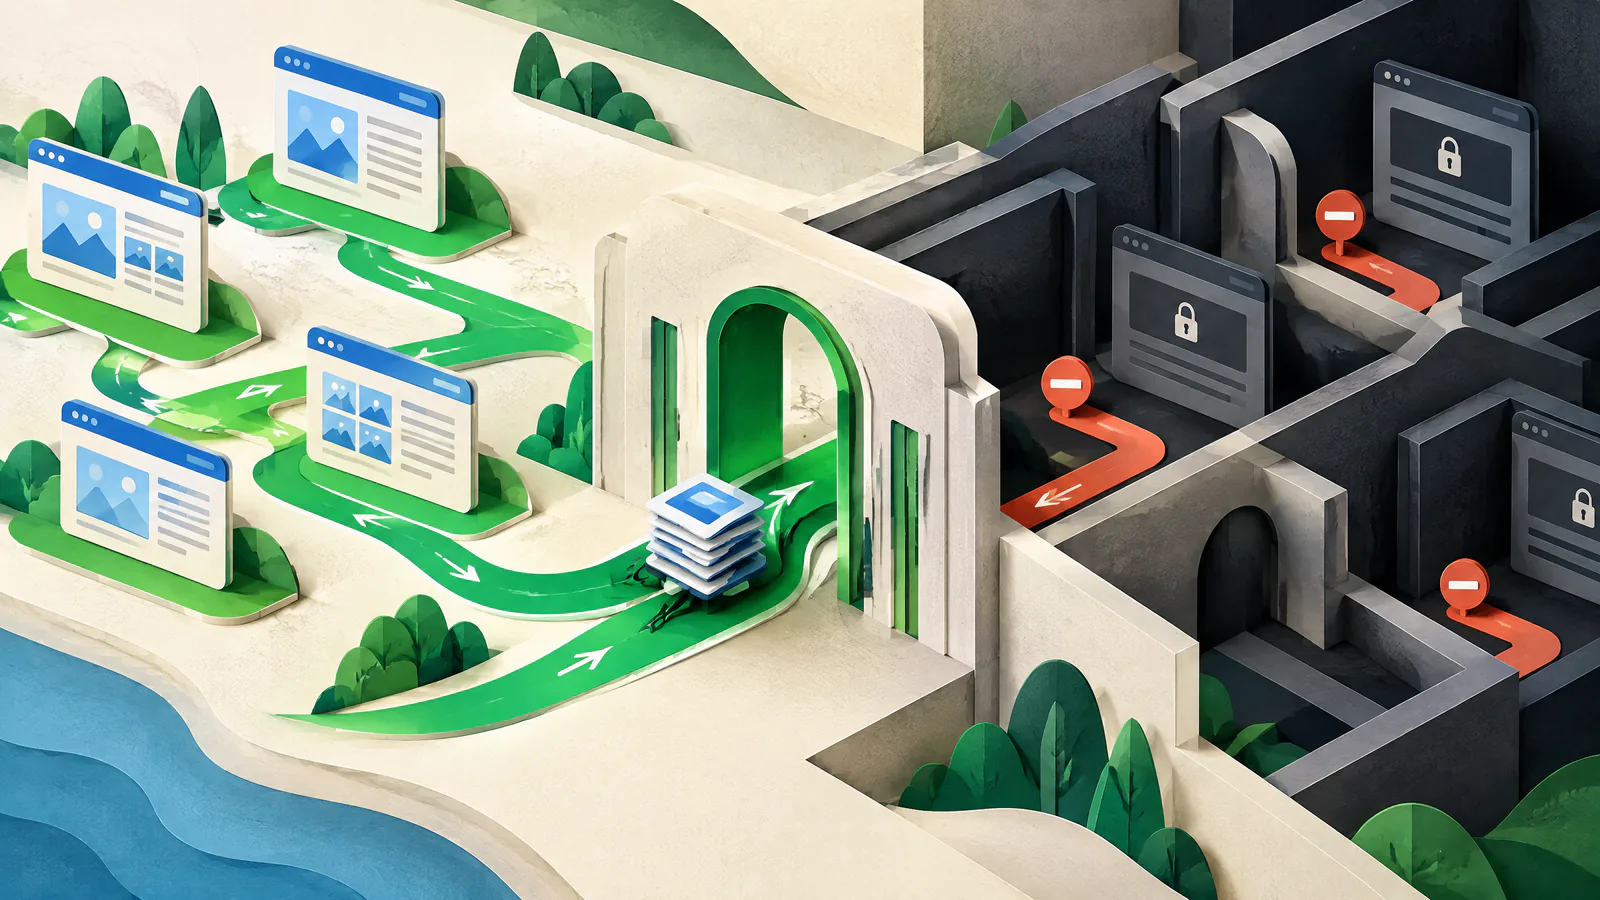
Kies de controle die bij het gewenste resultaat past
Crawling is het geautomatiseerd ophalen van een URL. Indexering is een zoekmachine die beslist of ze informatie over die URL wil opslaan en tonen. Toegangscontrole bepaalt wie content kan verkrijgen. Robots.txt betreft crawling, en conforme crawlers kiezen of ze het opvolgen. Het IETF Robots Exclusion Protocol zegt dat het geen autorisatie is.
Gebruik een Disallow-regel om crawlertoegang te beheren naar een openbare, lage-waarde route, zoals een gecontroleerde interne-zoekroute. Gebruik noindex voor openbare inhoud die niet in ondersteunde zoekresultaten moet verschijnen. Gebruik echte toegangscontroles voor previews, accountgebieden, exports of gevoelige gegevens. Voor klant-, medewerker-, betalings- of gereguleerde informatie, verkrijg gekwalificeerde beveiligings- en platformreview; robots.txt is nooit een compenserende controle.
Robots.txt kan verzoeken dat conforme crawlers een gedefinieerde openbare route vermijden; het garandeert geen verwijdering uit resultaten.
Gebruik noindex in HTML of een X-Robots-Tag-header, en laat de response crawlbaar zodat de instructie gelezen kan worden.
Vereis authenticatie of een geschikte applicatie- of servercontrole, en verwijder de URL vervolgens uit openbare ontdekkingspaden.
Gebruik de kerntaal en scope precies
Publiceer UTF-8 platte-tekst robots.txt op /robots.txt voor elk scheme, host en poort die regels nodig heeft. Een bestand op https://www.example.com/robots.txt geldt niet automatisch voor https://example.com, een subdomein of een HTTP-origin. Verifieer de origins die door canonieke URL's, redirects, CDN en applicatie worden bediend voordat je aanneemt dat een regel van toepassing is.
Een groep begint met User-agent en gebruikt daarna Allow of Disallow-paden. User-agent: * is de algemene groep. Matching is hoofdlettergevoelig en begint bij het begin van het pad. De meest specifieke matchende regel wint; een even specifieke Allow zou boven Disallow moeten winnen. Disallow: blokkeert niets, terwijl Disallow: / de gehele origin blokkeert. De standaard definieert # voor opmerkingen, * voor wildcard en $ voor het einde van een patroon.
Als er geen gedocumenteerde behoefte aan crawlbeheer is, voeg dan geen uitsluitingen toe; creëer geen speculatieve blokkades.
Geef de voorkeur aan een stabiele, nauwe prefix zoals /search/ boven een losse wildcard of een onverklaarde bestandsnaamregel.
Leg het doel van de regel, de eigenaar en de wijzigingsreferentie vast, maar beschouw opmerkingen niet als vervanging voor review.
Blokkeer alleen patronen ondersteund door URL-bewijs
Maak voordat je een regel schrijft een inventarisatie van belangrijke pagina's, ongewenste crawlpaden, queryvarianten, on-site zoeken, preview-routes, assets en sitemap-URL's. Voor elke voorbeeld-URL noteer je het verwachte resultaat en de bijpassende regel. Vergelijk de lijst met canonieke URL's en live-navigatie zodat een blokkade geen nuttige route verbergt.
Houd browserkritieke resources beschikbaar tenzij anders getest. Google waarschuwt dat het blokkeren van CSS, JavaScript, afbeeldingen of andere resources een pagina moeilijker kan maken om te analyseren. Robots.txt lost geen selectie van duplicate content, autorisatie of paginakwaliteit op; gebruik canonicalisatie, redirects, toegangscontroles of inhoudswerk waar passend.
Gebruik echte URL-monsters en server- of crawlbewijs, niet een generieke lijst gekopieerd van een andere site.
Houd voor elk voorbeeld-URL het verwachte resultaat, de gematchte regel en de verantwoordelijke eigenaar in het release-record bij.
Houd sitemap-discovery, noindex en privacybeslissingen consistent
Een sitemap vertelt zoekmachines welke URL's en bestanden je belangrijk vindt; het kan discovery helpen maar garandeert geen crawling of indexering. Sterke interne links blijven belangrijk. Je kunt een volledig gekwalificeerde Sitemap-URL in robots.txt opnemen, maar vermeld geen privé-, omgeleide-, robots-geblokkeerde of opzettelijk noindex-URL's. Stem sitemap-output af met robotsregels bij een release.
Noindex is geen Google-robots.txt-directief. Google ondersteunt het in een HTML meta-tag of X-Robots-Tag HTTP-responseheader, en moet de response crawlen om het te zien. Als een openbare pagina uit Google-resultaten moet verdwijnen, verwijder dan elke robots-blokkade die noindex verbergt. Als content niet-public is, reclameer zijn pad niet in robots.txt; handhaaf toegangscontrole. Grenzen voor gevoelige gegevens hebben gekwalificeerde review nodig.
Gebruik een volledige URL, bijvoorbeeld Sitemap: https://www.example.com/sitemap.xml; het overschrijft geen crawlblok.
Gebruik een meta noindex voor HTML of een X-Robots-Tag: noindex response-header waar geschikt, en test vervolgens de live response.
Beperk eerst de toegang wanneer content gevoelig is, en gebruik vervolgens indien nodig het verwijderproces van de zoekmachine.
Test en publiceer het als een kritieke configuratiebestand
Valideer de goedgekeurde tekst lokaal en test daarna toegestane en geblokkeerde voorbeelden voor de beoogde crawlergroep. Na uitrol haal je de publieke /robots.txt privé of via een directe HTTP-aanvraag op om de inhoud, origin en response-status te bevestigen. Google biedt een Search Console robots.txt-rapport voor toegankelijke bestanden en een open-source parserbibliotheek voor lokaal testen.
Crawlers kunnen robotsbestanden cachen, dus verwacht geen onmiddellijke ontdekking of indexeringswijzigingen. Server- of netwerkfouten leiden ertoe dat crawlers volledige disallow aannemen, terwijl een 4xx toegang kan toestaan. Houd het bestand in source-controlled configuratie, vereis extra review voor whole-site of wildcard-wijzigingen, en bewaar de vorige versie. SIU preflights en rollback-planning helpen een slechte release te vangen voordat het een groter beschikbaarheids- of vindbaarheidsprobleem wordt.
Vereis een tweede reviewer voor origin-migraties, whole-site blocks, wildcards en wijzigingen die sign-in, checkout of support-routes beïnvloeden.
Herstel de vorige versie wanneer een belangrijk voorbeeld-URL nieuw geblokkeerd is, een noodzakelijke asset ontoegankelijk is geworden of het endpoint onbeschikbaar is.
Eén crawler-test bewijst niet dat elke geautomatiseerde client elke regel op dezelfde manier interpreteert.