
STATUS IS UPওয়েবসাইট অপ্টিমাইজেশন উইকি
32শক্তিশালী করুন
SEO ও খুঁজে পাওয়া সহজতা / শক্তিশালী করুন

Robots.txt গাইড: ত্রুটি লুকানো ছাড়াই ক্রলিং নিয়ন্ত্রণ করুন

ক্রলার অ্যাক্সেস নির্দেশ করতে robots.txt ব্যবহার করুন, তারপর কাজের জন্য সঠিক ইনডেক্সিং বা অ্যাক্সেস-কন্ট্রোল পদ্ধতির সঙ্গে মিলিয়ে দিন।

Robots.txt গাইড: ত্রুটি লুকানো ছাড়াই ক্রলিং নিয়ন্ত্রণ করুন — ভিজ্যুয়াল গাইড
পড়ুন
8 মিনিট
সূত্র
6
পুনরায় যাচাই করুন
2027-03-27
পর্যালোচিত
টেকনিক্যাল SEO এবং ওয়েব প্ল্যাটফর্ম রিভিউয়ার; অ্যাক্সেস-কন্ট্রোল বা সংবেদনশীল কনটেন্ট সিদ্ধান্তের জন্য সিকিউরিটি রিভিউ যোগ করুন।
সংক্ষিপ্ত উত্তর

সিদ্ধান্ত দিয়ে শুরু করুন।

অনাবশ্যক ক্রল কাজ তৈরির নির্দিষ্ট পাবলিক URL প্যাটার্ন থেকে সম্মত ক্রলারদের সরাতে robots.txt ব্যবহার করুন। প্রতিটি সঠিক সাইট উৎসের রুটে UTF-8 প্লেইন-টেক্সট ফাইল হিসেবে /robots.txt প্রকাশ করুন এবং কয়েকটি নিয়ম দিয়ে শুরু করুন। এটি একটি ক্রলার-অ্যাক্সেস সংকেত, লক নয়, এবং এটি কখনও ত্রুটি লুকায় না।

Robots.txt পৃষ্ঠা নির্ভরযোগ্যভাবে লুকায় বা সুরক্ষা দেয় না। একটি ব্লক করা URL লিঙ্কের মাধ্যমে এখনও আবিষ্কৃত হতে পারে। প্রকাশ্য কনটেন্ট যা ইনডেক্স হওয়া উচিত নয় তার জন্য পেজটি ক্রলারকে ফেচ করার অনুমতি দিয়ে noindex ব্যবহার করুন। ব্যক্তিগত উপকরণের জন্য সার্ভার বা অ্যাপ্লিকেশন স্তরের অ্যাক্সেস কন্ট্রোল প্রয়োগ করুন।

সম্পাদনাগুলোকে প্রোডাকশন কনফিগারেশন হিসেবে বিবেচনা করুন: মূল (origin) নির্ধারণ করুন, নির্দিষ্ট URL গুলো পরীক্ষা করুন, লাইভ /robots.txt পুনরুদ্ধার করুন, এবং পূর্বের সংস্করণ প্রস্তুত রাখুন। SIU প্রিফ্লাইট ও রোলব্যাক শৃঙ্খলায় প্রোঅ্যাকটিভ উপলব্ধতা ও মেরামত সমর্থন করে; এটি আউটেজ অ্যালার্ট বা স্ট্যাটাস রিপোর্টিং নয়।

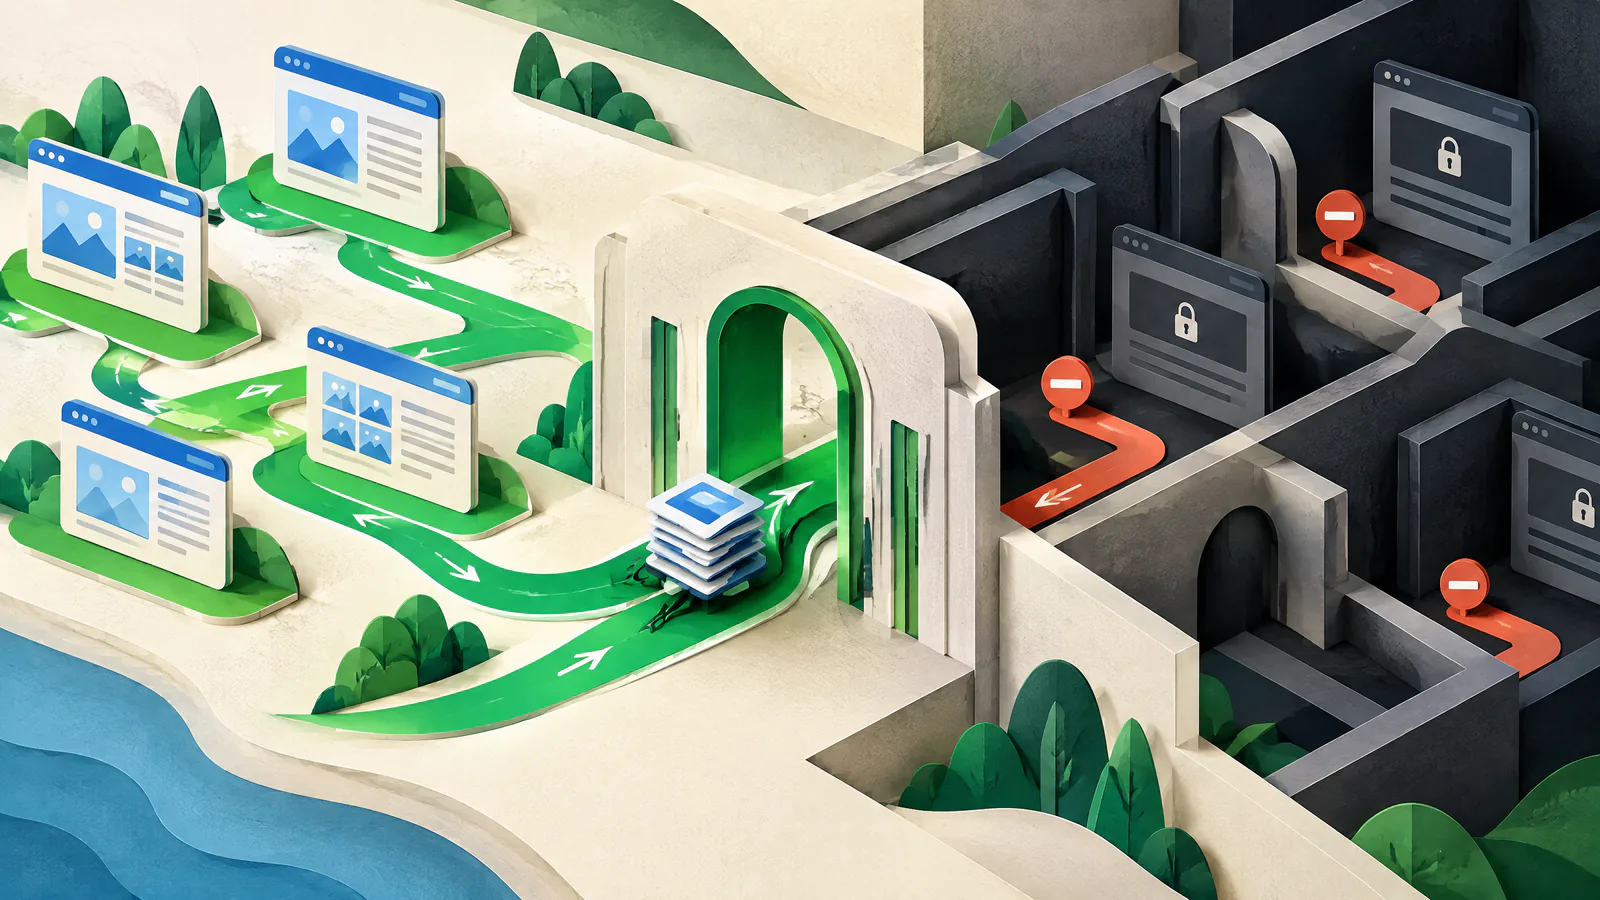
ভিজ্যুয়াল গাইড

কাজটিকে একটি সিস্টেম হিসেবে দেখুন।

কোনো নির্দিষ্ট কৌশল গ্রহণের আগে নিবন্ধটির সিদ্ধান্তগুলোকে সংযুক্ত করতে এই মানচিত্রটি ব্যবহার করুন।

SIUশক্তিশালী করুন
01ফলাফলের সঙ্গে মিলে এমন কন্ট্রোলটি বেছে নিন
02কোর সিনট্যাক্স এবং স্কোপ সুনির্দিষ্টভাবে ব্যবহার করুন
03শুধুমাত্র URL প্রমাণ সমর্থিত প্যাটার্ন ব্লক করুন
04সাইটম্যাপ আবিষ্কার, noindex এবং গোপনীয়তা সিদ্ধান্তগুলো সামঞ্জস্য রাখুন
01

ফলাফলের সঙ্গে মিলে এমন কন্ট্রোলটি বেছে নিন

ক্রলিং হচ্ছে একটি URL-এ স্বয়ংক্রিয়ভাবে অনুরোধ করে কনটেন্ট পুনরুদ্ধার করা। ইনডেক্সিং হচ্ছে সার্চ ইঞ্জিন ঐ কনটেন্ট সংরক্ষণ ও প্রদর্শন করবেন কি না তা নির্ধারণ করা। অ্যাক্সেস কন্ট্রোল নির্ধারণ করে কে কনটেন্ট পেতে পারে। Robots.txt ক্রলার-অ্যাক্সেস সম্পর্কিত এবং সম্মত ক্রলাররা এটি মেনে চলার সিদ্ধান্ত নিয়েছে। IETF Robots Exclusion Protocol স্পষ্টভাবে বলেছে এটি অনুমোদন (authorization) নয়।

একটি `Disallow` নিয়ম ব্যবহার করে পাবলিক, কম-মূল্যের পাথ যেমন নিয়ন্ত্রিত অন-সাইট সার্চ রুটকে ক্রলারদের থেকে রাখতে পারেন। প্রকাশ্য কনটেন্ট যা ইনডেক্স হওয়া উচিত না, তার জন্য `noindex` ব্যবহার করুন। প্রিভিউ, অ্যাকাউন্ট এরিয়া, এক্সপোর্ট বা সংবেদনশীল ডেটার জন্য বাস্তব সার্ভার/অ্যাপ্লিকেশন অ্যাক্সেস কন্ট্রোল চাই। গ্রাহক, কর্মচারী, পেমেন্ট বা নিয়ন্ত্রিত তথ্যের জন্য যোগ্য সিকিউরিটি ও প্ল্যাটফর্ম রিভিউ নিন; robots.txt কখনই একটি ক্ষতিপূরণমূলক নিয়ন্ত্রণ হওয়ার উপযুক্ত উপায় নয়।

ক্রল ম্যানেজমেন্ট

Robots.txt সম্মত ক্রলারদের নির্দিষ্ট পাবলিক পাথ এড়িয়ে চলার অনুরোধ করতে পারে; এটি ফলাফল থেকে সরানোর নিশ্চয়তা দেয় না।

ইনডেক্স নিয়ন্ত্রণ

HTML-এ `noindex` মেটা ট্যাগ বা `X-Robots-Tag` হেডার ব্যবহার করুন, এবং নির্দেশটি ক্রলার দেখতে পাবে এমনভাবে রেস্পন্স ক্রলেবল রাখুন।

প্রাইভেট কনটেন্ট

অথেন্টিকেশন বা উপযুক্ত অ্যাপ/সার্ভার কন্ট্রোল লাগান, তারপর URL-টি পাবলিক আবিষ্কার পথ থেকে সরিয়ে দিন।

02

কোর সিনট্যাক্স এবং স্কোপ সুনির্দিষ্টভাবে ব্যবহার করুন

প্রতিটি scheme, host, এবং port-এর জন্য দরকারি রুলগুলোর জন্য /robots.txt-এ UTF-8 প্লেইন-টেক্সট প্রকাশ করুন। https://www.example.com/robots.txt ফাইলটি স্বয়ংক্রিয়ভাবে https://example.com, কোনো সাবডোমেইন, বা HTTP অরিজিনকে নিয়ন্ত্রণ করে না। কোনো নিয়ম প্রযোজ্য ধরে নেওয়ার আগে canonical URL, redirect, CDN, এবং অ্যাপ্লিকেশন দ্বারা কোন origin প্রদান করা হচ্ছে তা যাচাই করুন।

একটি গ্রুপ `User-agent` দিয়ে শুরু হয় এবং তার পরে `Allow` বা `Disallow` পথ ব্যবহার করা হয়। `User-agent: *` হলো সাধারণ গ্রুপ। মিল (matching) কেস-সংবেদনশীল এবং পাথে শুরু থেকেই করা হয়। সবচেয়ে নির্দিষ্ট মিল করা নিয়মটি জেতে; সমানভাবে নির্দিষ্ট একটি `Allow` সাধারণত `Disallow`-এর উপরে জাতে। `Disallow:` কোনো কিছু ব্লক করে না, যেখানে `Disallow: /` পুরো অরিজিন ব্লক করে। স্ট্যান্ডার্ডে `#` মন্তব্যের জন্য, `*` ওয়াইল্ডকার্ড এবং `$` প্যাটার্নের শেষ নির্দেশ করে।

সর্বনিম্ন বেসলাইন

যদি কোনো ডকুমেন্টেড ক্রল-ম্যানেজমেন্ট প্রয়োজন না থাকে, তাহলে কোনো এক্সক্লুউশন যোগ করবেন না; অনুমানভিত্তিক ব্লক করবেন না।

নিরাপদ প্যাটার্ন

একটি স্থিতিশীল, সংকীর্ণ প্রিফিক্স পছন্দ করুন যেমন `/search/` বনাম ঢিলা ওয়াইল্ডকার্ড বা অকথিত ফাইলনেম নিয়ম।

মন্তব্য

নিয়মের উদ্দেশ্য, মালিক এবং পরিবর্তন রেফারেন্স রেকর্ড করুন, তবে মন্তব্যকে রিভিউয়ের বিকল্প হিসেবে নেবেন না।

03

শুধুমাত্র URL প্রমাণ সমর্থিত প্যাটার্ন ব্লক করুন

নিয়ম লেখার আগে গুরুত্বপূর্ণ পেজ, অনিচ্ছিত ক্রল পাথ, কুয়েরি ভ্যারিয়েন্ট, অন-সাইট সার্চ, প্রিভিউ রুট, অ্যাসেট এবং সাইটম্যাপ URL ইনভেন্টরি করুন। প্রতিটি নমুনা URL-এর জন্য প্রত্যাশিত ফলাফল এবং মেলে এমন নিয়ম রেকর্ড করুন। তালিকাটি canonical URL এবং লাইভ ন্যাভিগেশনের সঙ্গে তুলনা করুন যাতে কোনো ব্লক উপযোগী রুট লুকায় না।

ব্রাউজারের জন্য গুরুত্বপূর্ণ রিসোর্সগুলো তখনই ব্লক করুন যদি পরীক্ষায় দেখা যায় তা প্রয়োজন। Google সতর্ক করে যে CSS, JavaScript, ইমেজ বা অন্যান্য রিসোর্স ব্লক করলে একটি পেজ বিশ্লেষণ কঠিন হতে পারে। Robots.txt নকল-কনটেন্ট নির্বাচন, অনুমোদন বা পেজ কোয়ালিটি সমস্যা সমাধান করে না; প্রয়োজনে canonicalization, redirect, অ্যাক্সেস কন্ট্রোল বা কনটেন্ট কাজ ব্যবহার করুন।

প্রমাণ প্রথম

অন্য সাইট থেকে কপি করা জেনেরিক তালিকার বদলে বাস্তব URL স্যাম্পল ও সার্ভার/ক্রল প্রমাণ ব্যবহার করুন।

চেঞ্জ টেবিল

প্রতিটি নমুনা URL, প্রত্যাশিত ফলাফল, মিলে যাওয়া নিয়ম এবং দায়িত্বশীল মালিক রিলিজ রেকর্ডে রাখুন।

04

সাইটম্যাপ আবিষ্কার, noindex এবং গোপনীয়তা সিদ্ধান্তগুলো সামঞ্জস্য রাখুন

একটি সাইটম্যাপ সার্চ ইঞ্জিনকে আপনি কোন URL ও ফাইলগুলো গুরুত্বপূর্ণ মনে করেন তা বলে; এটি আবিষ্কারে সহায়তা করে কিন্তু ক্রলিং বা ইনডেক্সিং নিশ্চিত করে না। শক্তিশালী অভ্যন্তরীণ লিঙ্ক এখনও গুরুত্বপূর্ণ। আপনি robots.txt-এ পূর্ণ যোগ্য সাইটম্যাপ URL যোগ করতে পারেন, তবে ব্যক্তিগত, রিডাইরেক্ট করা, robots-অবরুদ্ধ, বা ইচ্ছাকৃতভাবে noindex করা URL সেখানে তালিকাভুক্ত করবেন না। রিলিজে সাইটম্যাপ আউটপুটকে robots নিয়মগুলোর সঙ্গে reconcile করুন।

`noindex` Google-র robots.txt নির্দেশিকা নয়। Google এটি HTML meta ট্যাগে বা `X-Robots-Tag` HTTP রেসপন্স হেডারে সমর্থন করে, এবং এটি দেখতে ক্রলারকে রেসপন্স ক্রল করতে হবে। যদি কোনো প্রকাশ্য পেজ Google ফলাফল থেকে সরাতে হয়, তাহলে এমন কোনো robots ব্লক সরান যা `noindex` লুকায়। যদি কনটেন্ট নন-পাবলিক হয়, তার পথ robots.txt-এ প্রচার করবেন না; অ্যাক্সেস কন্ট্রোল প্রয়োগ করুন। সংবেদনশীল-ডেটার সীমানার জন্য যোগ্য পর্যালোচনা প্রয়োজন।

সাইটম্যাপ ঘোষণা

একটি পূর্ণ URL ব্যবহার করুন, উদাহরণ: `Sitemap: https://www.example.com/sitemap.xml`; এটি ক্রল ব্লক অতিক্রম করে না।

HTML এবং ফাইল

HTML-এ meta `noindex` বা উপযুক্ত হলে `X-Robots-Tag: noindex` রেসপন্স হেডার ব্যবহার করুন, তারপর লাইভ রেসপন্স পরীক্ষা করুন।

জরুরি প্রকাশ

কনটেন্ট সংবেদনশীল হলে প্রথমে অ্যাক্সেস সীমিত করুন, তারপর প্রয়োজনে সার্চ ইঞ্জিনের রিমুভাল প্রক্রিয়া ব্যবহার করুন।

05

একটি গুরুত্বপূর্ণ কনফিগারেশন ফাইলের মতো পরীক্ষা ও প্রকাশ করুন

অনুমোদিত টেক্সট লোকালি ভ্যালিডেট করুন, তারপর উদ্দেশ্যভিত্তিক ক্রলার গ্রুপের জন্য অনুমোদিত ও অবরুদ্ধ উদাহরণ পরীক্ষা করুন। ডিপ্লয়মেন্টের পরে পাবলিক `/robots.txt` ব্যক্তিগতভাবে বা সরাসরি HTTP অনুরোধ করে পুনরুদ্ধার করে কনটেন্ট, অরিজিন এবং রেসপন্স স্ট্যাটাস নিশ্চিত করুন। Google Search Console robots.txt রিপোর্টে অ্যাক্সেসিবল ফাইলের জন্য তথ্য আছে এবং লোকাল টেস্টিংয়ের জন্য ওপেন-সোর্স পার্সার লাইব্রেরি রয়েছে।

ক্রলাররা robots ফাইল ক্যাশ করতে পারে, তাই তাত্ক্ষণিক আবিষ্কার বা ইনডেক্সিং পরিবর্তনের প্রতিশ্রুতি দেবেন না। সার্ভার বা নেটওয়ার্ক ত্রুটি ক্রলারকে সম্পূর্ণ `disallow` ধরে নেবার দিকে পরিচালিত করে, যেখানে কোনো 4xx এক্সিকিউশন অ্যাক্সেসকে অনুমতি দিতে পারে। ফাইলটি সোর্স-কন্ট্রোল কনফিগারেশনে রাখুন, পুরো-সাইট বা ওয়াইল্ডকার্ড পরিবর্তনের জন্য অতিরিক্ত রিভিউ করুন, এবং পূর্বের সংস্করণসংরক্ষণ করুন। SIU প্রিফ্লাইট এবং রোলব্যাক পরিকল্পনা একটি খারাপ রিলিজ বড় উপলব্ধতা বা আবিষ্কারযোগ্যতার সমস্যায় পরিণত হওয়ার আগে ধরতে সাহায্য করে।

রিলিজ গেট

অরিজিন মাইগ্রেশান, পুরো-সাইট ব্লক, ওয়াইল্ডকার্ড এবং সাইন-ইন, চেকআউট বা সাপোর্ট রুটকে প্রভাবিত করা পরিবর্তনের জন্য দ্বিতীয় রিভিউয়ার প্রয়োজন।

রোলব্যাক সিগনাল

যখন কোনো গুরুত্বপূর্ণ নমুনা URL নতুনভাবে ব্লক হয়, কোনো প্রয়োজনীয় অ্যাসেট অ্যাক্সেসযোগ্য না থাকে, বা এন্ডপয়েন্ট অপ্রাপ্য হয়—তখন পূর্বের সংস্করণ পুনঃস্থাপন করুন।

সীমা

একটি ক্রলার টেস্ট প্রমাণ করে না যে প্রতিটি স্বয়ংক্রিয় ক্লায়েন্ট প্রতিটি নিয়ম একইভাবে ব্যাখ্যা করবে।

কর্ম / যাচাই

আপনার ব্যবহারিক কাজের নির্দেশিকা।

  1. 01

    লক্ষ্য শ্রেণীবদ্ধ করুন

    কন্ট্রোল বেছে নেওয়ার আগে ক্রল ম্যানেজমেন্ট, ইনডেক্স এক্সক্লুশন, বা প্রাইভেট অ্যাক্সেস নির্ধারণ করুন।

    যাচাই করুন: প্রতি প্রভাবিত URL-এ একটি ডকুমেন্টেড উদ্দেশ্য এবং দায়িত্বশীল মালিক রয়েছে।
  2. 02

    অরিজিন ম্যাপ করুন

    নির্দিষ্ট প্রটোকল, হোস্ট, পোর্ট, সাবডোমেইন, CDN, এবং অ্যাপ অরিজিন শনাক্ত করুন।

    যাচাই করুন: কোনো অরিজিন অন্য অরিজিনের robots নিয়ম উত্তরাধিকারসূত্রে গ্রহণ করে বলে ধরে নেওয়া হয় না।
  3. 03

    প্রতিনিধিত্বশীল URL তালিকা করুন

    গুরুত্বপূর্ণ পেজ, লক্ষ্য, ভ্যারিয়েন্ট, অ্যাসেট, সাইটম্যাপ এন্ট্রি এবং ব্যক্তিগত রুট অন্তর্ভুক্ত করুন।

    যাচাই করুন: একটি টেবিলে প্রতিটি টেস্ট URL-এর প্রত্যাশিত ফলাফল নাম আছে।
  4. 04

    সংকীর্ণ নিয়ম লিখুন

    স্পষ্ট `User-agent`, `Allow`, এবং `Disallow` পথ ব্যবহার করুন; প্রয়োজন না হলে বিস্তৃত ওয়াইল্ডকার্ড এড়িয়ে চলুন।

    যাচাই করুন: একজন রিভিউয়ার প্রতিটি নিয়মের স্কোপ এবং ব্যতিক্রম ব্যাখ্যা করতে পারে।
  5. 05

    noindex সঠিকভাবে প্রয়োগ করুন

    Google থেকে বাদ দিতে চাওয়া প্রকাশ্য কনটেন্টের জন্য meta ট্যাগ বা রেসপন্স হেডার ব্যবহার করুন।

    যাচাই করুন: লাইভ টার্গেট ক্রলেবল এবং ক্রলারকে `noindex` এক্সপোজ করে।
  6. 06

    ননপাবলিক উপকরণ রক্ষা করুন

    robots.txt-এ নয়, অথেন্টিকেশন বা সার্ভার/অ্যাপ কন্ট্রোল ব্যবহার করে সুরক্ষিত রাখুন।

    যাচাই করুন: অথেনটিকেশন ছাড়া কোনও অনুরোধ সংবেদনশীল কনটেন্ট পায় না।
  7. 07

    অনুমোদিত ফাইল প্রকাশ করুন

    অরিজিন রুটে UTF-8 প্লেইন টেক্সট হিসেবে ডিপ্লয় করুন।

    যাচাই করুন: লাইভ `/robots.txt` URL-টি রিভিউ করা ফাইল ফিরিয়ে দেয়।
  8. 08

    লাইভ বিহেভিয়র টেস্ট করুন

    উপযুক্ত টুলিং দিয়ে অনুমোদিত ও অবরুদ্ধ নমুনাগুলো পরীক্ষা করুন।

    যাচাই করুন: ফলাফল রিলিজ টেবিলের সাথে মিলে যায়, ব্যতিক্রমসহ।
  9. 09

    আবিষ্কার ইনপুটগুলো মিলান

    সাইটম্যাপ এবং অভ্যন্তরীণ-লিংক লক্ষ্যগুলোকে ক্রল ও ইনডেক্স সিদ্ধান্তের সঙ্গে সামঞ্জস্য রাখুন।

    যাচাই করুন: কোনো ইচ্ছাকৃতভাবে প্রাইভেট, রিডাইরেক্টেড, `noindex`, বা ব্লক করা URL না থাকেই সাইটম্যাপে আছে না—থেকে থাকলে কারণ আছে।
  10. 10

    রোলব্যাক প্রস্তুত রাখুন

    পূর্ববর্তী ফাইল সংরক্ষণ করুন এবং রুল পরিবর্তন লঞ্চ ও রিকভারি প্রক্রিয়ায় যোগ করুন।

    যাচাই করুন: একটি জানা-ভালো সংস্করণ এবং রোলব্যাকের মালিক তৎক্ষণাৎ শনাক্তযোগ্য।
আলোচ্য বিষয়

ট্রেড-অফগুলো তুলনা করুন, ব্যক্তিগত ডেটা নয়।

এই প্রম্পটগুলো আপনার টিম বা ওয়েবসাইট-মালিক কমিউনিটির সঙ্গে ব্যবহার করুন। পদ্ধতি ও শিক্ষা শেয়ার করুন, কিন্তু কখনোই লগইন তথ্য, গ্রাহক রেকর্ড বা অপ্রকাশ্য ইনফ্রাস্ট্রাকচার বিবরণ পেস্ট করবেন না।

  1. 01

    আপনার সাইটে কোন পাবলিক URL প্যাটার্নগুলো ক্রলার কাজ বাড়ায়, এবং বাস্তবে সমস্যা আলাদা করার জন্য কোন প্রমাণগুলো সাহায্য করেছিল?

  2. 02

    আপনার দল কীভাবে একটি robots.txt পরিবর্তনকে সাইটম্যাপ, canonical এবং অ্যাক্সেস-কন্ট্রোল সিদ্ধান্তের সঙ্গে একত্রে রিভিউ করে লঞ্চের আগে?

  3. 03

    কোন রোলব্যাক সিগনালটি আপনার দলকে বলবে যে একটি নতুন ক্রলার নিয়ম গুরুত্বপূর্ণ কোনো ইউজার বা ব্যবসায়িক পথকে ক্ষতিগ্রস্ত করছে?

জনপ্রিয় / প্রামাণিক রিসোর্স

সোর্স মেটারিয়াল দেখুন

Google Search CentralIntroduction to robots.txt ↗

Google-এর robots.txt ব্যবহারের উদ্দেশ্য, সার্চ-রেজাল্ট সীমা, এবং সিকিউরিটি সীমা ব্যাখ্যা করে।

পর্যালোচিত 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

সিনট্যাক্স, মিলিং, স্কোপ, ত্রুটি, ক্যাশিং, এবং সিকিউরিটি সীমার জন্য স্ট্যান্ডার্ড-ট্র্যাক রেফারেন্স।

পর্যালোচিত 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

`noindex` মেটা ট্যাগ এবং HTTP হেডার ব্যবহারের উদাহরণ ও কারণ দেখায়, এবং রেসপন্সকে ক্রলেবল রাখার গুরুত্ব ব্যাখ্যা করে।

পর্যালোচিত 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

রোবটস ফাইলের স্থাপন, সমর্থিত সিনট্যাক্স, সাইটম্যাপ ঘোষণাসমূহ, এবং টেস্টিং অপশনগুলো কভার করে।

পর্যালোচিত 2026-09-27
Google Search CentralLearn about sitemaps ↗

সাইটম্যাপ আবিষ্কারের সুবিধা, সীমাবদ্ধতা, এবং অভ্যন্তরীণ লিংকের গুরুত্ব স্পষ্ট করে।

পর্যালোচিত 2026-09-27
MDN Web DocsHTTP authentication ↗

অথেনটিকেশন ও HTTPS বিবেচনা সহ HTTP অ্যাক্সেস কন্ট্রোলের সারসংক্ষেপ দেয়।

পর্যালোচিত 2026-09-27

সোর্স নীতি। এই প্রবন্ধে প্রাথমিক স্ট্যান্ডার্ড এবং অফিসিয়াল ডকুমেন্টেশনের রেফারেন্স ব্যবহার করা হয়েছে। প্ল্যাটফর্ম-নির্দিষ্ট কনফিগারেশন রিলিজের আগে বর্তমান ডকুমেন্টেশনের সঙ্গে যাচাই করুন।

দ্রুত স্পষ্টীকরণ

সাধারণ প্রশ্ন

Robots.txt কি Google Search-এ একটি পেজকে রাখতে পারে?

না। একটি ব্লক করা URL লিঙ্কের মাধ্যমে এখনও আবিষ্কৃত হয়ে ফলাফলগুলোতে দেখা যেতে পারে। প্রকাশ্য কনটেন্ট যা ইনডেক্স হওয়া উচিত নয় তার জন্য ক্রলযোগ্য `noindex` ব্যবহার করুন, এবং ব্যক্তিগত কনটেন্টের জন্য অ্যাক্সেস কন্ট্রোল ব্যবহার করুন।

সুরক্ষিত শুরু করার জন্য সবচেয়ে নিরাপদ robots.txt ফাইলটি কেমন হওয়া উচিত?

যদি আপনি ক্রল-ম্যানেজমেন্ট প্রয়োজন ডকুমেন্ট করতে না পারেন, তাহলে কোনো এক্সক্লুশন ছাড়া শুরু করুন। কেবলমাত্র সংকীর্ণ পাথ যোগ করুন যেগুলো আপনি গুরুত্বপূর্ণ পেজ ও রিসোর্সের বিপরীতে পরীক্ষা করে দেখেছেন।

একটি সাইটম্যাপ কি robots.txt-এ লেখা উচিত?

লিখে রাখা যেতে পারে। একটি পূর্ণ যোগ্য `Sitemap:` লাইন ক্রলার আবিষ্কারে সহায়ক, কিন্তু এটি ক্রলিং বা ইনডেক্সিং জোর করে না এবং এটি কোনো robots ব্লক ওভাররাইড করে না।

Status Is UP Editorial Team · Uptime Enablement সম্পাদকগণ

পর্যালোচনা করেছেন টেকনিক্যাল SEO এবং ওয়েব প্ল্যাটফর্ম রিভিউয়ার; অ্যাক্সেস-কন্ট্রোল বা সংবেদনশীল কনটেন্ট সিদ্ধান্তের জন্য সিকিউরিটি রিভিউ যোগ করুন।. প্রকাশিত 2026-09-27; আপডেট 2026-09-30.