
STATUS IS UPWIKI YA UBORESHAJI WA TOVUTI
32Imarisha
SEO na uonekano wa utaftaji / Imarisha

Mwongozo wa robots.txt: Dhibiti Uchakavu Bila Kuficha Makosa

Tumia robots.txt kuongoza upatikanaji wa crawlers, kisha uyapange pamoja na njia sahihi za uorodheshaji au udhibiti wa upatikanaji kwa kazi husika.

Mwongozo wa robots.txt: Dhibiti Uchakavu Bila Kuficha Makosa — MWONGOZO WA KIONYESHI
SOMA
8 dakika
VYANZO
6
Thibitisha tena
2027-03-27
imehakikiwa
Mkaguzi wa SEO wa kiufundi na jukwaa la wavuti; ongeza ukaguzi wa usalama kwa maamuzi ya udhibiti wa upatikanaji au yaliyomo nyeti.
JIBU MFUPI

Anza na uamuzi.

Tumia robots.txt kuwashawishi crawlers watii (crawlers) kuepuka mifumo maalum ya URL za umma zinazosababisha kazi ya kuchavua isiyo ya lazima. Chapisha faili ya maandishi wazi UTF-8 kwenye mizizi ya asili halisi ya tovuti na anza kwa kanuni chache. Ni ishara ya upatikanaji kwa crawlers waliotii, si kifungo, na kamwe haisifichi kosa.

Robots.txt haiwezi kuzuia au kulinda ukurasa kwa uhakika. URL iliyozuilwa bado inaweza kugunduliwa kupitia viungo. Kwa yaliyomo ya umma ambayo hayapaswi kuorodheshwa, tumia noindex ukiwaruhusu crawler kuchukua majibu. Kwa nyenzo za kibinafsi, teketeza udhibiti wa upatikanaji wa seva au programu.

Tendea marekebisho kama usanidi wa uzalishaji: tambua asili (origin), jaribu URL zilizopewa majina, chukua /robots.txt moja kwa moja kuishi, na weka toleo la awali tayari. SIU inasaidia upatikaji wa kuzuia matatizo kwa njia za preflight na nidhamu za kurudi nyuma (rollback), si arifa za hitilafu au ripoti za hali.

MWONGOZO WA KIONYESHI

Tazama kazi kama mfumo.

Tumia ramani hii kuunganisha maamuzi ya makala kabla ya kutekeleza mbinu binafsi.

SIUImarisha
01Chagua udhibiti unaolingana na matokeo
02Tumia sintaksia na wigo wa msingi kwa usahihi
03Zuia tu mifumo inayoungwa mkono na ushahidi wa URL
04Hakikisha ugunduzi wa sitemap, noindex, na maamuzi ya faragha ni thabiti
01

Chagua udhibiti unaolingana na matokeo

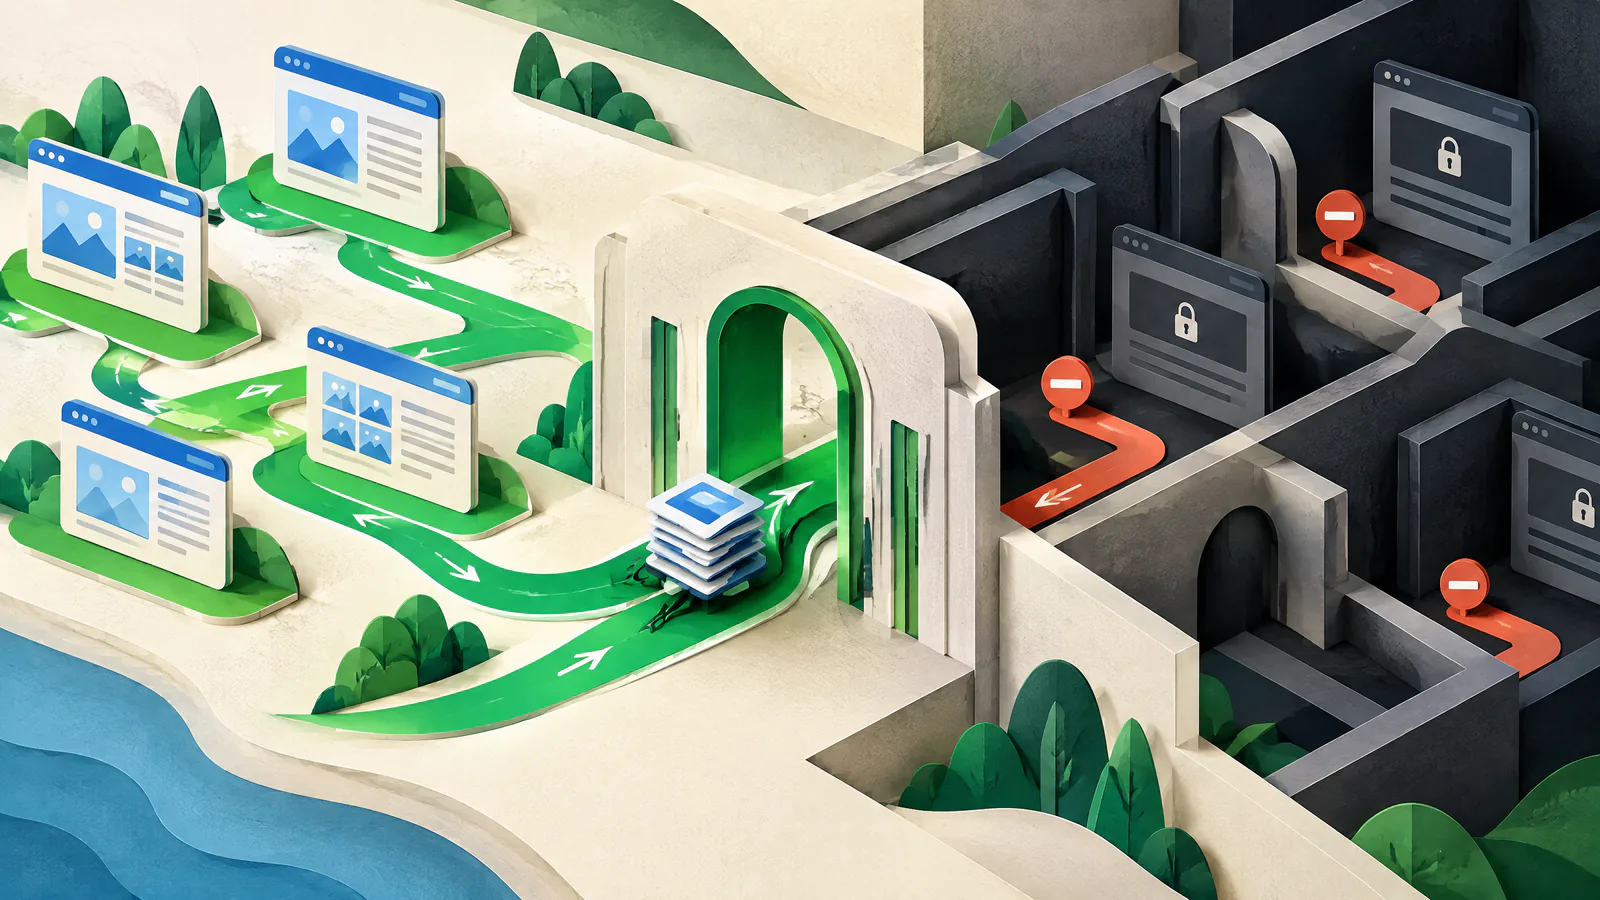
Crawling ni upokeaji wa URL kwa njia ya otomatiki. Indexing ni mchakato ambapo injini ya utafutaji inaamua ikiwa itahifadhi na kuonyesha taarifa kuhusu URL hiyo. Udhibiti wa ufikiaji unaamua nani anaweza kupata maudhui. Robots.txt inahusu crawling, na vichunguzi vinavyotii huamua kama vitafuata maagizo yake. IETF Robots Exclusion Protocol inasema kuwa sio aina ya idhini/uthibitisho.

Tumia kanuni ya Disallow kudhibiti ufikiaji wa vichunguzi kwa njia ya umma yenye thamani ndogo, kama njia ya utafutaji wa ndani inayodhibitiwa. Tumia noindex kwa maudhui ya umma ambayo hayapaswi kuonekana katika matokeo ya injini zinazotimizwa. Tumia udhibiti wa ufikiaji halisi kwa mapitio, maeneo ya akaunti, kuuza nje au data nyeti. Kwa habari za wateja, wafanyakazi, malipo, au zilizodhibitiwa, pata mapitio ya usalama na jukwaa yaliyohitimu; robots.txt hawezi kuwa udhibiti mbadala.

Usimamizi wa kuchunguza (crawl)

Robots.txt inaweza kuomba kwamba vichunguzi vinavyotii kuepuka njia ya umma iliyofafanuliwa; haitahakikisha kuondolewa katika matokeo.

Udhibiti wa kuorodhesha

Tumia noindex katika HTML au kichwa cha X-Robots-Tag, na uache mwitikio uweze kuchunguzwa ili maagizo yaoneke.

Maudhui ya kibinafsi

Hitaji uthibitisho au udhibiti unaofaa wa programu au seva, kisha ondoa URL kutoka katika njia za ugunduzi za umma.

02

Tumia sintaksia na wigo wa msingi kwa usahihi

Chapisha robots.txt ya maandishi wazi ya UTF-8 katika /robots.txt kwa kila skimu, mwenyeji, na bandari zinazohitaji sheria. Faili iliyoko https://www.example.com/robots.txt haidhibiti kiotomatiki https://example.com, subdomain, au asili ya HTTP. Thibitisha asili zinazotumika na URL za kanoni, redirects, CDN, na programu kabla ya kudhani sheria inatumika.

Kikundi kinaanza na User-agent kisha kinatumia Allow au Disallow kwa njia. User-agent: * ni kikundi kwa ujumla. Upatanisho unazingatia tofauti ya herufi (case-sensitive) na huanza mwanzoni mwa njia. Sheria inayolingana kwa undani zaidi ndiyo inashinda; Allow yenye umafani sawa inapaswa kushinda juu ya Disallow. Disallow: haizuizi chochote, wakati Disallow: / inazuia asili nzima. Kiwango kinataja # kwa maoni, * kwa wildcard, na $ kwa mwisho wa muundo.

Msingi mdogo kabisa

Kama hakuna haja ya udhibiti wa kuchunguza iliyodokumentiwa, usiongeze vizuizi; usitengeneze vizuizi vya kubahatisha.

Mfano salama

Pendelea kiambishi imara na nyembamba kama /search/ badala ya wildcard mpana au sheria ya jina la faili isiyoelezewa.

Maoni

Rekodi madhumuni ya sheria, mmiliki, na rejeleo la mabadiliko, lakini usitazame maoni kama mbadala wa mapitio.

03

Zuia tu mifumo inayoungwa mkono na ushahidi wa URL

Kabla ya kuandika sheria, orodhesha kurasa muhimu, njia zisizotakiwa za kuchunguza, tofauti za maswali (query variants), utafutaji wa ndani, njia za mapitio, mali (assets), na URL za sitemap. Kwa kila URL ya sampuli, rekodi matokeo yanayotarajiwa na sheria inayolingana. Linganisha orodha na URL za kanoni na urambazaji wa moja kwa moja ili kizuizi kisificha njia muhimu.

Weka rasilimali muhimu kwa kivinjari zikipatikana isipokuwa imethibitishwa vingine. Google inaonya kwamba kuzuia CSS, JavaScript, picha, au rasilimali nyingine kunaweza kufanya ukurasa kuwa mgumu kuchambua. Robots.txt haiwezi kutatua uchaguzi wa maudhui rudufu, idhinisho, au ubora wa ukurasa; tumia canonicalization, redirects, udhibiti wa ufikiaji, au kazi ya maudhui inapofaa.

Ushahidi kwanza

Tumia sampuli halisi za URL na ushahidi wa seva au crawl, sio orodha ya jumla iliyochakuliwa kutoka tovuti nyingine.

Jedwali la mabadiliko

Hifadhi kila sampuli ya URL, matokeo yaliyokusudiwa, sheria inayolingana, na mmiliki anayehusika katika rekodi ya uzinduzi.

04

Hakikisha ugunduzi wa sitemap, noindex, na maamuzi ya faragha ni thabiti

Sitemap inaambia injini za utafutaji ni URL na faili gani unazoziona muhimu; inaweza kusaidia ugunduzi lakini haisaidii kwa uhakika kuchunguza au kuorodhesha. Viungo vya ndani vya nguvu bado vina umuhimu. Unaweza kuongeza URL kamili ya Sitemap katika robots.txt, lakini usiweke orodha ya URL za kibinafsi, zilizorejeshwa (redirected), zilizozuiwa na robots, au zinazokusudiwa kuwa noindex. Rekebisha matokeo ya sitemap na sheria za robots wakati wa uzinduzi.

Noindex sio agizo la robots.txt la Google. Google inaunga mkono noindex katika meta tag ya HTML au kichwa cha majibu cha X-Robots-Tag HTTP, na lazima ichunge (crawl) mwitikio ili kuiona. Ikiwa ukurasa wa umma unahitaji kuondoka katika matokeo ya Google, ondoa kizuizi chochote cha robots kinachoficha noindex. Ikiwa maudhui si ya umma, usitangaze njia yake katika robots.txt; tekeleza udhibiti wa ufikiaji. Mipaka ya data nyeti inahitaji mapitio yaliyohitimu.

Tamko la Sitemap

Tumia URL kamili, kwa mfano Sitemap: https://www.example.com/sitemap.xml; haivunji kizuizi cha kuchunguza.

HTML na faili

Tumia meta noindex kwa HTML au kichwa cha majibu X-Robots-Tag: noindex pale inafaa, kisha jaribu mwitikio wa moja kwa moja.

Ufunuo wa dharura

Kataza ufikiaji kwanza wakati maudhui ni nyeti, kisha tumia mchakato wa kuondoa wa injini ya utafutaji inapofaa.

05

Pima na uitoe kama faili muhimu ya usanidi

Thibitisha maandishi yaliyoruhusiwa kwa ndani, kisha jaribu mifano iliyoruhusiwa na iliyofunguliwa kwa kikundi kinachokusudiwa cha vichunguzi. Baada ya utekelezaji, chukua /robots.txt ya umma kwa faragha au kwa ombi la moja kwa moja la HTTP ili kuthibitisha yaliyomo, asili, na hali ya majibu. Google hutoa ripoti ya robots.txt kwenye Search Console kwa mafaili yanayopatikana na maktaba ya parser ya chanzo huria kwa majaribio ya ndani.

Vichunguzi vinaweza kuhifadhi nakala za faili za robots, hivyo usiahidi ugundulaji au mabadiliko ya kuorodhesha mara moja. Makosa ya seva au mtandao hupelekea vichunguzi kudhani disallow kamili, wakati 4xx inaweza kuruhusu ufikiaji. Weka faili kwenye usanidi ulio chini ya udhibiti wa chanzo, hitaji mapitio ya ziada kwa mabadiliko ya tovuti nzima au wildcards, na huhifadhi toleo la awali. SIU preflights na mipango ya kurudisha nyuma husaidia kugundua uzinduzi mbaya kabla haujabadilika kuwa tatizo kubwa la upatikanaji au ugundulizi.

Kipenyo cha uzinduzi

Hitaji mhariri wa pili kwa uhamishaji wa origin, vizuizi vya tovuti nzima, wildcards, na mabadiliko yanayoathiri sign-in, checkout, au njia za msaada.

Ishara ya kurudisha nyuma

Rudisha toleo la awali wakati URL muhimu ya sampuli imeshatambuliwa kama imezuiwa, mali muhimu haipatikani, au endpoint haipatikani.

Kikomo

Mtihani mmoja wa mchunguzi hauhakikishi kwamba kila mteja wa otomatiki ataelewa kila sheria kwa njia ile ile.

KITENDO / THIBITISHA

Mwongozo wako wa vitendo.

  1. 01

    Panga lengo

    Chagua usimamizi wa kuchavua, kutokuweka kwenye orodha (index exclusion), au upatikanaji wa kibinafsi kabla ya kuchagua udhibiti.

    THIBITISHA: Kila URL iliyoguswa ina kusudi iliyoratibiwa na mmiliki aliyesemwa.
  2. 02

    Ramani asili (Map the origin)

    Tambua protocol halisi, host, port, subdomain, CDN, na asili ya programu inayohusika.

    THIBITISHA: Hakuna asili inayoachwa ichukue kanuni za robots za asili nyingine.
  3. 03

    Orodhesha URL za uwakilishi

    Jumuisha kurasa muhimu, malengo, tofauti, mali, kumbukumbu za sitemap, na njia binafsi.

    THIBITISHA: Jedwali linaeleza matokeo yanayotarajiwa kwa kila URL ya jaribio.
  4. 04

    Andika kanuni nyembamba

    Tumia User-agent, Allow, na Disallow wazi; epuka wildcards pana isipokuwa zinahitajika.

    THIBITISHA: Mkaguzi anaweza kuelezea wigo na ubaguzi wa kila kanuni.
  5. 05

    Tekeleza noindex kwa usahihi

    Tumia tag ya meta au kichwa cha jibu kwa yaliyomo ya umma yaliyoamezwa kutoka Google.

    THIBITISHA: Lengo la moja kwa moja linaweza kuchavuliwa na linaonyesha noindex kwa crawler.
  6. 06

    Linda nyenzo zisizo za umma

    Tumia uthibitisho au udhibiti wa seva na programu, sio robots.txt.

    THIBITISHA: Ombo lisilo na uthibitisho haliwezi kupata yaliyomo nyeti.
  7. 07

    Chapisha faili iliyokubaliwa

    Tekeleza maandishi wazi ya UTF-8 kwenye mzizi wa asili.

    THIBITISHA: URL ya moja kwa moja /robots.txt inarejesha faili iliyopitiwa.
  8. 08

    Jaribu mwenendo wa moja kwa moja

    Kagua sampuli zilizoruhusiwa na zilizozuiliwa kwa zana zinazofaa.

    THIBITISHA: Matokeo yanaendana na jedwali la uzinduzi, pamoja na isipokuwa.
  9. 09

    Linganya vyanzo vya ugunduzi

    Weka sitemap na malengo ya viungo vya ndani vinavyolingana na maamuzi ya kuchavua na kuorodheshwa.

    THIBITISHA: Hakuna URL ya kusudi ya faragha, inayorejelea, noindex, au iliyozuiliwa katika sitemap bila sababu.
  10. 10

    Iwe tayari kurudisha toleo la awali

    Hifadhi faili ya awali na ongeza mabadiliko ya kanuni kwenye taratibu za uzinduzi na urejesho.

    THIBITISHA: Toleo la kujua-litakavyofanya kazi na mmiliki wa kurudisha linapatikana mara moja.
MADA ZA MAJADILIANO

Linganisha faida na hasara, si data binafsi.

Tumia vichocheo hivi na timu yako au jamii ya wamiliki wa tovuti. Shiriki mbinu na masomo, lakini usibandike kamwe taarifa za uthibitishaji, rekodi za wateja, au maelezo ya miundombinu yasiyo ya umma.

  1. 01

    Ni mifumo gani ya URL za umma inayosababisha kazi ya crawler kwenye tovuti yako, na ni ushahidi gani uliokusaidia kutofautisha tatizo halisi na utofauti usio na madhara?

  2. 02

    Je, timu yako inakagua mabadiliko ya robots.txt pamoja na sitemap, kakanoni (canonical), na maamuzi ya udhibiti wa upatikanaji kabla ya uzinduzi vipi?

  3. 03

    Ni ishara gani ya kurudisha ambayo ingesema timu yako kuwa kanuni mpya ya crawler inadhuru njia muhimu za watumiaji au biashara?

RASIMALI MAARUFU / ZINAZOAMINIKA

Fungua nyenzo za chanzo.

Google Search CentralIntroduction to robots.txt ↗

Inaelezea matumizi yaliyokusudiwa ya Google, mipaka ya matokeo ya utafutaji, na mipaka ya usalama kwa robots.txt.

Imehakikiwa 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

Rejea ya viwango (standards-track) kwa sintaksia, ulinganifu, wigo, makosa, caching, na mipaka ya usalama.

Imehakikiwa 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Inaonyesha matumizi ya meta-tag ya noindex na kichwa cha majibu cha HTTP na kwanini jibu lazima libaki kuchavuliwa.

Imehakikiwa 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Inashughulikia upangaji, sintaksia inayounga mkono, tamko la sitemap, na chaguo za upimaji.

Imehakikiwa 2026-09-27
Google Search CentralLearn about sitemaps ↗

Inaweka wazi faida za ugunduzi wa sitemap, mipaka yake, na umuhimu wa viungo vya ndani.

Imehakikiwa 2026-09-27
MDN Web DocsHTTP authentication ↗

Muhtasari wa udhibiti wa upatikanaji wa HTTP na masuala ya HTTPS kwa uthibitisho.

Imehakikiwa 2026-09-27

Sera ya vyanzo. Makala hii inatumia viungo vya viwango vya msingi na nyaraka rasmi. Thibitisha usanidi wa bidhaa maalum dhidi ya nyaraka za jukwaa za sasa kabla ya uzinduzi.

MAELEZO YA HARAKA

Maswali ya kawaida.

Je, robots.txt inaweza kuzuia ukurasa kutoka Google Search?

Hapana. URL iliyozuilwa bado inaweza kugunduliwa na kuonekana katika matokeo. Tumia noindex inayoweza kuchavuliwa kwa yaliyomo ya umma ambayo hayapaswi kuorodheshwa, na tumia udhibiti wa upatikanaji kwa yaliyomo binafsi.

Ni robots.txt gani salama kuanzia nayo?

Anza bila vizuizi isipokuwa unaweza kuandika mahitaji ya kusimamia kuchavua. Ongeza tu njia nyembamba ambazo umejaribu dhidi ya kurasa na rasilimali muhimu.

Je, sitemap inapaswa kutajwa katika robots.txt?

Inaweza kutajwa. Mwisho wa mstari wa Sitemap kamili husaidia ugunduzi wa crawlers lakini haisukumi kuchavua au kuorodheshwa, na haisababisha override ya block ya robots.

Status Is UP Editorial Team · Waandishi wa Uptime Enablement

Imehakikiwa na Mkaguzi wa SEO wa kiufundi na jukwaa la wavuti; ongeza ukaguzi wa usalama kwa maamuzi ya udhibiti wa upatikanaji au yaliyomo nyeti.. Ilichapishwa 2026-09-27; imesasishwa 2026-09-30.