
STATUS IS UPWIKI NG PAG-OPTIMIZE NG WEBSITE
32Patibayin
SEO at kakayahang matagpuan / Patibayin

Patnubay sa robots.txt: Kontrolin ang Crawling nang Hindi Tinatakpan ang mga Pagkakamali

Gamitin ang robots.txt para gabayan ang access ng crawler, at ipares ito sa tamang paraan ng pag-index o kontrol sa pag-access ayon sa pangangailangan.

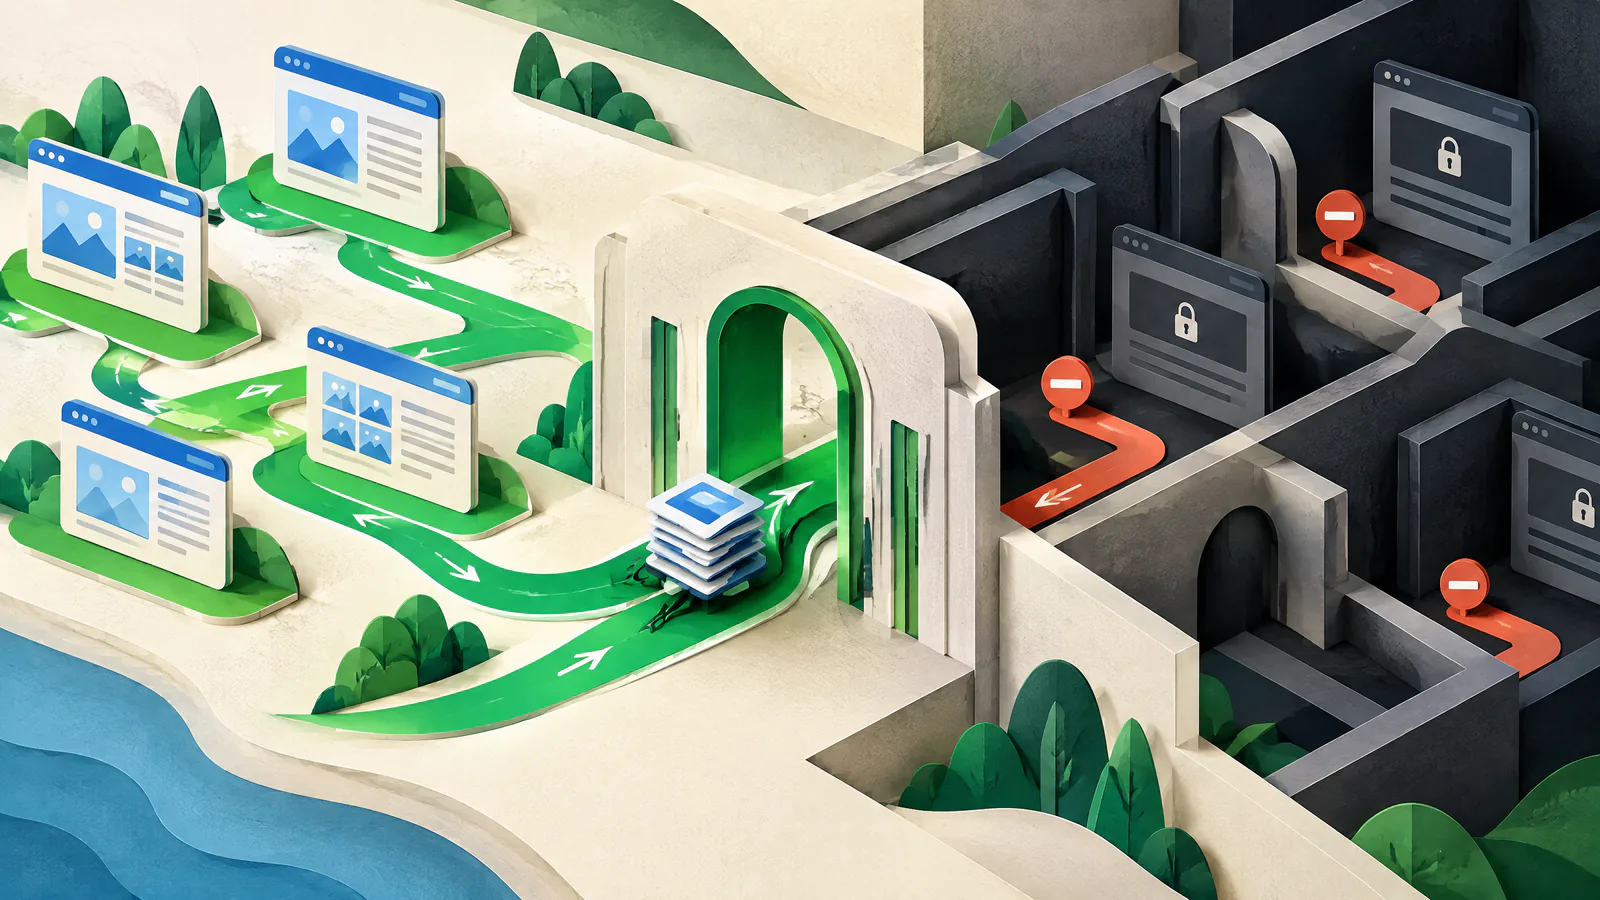
Patnubay sa robots.txt: Kontrolin ang Crawling nang Hindi Tinatakpan ang mga Pagkakamali — BISWAL NA GABAY
BASAHIN
8 minuto
PINAGMULAN
6
MULING SURIIN
2027-03-27
sinuri
Technical SEO at web platform reviewer; magdagdag ng security review para sa mga desisyon tungkol sa access-control o sensitibong nilalaman.
MAIKLING SAGOT

Magsimula sa desisyon.

Gamitin ang robots.txt para gabayan ang mga sumusunod na crawler (compliant crawlers) na iwasan ang mga partikular na pattern ng publikong URL na nagdudulot ng hindi kinakailangang trabaho sa crawling. Maglathala ng UTF-8 plain-text na file sa root ng eksaktong origin ng site at magsimula sa iilang tuntunin. Ito ay isang signal para sa access ng crawler, hindi isang kandado, at hindi nito kailanman itinatago ang isang pagkakamali.

Hindi maaasahang itinatago o pinoprotektahan ng robots.txt ang isang pahina. Maaaring madiskubre pa rin ang isang naka-block na URL sa pamamagitan ng mga link. Para sa publikong nilalaman na hindi dapat ma-index, gamitin ang noindex habang pinapayagang i-fetch ng crawler ang tugon. Para sa pribadong materyal, ipatupad ang kontrol sa pag-access sa server o application.

Tratuhin ang mga edit bilang production configuration: tukuyin ang origin, subukan ang mga tinukoy na URL, kunin ang live na /robots.txt, at panatilihing handa ang naunang bersyon. Sinusuportahan ng SIU ang proaktibong availability at remediation sa pamamagitan ng paunang pagsusuri (preflight) at disiplina sa rollback, hindi sa pamamagitan ng outage alerts o status reporting.

BISWAL NA GABAY

Tingnan ang gawain bilang isang sistema.

Gamitin ang mapang ito para iugnay ang mga desisyon sa artikulo bago kumilos sa mga indibidwal na taktika.

SIUPatibayin
01Pumili ng kontrol na tumutugma sa hangarin
02Gamitin ang core syntax at saklaw nang eksakto
03I-block lamang ang mga pattern na suportado ng ebidensya ng URL
04Panatilihing magkakaugnay ang sitemap discovery, noindex, at mga desisyon sa privacy
01

Pumili ng kontrol na tumutugma sa hangarin

Ang crawling ay awtomatikong pagkuha (retrieval) ng isang URL. Ang indexing ay ang pagpapasya ng search engine kung i-susulat at ipapakita ang impormasyon tungkol dito. Ang access control ay tumutukoy kung sino ang maaaring makuha ang nilalaman. Ang robots.txt ay tungkol sa crawling, at ang mga sumusunod na crawler ang nagdedesisyon kung susundin nila ito. Ayon sa IETF Robots Exclusion Protocol, hindi ito authorization.

Gumamit ng Disallow rule para pamahalaan ang access ng crawler sa isang publikong path na mababa ang halaga, gaya ng isang kontroladong internal-search route. Gumamit ng noindex para sa publikong nilalaman na hindi dapat lumabas sa suportadong resulta ng search. Gumamit ng totoong kontrol sa access para sa mga preview, account area, export, o sensitibong data. Para sa customer, empleyado, pagbabayad, o reguladong impormasyon, kumuha ng kwalipikadong security at platform review; hindi kailanman isang compensating control ang robots.txt.

Crawl management

Maaaring hilingin ng robots.txt na iwasan ng mga sumusunod na crawler ang isang tinukoy na publikong path; hindi nito ginagarantiya ang pagtanggal mula sa mga resulta.

Index control

Gumamit ng noindex sa HTML o sa X-Robots-Tag header, at iwanang crawlable ang tugon para mabasa ang instruksyon.

Private content

Kailangan ng authentication o angkop na kontrol ng application o server, at pagkatapos alisin ang URL mula sa pampublikong discovery paths.

02

Gamitin ang core syntax at saklaw nang eksakto

Maglathala ng UTF-8 plain-text na robots.txt sa /robots.txt para sa bawat scheme, host, at port na nangangailangan ng mga tuntunin. Ang file sa https://www.example.com/robots.txt ay hindi awtomatikong kumokontrol sa https://example.com, isang subdomain, o isang HTTP origin. Beripikahin ang mga origin na hinihain ng canonical URLs, redirects, CDN, at application bago ipalagay na naaangkop ang isang tuntunin.

Nagsisimula ang isang group sa User-agent at gumagamit ng Allow o Disallow paths. Ang User-agent: * ay ang pangkalahatang grupo. Case-sensitive ang matching at nagsisimula sa simula ng path. Ang pinaka-specific na matching rule ang nananalo; dapat manalo ang isang pantay na specific na Allow laban sa Disallow. Ang Disallow: ay hindi nagba-block ng anuman, samantalang ang Disallow: / ay nagba-block ng buong origin. Tinukoy ng standard ang # para sa comments, * para sa wildcard, at $ para sa dulo ng pattern.

Pinakamaliit na baseline

Kung walang dokumentadong pangangailangan sa crawl-management, huwag magdagdag ng exclusions; huwag gumawa ng speculative blocks.

Ligtas na pattern

Mas piliin ang isang matatag, makitid na prefix gaya ng /search/ kaysa sa maluwag na wildcard o hindi ipinaliwang filename rule.

Comments

Itala ang layunin ng tuntunin, may-ari, at reference ng pagbabago, ngunit huwag ituring ang comments bilang pamalit sa review.

03

I-block lamang ang mga pattern na suportado ng ebidensya ng URL

Bago magsulat ng tuntunin, imbentaryo ang mga importanteng pahina, hindi gustong crawl paths, query variants, on-site search, preview routes, assets, at sitemap URLs. Para sa bawat sample URL, itala ang inaasahang resulta at katugmang rule. Ihambing ang listahan sa canonical URLs at live navigation para hindi maitago ng block ang isang kapaki-pakinabang na ruta.

Panatilihing available ang mga browser-critical na resources maliban na lang kung nasubukan nang iba. Binibigyang-diin ng Google na ang pag-block ng CSS, JavaScript, images, o ibang resources ay maaaring magpahirap sa pagsusuri ng pahina. Hindi nilulutas ng robots.txt ang duplicate-content selection, authorization, o page quality; gumamit ng canonicalization, redirects, access controls, o content work kung nararapat.

Ebidensya muna

Gumamit ng totoong URL samples at server o crawl evidence, hindi isang generic na listahang kinopya mula sa ibang site.

Change table

Panatilihin ang bawat sample URL, inaasahang resulta, matched rule, at may pananagutang may-ari sa release record.

04

Panatilihing magkakaugnay ang sitemap discovery, noindex, at mga desisyon sa privacy

Ang sitemap ay nagsasabi sa search engines kung aling mga URL at file ang itinuturing mong mahalaga; makakatulong ito sa discovery ngunit hindi ginagarantiyahan ang crawling o indexing. Mahalaga pa rin ang malalakas na internal links. Maaari kang magdagdag ng fully qualified na Sitemap URL sa robots.txt, ngunit huwag ilista ang pribado, redirected, robots-blocked, o intentional na noindex na URL. I-reconcile ang output ng sitemap sa robots rules sa release.

Ang noindex ay hindi isang directive ng Google robots.txt. Sinusuportahan ito ng Google sa isang HTML meta tag o X-Robots-Tag HTTP response header, at kailangan nilang i-crawl ang tugon para makita ito. Kung ang isang publikong pahina ay kailangang lumabas sa Google results, alisin ang anumang robots block na nagtatago ng noindex. Kung ang nilalaman ay nonpublic, huwag i-advertise ang path nito sa robots.txt; ipatupad ang access control. Ang mga hangganan ng sensitibong data ay nangangailangan ng kwalipikadong review.

Sitemap declaration

Gumamit ng full URL, halimbawa Sitemap: https://www.example.com/sitemap.xml; hindi nito nire-override ang crawl block.

HTML at files

Gumamit ng meta noindex para sa HTML o ng X-Robots-Tag: noindex response header kung angkop, at pagkatapos subukan ang live na tugon.

Agarang exposure

Limitahan muna ang access kapag sensitibo ang nilalaman, at pagkatapos gamitin ang removal process ng search engine kung nararapat.

05

Subukan at i-release ito tulad ng isang kritikal na configuration file

I-validate ang aprubadong teksto nang lokal, pagkatapos subukan ang pinapayagan at hindi pinapayagang mga halimbawa para sa inaasahang crawler group. Pagkatapos i-deploy, i-retrieve ang pampublikong /robots.txt nang pribado o sa pamamagitan ng direktang HTTP request para tiyakin ang nilalaman, origin, at response status. Nag-aalok ang Google ng Search Console robots.txt report para sa accessible na mga file at isang open-source parser library para sa lokal na testing.

Maaaring mag-cache ang mga crawler ng robots file, kaya huwag mag-asang agarang pagbabago sa discovery o indexing. Ang mga error sa server o network ay nag-uudyok sa mga crawler na ipalagay ang kumpletong disallow, habang ang 4xx ay maaaring magpayag ng access. Ilagay ang file sa source-controlled configuration, mangailangan ng dagdag na review para sa whole-site o wildcard changes, at panatilihin ang naunang bersyon. Nakakatulong ang SIU preflights at rollback planning upang mahuli ang isang maling release bago ito lumaki bilang availability o discoverability problem.

Release gate

Mangailangan ng pangalawang reviewer para sa origin migrations, whole-site blocks, wildcards, at mga pagbabago na nakakaapekto sa sign-in, checkout, o support routes.

Rollback signal

I-restore ang naunang bersyon kapag isang mahalagang sample URL ay bagong na-block, isang kailangang asset ay hindi maa-access, o ang endpoint ay hindi available.

Limit

Isang crawler test lamang ay hindi nagpapatunay na bawat automated client ay i-interpret ang bawat rule sa parehong paraan.

AKSYON / SURIIN

Ang praktikal mong gabay sa mga dapat gawin.

  1. 01

    I-klasipika ang layunin

    Pumili ng crawl management, index exclusion, o private access bago pumili ng kontrol.

    SURIIN: Ang bawat apektadong URL ay may dokumentadong layunin at may pananagutang may-ari.
  2. 02

    I-map ang origin

    Tukuyin ang eksaktong protocol, host, port, subdomain, CDN, at app origin na kasangkot.

    SURIIN: Walang origin na ipinapalagay na nagmamanahin ng robots rules ng ibang origin.
  3. 03

    Itala ang mga representatibong URL

    Isama ang importanteng pahina, target, variants, assets, sitemap entries, at pribadong ruta.

    SURIIN: May isang talahanayan na nagngangalang ang inaasahang resulta para sa bawat test URL.
  4. 04

    Sumulat ng makitid na mga tuntunin

    Gumamit ng malinaw na User-agent, Allow, at Disallow paths; iwasan ang malawak na wildcards maliban kung kinakailangan.

    SURIIN: Makakabigay ang reviewer ng paliwanag tungkol sa saklaw at mga eksepsyon ng bawat tuntunin.
  5. 05

    Ipatupad nang tama ang noindex

    Gumamit ng meta tag o response header para sa publikong nilalaman na excluded mula sa Google.

    SURIIN: Ang live target ay crawlable at nagpapakita ng noindex sa crawler.
  6. 06

    Protektahan ang hindi-pampublikong materyal

    Gumamit ng authentication o server at application controls, hindi robots.txt.

    SURIIN: Ang isang hindi-authenticated na request ay hindi makakakuha ng sensitibong nilalaman.
  7. 07

    I-publish ang aprubadong file

    I-deploy ang UTF-8 plain text sa root ng origin.

    SURIIN: Ang live na /robots.txt URL ay nagbabalik ng nirbyuwang file.
  8. 08

    Subukan ang live na pag-uugali

    Suriin ang pinapayagan at naka-block na mga sample gamit ang angkop na tooling.

    SURIIN: Tumutugma ang mga resulta sa release table, kabilang ang mga eksepsyon.
  9. 09

    I-reconcile ang mga input ng discovery

    Panatilihin ang sitemap at internal-link targets na pare-pareho sa crawl at index desisyon.

    SURIIN: Walang sinadya at pribado, redirected, noindex, o blocked na URL sa sitemap nang walang dahilan.
  10. 10

    Panatilihing handa ang rollback

    I-imbak ang naunang file at idagdag ang pagbabago ng rule sa launch at recovery procedures.

    SURIIN: Agad na matutukoy ang isang known-good version at rollback owner.
MGA PAKSA NG TALAKAYAN

Ihambing ang mga trade-off, hindi ang pribadong data.

Gamitin ang mga prompt na ito kasama ang iyong koponan o komunidad ng may-ari ng website. Magbahagi ng mga pamamaraan at aral, ngunit huwag kailanman ipaste ang mga kredensyal, rekord ng customer, o hindi-pampublikong detalye ng imprastruktura.

  1. 01

    Aling mga publikong pattern ng URL ang lumilikha ng crawler work sa iyong site, at anong ebidensya ang tumulong sa inyo na pag-ibahin ang tunay na problema mula sa walang-kabuluhang variasyon?

  2. 02

    Paano nire-review ng iyong team ang pagbabago sa robots.txt kasama ang sitemap, canonical, at access-control na mga desisyon bago ang isang launch?

  3. 03

    Anong rollback signal ang magsasabi sa iyong team na nakakasama ang bagong crawler rule sa isang mahalagang user o business path?

Sikat / Awtoritatibong mapagkukunan

Buksan ang pinagmulang materyal.

Google Search CentralIntroduction to robots.txt ↗

Ipinaliliwanag ang inaasahang gamit ng Google, limitasyon sa search-result, at limitasyon sa seguridad para sa robots.txt.

Sinuri 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

Ang standards-track reference para sa syntax, matching, saklaw, errors, caching, at security limits.

Sinuri 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Ipinapakita ang paggamit ng noindex meta-tag at HTTP-header at bakit kailangang manatiling crawlable ang tugon.

Sinuri 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Sinasaklaw ang paglalagay, suportadong syntax, sitemap declarations, at testing options.

Sinuri 2026-09-27
Google Search CentralLearn about sitemaps ↗

Nililinaw ang benepisyo at limitasyon ng sitemap discovery, at ang kahalagahan ng internal links.

Sinuri 2026-09-27
MDN Web DocsHTTP authentication ↗

Isang pangkalahatang-ideya ng HTTP access control at HTTPS considerations para sa authentication.

Sinuri 2026-09-27

Patakaran sa pinagkukunan. Ginamit ng artikulong ito ang naka-link na primary standards at opisyal na dokumentasyon. Beripikahin ang product-specific na configuration laban sa kasalukuyang dokumentasyon ng platform bago mag-release.

Mabilis na paglilinaw

Karaniwang mga tanong.

Maaari bang panatilihing wala sa Google Search ang isang pahina gamit ang robots.txt?

Hindi. Maaaring madiskubre pa rin at lumabas sa resulta ang isang naka-block na URL. Gumamit ng crawlable noindex para sa publikong nilalaman na hindi dapat ma-index, at gamitin ang access control para sa pribadong nilalaman.

Ano ang pinakaligtas na panimulang robots.txt file?

Magsimula nang walang exclusions maliban kung maidadokumento mo ang isang pangangailangan sa crawl-management. Magdagdag lamang ng makitid na paths na nasubukan mo laban sa importanteng pahina at resources.

Dapat bang ilista ang sitemap sa robots.txt?

Maaring ilagay. Nakakatulong ang isang fully qualified Sitemap line sa discovery ng crawler ngunit hindi nito pinipilit ang crawling o indexing, at hindi nito nire-override ang isang robots block.

Status Is UP Editorial Team · Mga Editor ng Uptime Enablement

Sinuri ni Technical SEO at web platform reviewer; magdagdag ng security review para sa mga desisyon tungkol sa access-control o sensitibong nilalaman.. Inilathala 2026-09-27; na-update 2026-09-30.