
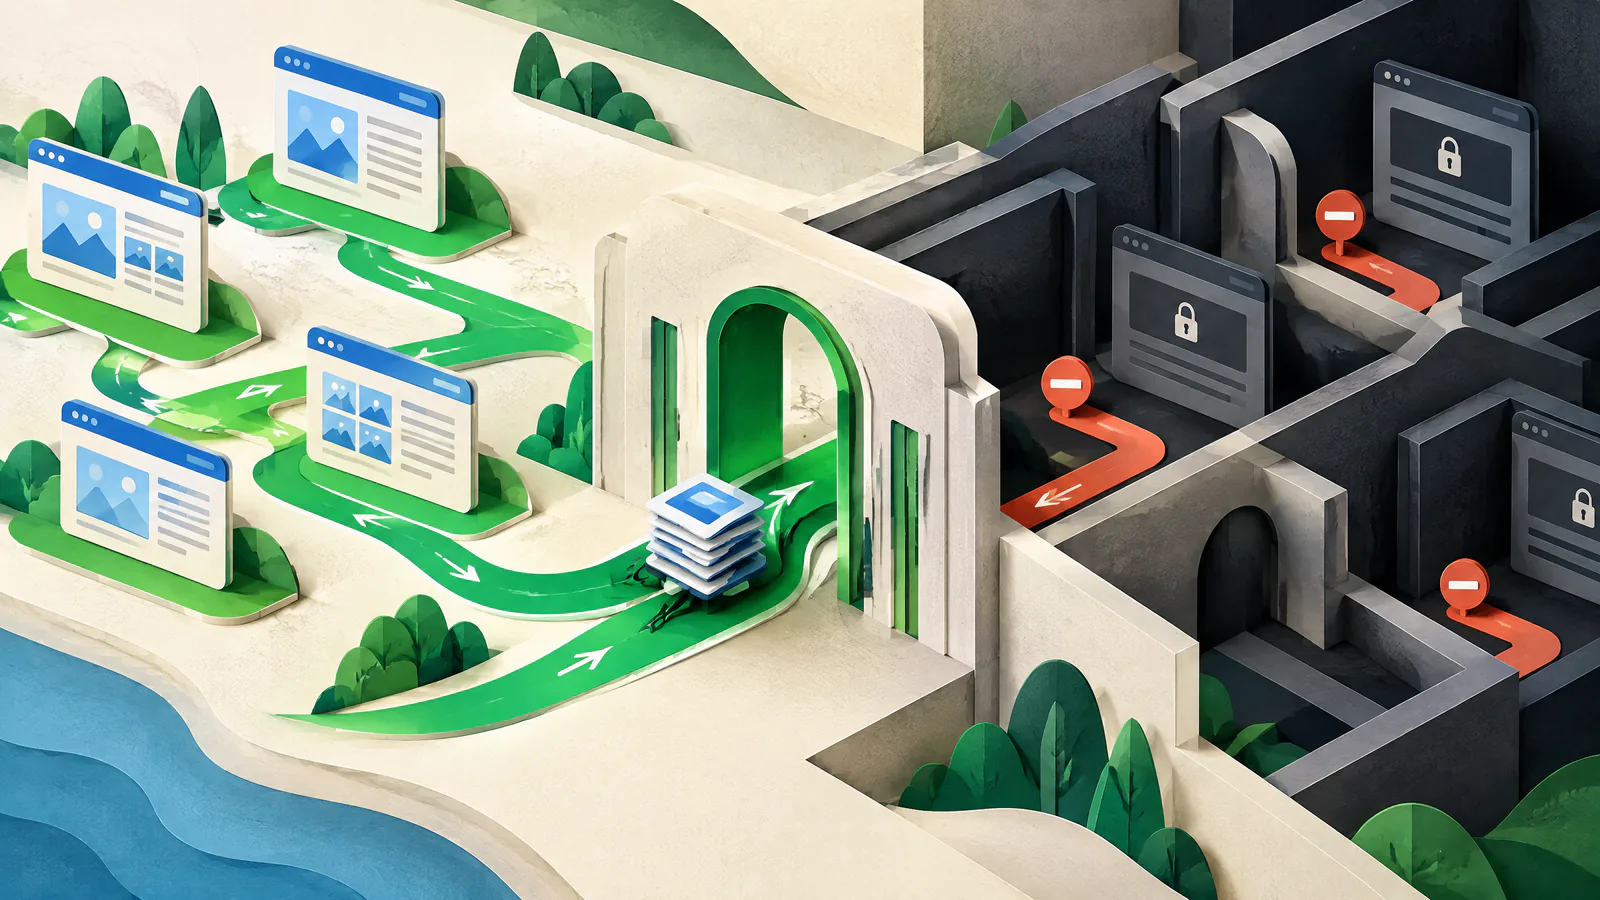
जिस परिणाम से मेल खाता नियंत्रण चुनें
क्रॉलिंग किसी URL का स्वचालित पुनर्प्राप्ति है। इंडेक्सिंग वह निर्णय है कि सर्च इंजन किसी URL की जानकारी संग्रहीत और प्रदर्शित करेगा या नहीं। एक्सेस कंट्रोल तय करता है कि कौन सामग्री प्राप्त कर सकता है। Robots.txt क्रॉलिंग से संबंधित है, और अनुरूपकर्ता (compliant) क्रॉलर यह चुनते हैं कि वे इसे फॉलो करें या नहीं। IETF Robots Exclusion Protocol कहता है कि यह प्राधिकरण (authorization) नहीं है।
किसी पब्लिक, कम‑मूल्य पथ जैसे नियंत्रित अंदरूनी‑सर्च मार्ग के लिए क्रॉलर एक्सेस को मैनेज करने हेतु Disallow नियम का उपयोग करें। पब्लिक सामग्री जिसे दिखना नहीं चाहिए उसके लिए noindex का उपयोग करें। प्रीव्यू, अकाउंट एरिया, एक्सपोर्ट, या संवेदनशील डेटा के लिए असली एक्सेस कंट्रोल लागू करें। ग्राहक, कर्मचारी, भुगतान, या विनियमित जानकारी के लिए योग्य सुरक्षा और प्लेटफ़ॉर्म समीक्षा प्राप्त करें; robots.txt कभी भी भुगतान करने वाला नियंत्रण (compensating control) नहीं है।
Robots.txt अनुरोध कर सकता है कि अनुरूपकर्ता क्रॉलर एक परिभाषित सार्वजनिक पाथ से बचें; यह परिणाम से हटाने की गारंटी नहीं देता।
HTML में या X-Robots-Tag हेडर में noindex का उपयोग करें, और निर्देश पढ़ने के लिए response को क्रॉल करने योग्य छोड़ें।
प्रामाणिककरण (authentication) या उपयुक्त एप्लिकेशन/सर्वर नियंत्रण आवश्यक करें, फिर URL को सार्वजनिक डिस्कवरी पाथ्स से हटा दें।
मुख्य सिंटैक्स और स्कोप को सटीक रूप से उपयोग करें
हर उस scheme, host, और port के लिए जिन पर नियम चाहिए, /robots.txt पर UTF-8 plain-text फ़ाइल प्रकाशित करें। https://www.example.com/robots.txt पर फ़ाइल अपने आप https://example.com, किसी उपडोमेन, या HTTP origin को नियंत्रित नहीं करती। नियम मानने से पहले canonical URLs, redirects, CDN, और एप्लिकेशन द्वारा परोसे जाने वाले origins की पुष्टि करें।
एक समूह User-agent से शुरू होता है और उसके बाद Allow या Disallow पथ आते हैं। User-agent: * सामान्य समूह है। मिलान केस‑सेंसिटिव (case-sensitive) होता है और पथ की शुरुआत से होता है। सर्वाधिक विशिष्ट मिलान करने वाला नियम जीतता है; समान‑विशिष्ट Allow को Disallow पर प्राथमिकता मिलनी चाहिए। Disallow: कुछ भी ब्लॉक नहीं करता है, जबकि Disallow: / पूरे origin को ब्लॉक कर देता है। मानक में टिप्पणी के लिए #, वाइल्डकार्ड के लिए *, और पैटर्न के अंत के लिए $ परिभाषित हैं।
यदि कोई स्पष्ट क्रॉल‑मैनेजमेंट आवश्यकता दस्तावेज़ित नहीं है, तो कोई बहिष्करण न जोड़ें; सट्टा ब्लॉक्स न बनाएं।
ढीले वाइल्डकार्ड या अस्पष्टीकृत फ़ाइलनाम नियम के बजाय /search/ जैसे स्थिर, संकुचित प्रिफिक्स को तरजीह दें।
नियम का उद्देश्य, मालिक, और परिवर्तन संदर्भ दर्ज करें, पर टिप्पणियों को समीक्षा की जगह न बनाएं।
केवल उन पैटर्न को ब्लॉक करें जिनका समर्थन URL साक्ष्य करता है
नियम लिखने से पहले महत्वपूर्ण पृष्ठों, अवांछित क्रॉल पाथ्स, क्वेरी वेरिएंट्स, ऑन‑साइट सर्च, प्रीव्यू रूट्स, संपत्ति (assets), और sitemap URLs का इन्वेंटरी बनाएं। प्रत्येक नमूना URL के लिए अपेक्षित परिणाम और मेल खाने वाला नियम रिकॉर्ड करें। सूची की तुलना canonical URLs और लाइव नेविगेशन से करें ताकि कोई ब्लॉक उपयोगी मार्ग को छिपा न दे।
ब्राउज़र‑निहित संसाधनों को उपलब्ध रखें जब तक कि अलग से परीक्षण न किया गया हो। Google चेतावनी देता है कि CSS, JavaScript, इमेजेस या अन्य संसाधनों को ब्लॉक करने से एक पृष्ठ का विश्लेषण कठिन हो सकता है। Robots.txt डुप्लिकेट‑कंटेंट चयन, प्राधिकरण, या पेज गुणवत्ता का समाधान नहीं है; जहाँ उपयुक्त हो वहाँ canonicalization, redirects, एक्सेस कंट्रोल, या सामग्री सुधार का उपयोग करें।
किसी अन्य साइट से कॉपी की गई सामान्य सूची के बजाय वास्तविक URL नमूने और सर्वर/क्रॉल साक्ष्य का उपयोग करें।
प्रत्येक नमूना URL, इच्छित परिणाम, मेल खाने वाला नियम, और उत्तरदायी मालिक को रिलीज रिकॉर्ड में रखें।
Sitemap खोज, noindex, और गोपनीयता निर्णयों को सुसंगत रखें
एक sitemap सर्च इंजनों को बताता है कि आप किन URL और फ़ाइलों को महत्वपूर्ण मानते हैं; यह खोज में मदद कर सकता है पर crawling या indexing की गारंटी नहीं देता। मजबूत आंतरिक लिंक अभी भी मायने रखते हैं। आप robots.txt में एक पूरी तरह योग्य Sitemap URL जोड़ सकते हैं, पर निजी, रीडायरेक्टेड, robots‑blocked, या जानबूझकर noindex URL न जोड़ें। रिलीज़ पर sitemap आउटपुट को robots नियमों के साथ मेल कराएँ।
Noindex Google की robots.txt निर्देशिका नहीं है। Google HTML meta टैग या X-Robots-Tag HTTP response हेडर में इसका समर्थन करता है, और इसे देखने के लिए response को क्रॉल करना आवश्यक है। यदि किसी सार्वजनिक पेज को Google रिजल्ट से हटाना है, तो कोई ऐसा robots ब्लॉक हटाएँ जो noindex को छुपा रहा हो। यदि सामग्री गैर‑पब्लिक है, तो उसका पाथ robots.txt में प्रचारित न करें; एक्सेस कंट्रोल लागू करें। संवेदनशील‑डेटा सीमा के लिए योग्य समीक्षा आवश्यक है।
एक पूर्ण URL का उपयोग करें, उदाहरण: Sitemap: https://www.example.com/sitemap.xml; यह क्रॉल ब्लॉक को ओवरराइड नहीं करता।
HTML के लिए meta noindex या जहाँ उपयुक्त हो X-Robots-Tag: noindex response हेडर का उपयोग करें, फिर लाइव response का परीक्षण करें।
जब सामग्री संवेदनशील हो तो पहले एक्सेस प्रतिबंधित करें, फिर जहाँ उपयुक्त हो सर्च इंजन के रिमूवल प्रोसेस का उपयोग करें।
इसे एक संवेदनशील कॉन्फ़िगरेशन फ़ाइल की तरह टेस्ट और रिलीज़ करें
स्वीकृत टेक्स्ट को लोकली वैलिडेट करें, फिर इच्छित क्रॉलर समूह के लिए अनुमत और अस्वीकृत उदाहरणों का परीक्षण करें। परिनियोजन के बाद, सार्वजनिक /robots.txt को निजी तौर पर या सीधे HTTP अनुरोध द्वारा पुनः प्राप्त करके सामग्री, origin, और response status की पुष्टि करें। Google Search Console robots.txt रिपोर्ट सुलभ फ़ाइलों के लिए और स्थानीय परीक्षण हेतु खुला‑स्रोत parser लाइब्रेरी उपलब्ध कराता है।
क्रॉलर robots फ़ाइलों को कैश कर सकते हैं, इसलिए तुरंत खोज या इंडेक्स बदलाव की गारंटी न दें। सर्वर या नेटवर्क त्रुटियाँ क्रॉलरों को पूर्ण disallow मानने के लिए प्रेरित कर सकती हैं, जबकि 4xx स्थिति कभी‑कभी पहुंच की अनुमति दे सकती है। फ़ाइल को सोर्स‑कंट्रोल्ड कॉन्फ़िगरेशन में रखें, ऑरिजिन‑माइग्रेशन, पूरे‑साइट या वाइल्डकार्ड परिवर्तन के लिए अतिरिक्त समीक्षा आवश्यक करें, और पूर्व वर्जन बनाए रखें। SIU प्रीफ़्लाइट और रोलबैक योजना एक ख़राब रिलीज़ को बड़ी उपलब्धता या खोजयोग्यता समस्या बनने से पहले पकड़ने में मदद करती है।
ओरिजिन माइग्रेशन, पूरे‑साइट ब्लॉक्स, वाइल्डकार्ड, और साइन‑इन, चेकआउट, या सपोर्ट रूट को प्रभावित करने वाले परिवर्तनों के लिए दूसरे समीक्षक की आवश्यकता रखें।
जब कोई महत्वपूर्ण नमूना URL नया ब्लॉक हो, कोई आवश्यक एसेट असुलभ हो, या endpoint अनुपलब्ध हो, तो पहले वाला वर्जन पुनर्स्थापित करें।
एक क्रॉलर परीक्षण यह साबित नहीं करता कि हर स्वचालित क्लाइंट हर नियम को समान तरीके से व्याख्यायित करेगा।