
STATUS IS UPВИКИ ПО ОПТИМИЗАЦИИ САЙТОВ
32Укрепить
SEO и видимость в поиске / Укрепить

Руководство robots.txt: управлять краулингом без сокрытия ошибок

Используйте robots.txt, чтобы направлять доступ краулеров, а затем сочетайте его с подходящим методом индексирования или контролем доступа для решения задачи.

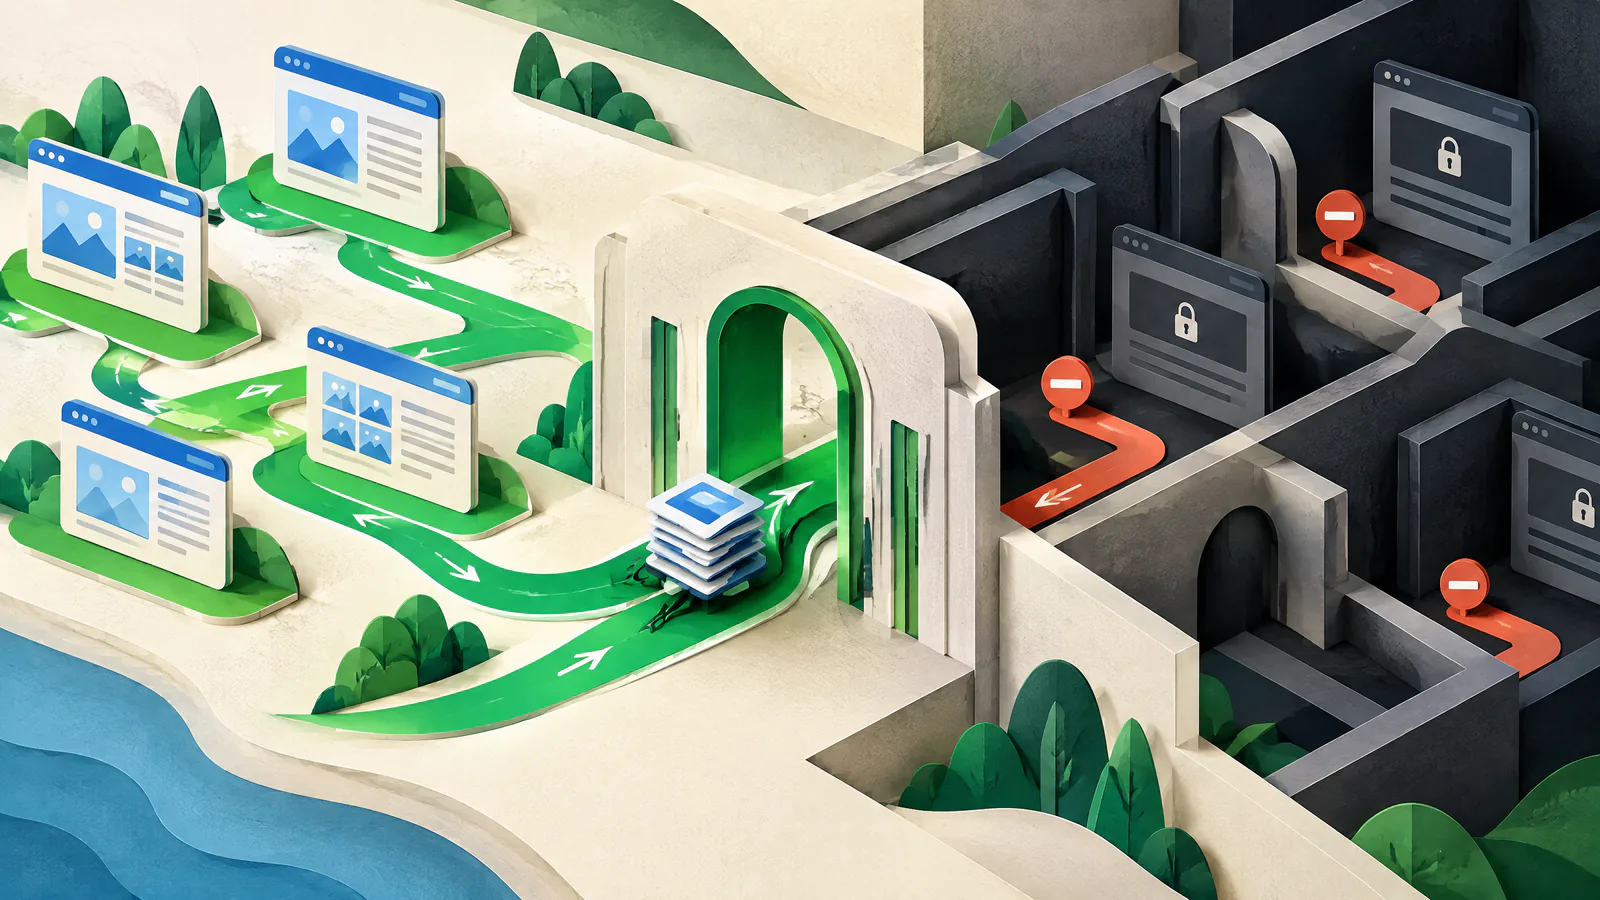
Руководство robots.txt: управлять краулингом без сокрытия ошибок — ВИЗУАЛЬНОЕ РУКОВОДСТВО
ЧИТАТЬ
8 мин
ИСТОЧНИКИ
6
ПОВТОРНО ПРОВЕРИТЬ
2027-03-27
проверено
Технический SEO и рецензент веб-платформы; добавьте обзор по безопасности для решений по контролю доступа или чувствительному контенту.
КРАТКИЙ ОТВЕТ

Начните с решения.

Используйте robots.txt, чтобы попросить добросовестных краулеров не заходить на определённые публичные шаблоны URL, которые создают лишнюю работу при обходе. Разместите файл в кодировке UTF-8 в корне точного происхождения сайта и начните с небольшого набора правил. Это сигнал для краулера о доступе, а не замок, и он никогда не скрывает ошибку.

Robots.txt ненадёжно скрывает страницу или не защищает её. Заблокированный URL по-прежнему может быть обнаружен через ссылки. Для публичного контента, который не должен индексироваться, используйте noindex, оставив страницу доступной для обхода, чтобы инструкция была видна. Для приватных материалов применяйте серверные или прикладные механизмы контроля доступа.

Относитесь к правкам как к конфигурации продакшена: определите origin, протестируйте именованные URL, получите живой /robots.txt и держите предыдущую версию под рукой. SIU поддерживает проактивную доступность и устранение проблем через предрейд и дисциплину отката, а не через уведомления об отключениях или отчёты о статусе.

ВИЗУАЛЬНОЕ РУКОВОДСТВО

Видеть работу как систему.

Используйте эту карту, чтобы связать решения из статьи, прежде чем применять отдельные тактики.

SIUУкрепить
01Выберите контроль, соответствующий результату
02Точно используйте базовый синтаксис и область действия
03Блокируйте только шаблоны, подтверждённые URL-доказательствами
04Согласовывайте обнаружение через sitemap, noindex и решения по приватности
01

Выберите контроль, соответствующий результату

Краулинг — это автоматическое получение URL. Индексация — это решение поисковой системы о сохранении и показе информации о нём. Контроль доступа определяет, кто может получить контент. Robots.txt касается краулинга, и добросовестные краулеры решают, следовать ли ему. Протокол исключения роботов IETF (Robots Exclusion Protocol) говорит, что это не авторизация.

Используйте правило Disallow для управления доступом краулеров к публичному пути с низкой ценностью, например к внутреннему маршруту поиска. Используйте noindex для публичного контента, который не должен появляться в поддерживаемых результатах поиска. Для превью, областей с входом, экспортов или чувствительных данных применяйте реальные механизмы контроля доступа на сервере или в приложении. Для клиентских, сотрудников, платёжных или регулируемых данных требуйте квалифицированного обзора по безопасности и платформе; robots.txt никогда не является компенсирующим контролем.

Управление краулингом

Robots.txt может попросить добросовестных краулеров избегать определённого публичного пути; это не гарантирует удаления из результатов.

Контроль индексации

Используйте noindex в HTML или заголовке ответа X-Robots-Tag и оставляйте ответ доступным для краулинга, чтобы директива была прочитана.

Приватный контент

Требуйте аутентификации или соответствующего серверного/прикладного контроля, затем удаляйте URL из публичных путей обнаружения.

02

Точно используйте базовый синтаксис и область действия

Публикуйте текстовый файл в кодировке UTF-8 по пути /robots.txt для каждого протокола, хоста и порта, где нужны правила. Файл по адресу https://www.example.com/robots.txt не распространяется автоматически на https://example.com, субдомен или HTTP-origin. Подтвердите origin, используемые канонические URL, переадресации, CDN и приложение, прежде чем считать правило применимым.

Группа начинается с User-agent и затем использует Allow или Disallow для путей. User-agent: * — общая группа. Сопоставление чувствительно к регистру и начинается с начала пути. Выигрывает самое специфичное совпадение; с одинаковой спецификой Allow должен иметь приоритет над Disallow. Disallow: ничего не блокирует, тогда как Disallow: / блокирует весь origin. Стандарт определяет # для комментариев, * для подстановки и $ для конца шаблона.

Минимальный базис

Если нет документированной потребности в управлении обходом, не добавляйте исключений; не создавайте предположительных блоков.

Безопасный шаблон

Предпочитайте стабильный узкий префикс, например /search/, вместо расплывчатой подстановки или непонятного правила по имени файла.

Комментарии

Фиксируйте цель правила, владельца и ссылку на изменение, но не заменяйте ими процедуру ревью.

03

Блокируйте только шаблоны, подтверждённые URL-доказательствами

Прежде чем писать правило, инвентаризируйте важные страницы, нежелательные пути обхода, варианты с параметрами, внутренний поиск, маршруты превью, ресурсы и URL карты сайта. Для каждого примера URL зафиксируйте ожидаемый результат и соответствующее правило. Сверьте список с каноническими URL и живой навигацией, чтобы блок не скрывал полезный маршрут.

Оставляйте ресурсы, критичные для браузера, доступными, если не доказано обратное. Google предупреждает, что блокировка CSS, JavaScript, изображений или других ресурсов может затруднить анализ страницы. Robots.txt не решает проблему выбора дублированного контента, авторизации или качества страницы; используйте канонизацию, редиректы, контроль доступа или работу с содержимым там, где это уместно.

Сначала доказательства

Используйте реальные примеры URL и данные сервера или краулинга, а не общий список, скопированный с другого сайта.

Таблица изменений

Храните для каждого тестового URL ожидаемый результат, правило, которое совпадает, и ответственного владельца в релизной записи.

04

Согласовывайте обнаружение через sitemap, noindex и решения по приватности

Карта сайта (sitemap) сообщает поисковым системам, какие URL и файлы вы считаете важными; она помогает обнаружению, но не гарантирует краулинг или индексацию. Сильные внутренние ссылки по‑прежнему важны. Вы можете добавить полностью квалифицированный URL Sitemap в robots.txt, но не включайте приватные, перенаправляемые, заблокированные robots или целиком отмеченные как noindex URL. Сверяйте вывод карты сайта с правилами robots во время релиза.

Noindex не является директивой роботов в robots.txt. Google поддерживает её в мета-теге HTML или в HTTP-заголовке X-Robots-Tag, и поисковик должен просканировать ответ, чтобы увидеть её. Если публичная страница должна покинуть результаты Google, уберите любой robots-блок, который скрывает noindex. Если контент непубличный, не рекламируйте его путь в robots.txt; применяйте контроль доступа. Границы чувствительных данных требуют квалифицированного обзора.

Объявление sitemap

Используйте полный URL, например Sitemap: https://www.example.com/sitemap.xml; это не отменяет блокировку обхода.

HTML и файлы

Используйте meta noindex для HTML или заголовок ответа X-Robots-Tag: noindex там, где это уместно, затем тестируйте живой ответ.

Срочное появление в публичном доступе

Сначала ограничьте доступ, если контент чувствителен, затем при необходимости используйте процесс удаления в поисковой системе.

05

Тестируйте и выпускайте как критический конфигурационный файл

Подтвердите утверждённый текст локально, затем протестируйте примеры разрешённых и запрещённых URL для целевой группы краулеров. После деплоя получите публичный /robots.txt приватно или через прямой HTTP-запрос, чтобы подтвердить содержимое, origin и статус ответа. Google предоставляет отчёт robots.txt в Search Console и открытое парсер-библиотеку для локального тестирования.

Краулеры могут кешировать файлы robots, поэтому не ждите мгновенных изменений в обнаружении или индексации. Серверные или сетевые ошибки заставляют краулеров предполагать полную блокировку, тогда как ответ 4xx может разрешать доступ. Храните файл в системе контроля версий, требуйте дополнительного ревью для блокировок на весь сайт или изменений с подстановками, и сохраняйте предыдущую версию. Предрейды (preflights) SIU и планирование отката помогают поймать плохой релиз до того, как он превратится в большую проблему доступности или обнаружимости.

Ворота релиза

Требуйте второго ревью при миграциях origin, блокировках всего сайта, wildcard-правилах и изменениях, затрагивающих вход, оформление заказа или маршруты поддержки.

Сигнал отката

Восстановите предыдущую версию, когда важный тестовый URL неожиданно заблокирован, необходимый ресурс недоступен или endpoint недоступен.

Ограничение

Один тест краулера не доказывает, что каждый автоматический клиент интерпретирует правило одинаково.

ДЕЙСТВИЕ / ПРОВЕРКА

Практический чек‑лист

  1. 01

    Классифицируйте цель

    Выберите управление краулингом, исключение из индекса или приватный доступ перед выбором контроля.

    ПРОВЕРИТЬ: Каждый затронутый URL имеет задокументированную цель и ответственного владельца.
  2. 02

    Смоделируйте origin

    Определите точный протокол, хост, порт, субдомен, CDN и origin приложения.

    ПРОВЕРИТЬ: Ни один origin не предполагается наследовать правила robots другого origin.
  3. 03

    Перечислите представительные URL

    Включите важные страницы, цели, варианты, ресурсы, записи карты сайта и приватные маршруты.

    ПРОВЕРИТЬ: Таблица называет ожидаемый результат для каждого тестового URL.
  4. 04

    Пишите узкие правила

    Используйте понятные User-agent, Allow и Disallow пути; избегайте широких wildcard'ов без необходимости.

    ПРОВЕРИТЬ: Ревьюер может объяснить область действия и исключения каждого правила.
  5. 05

    Правильно реализуйте noindex

    Используйте мета-тег или заголовок ответа для публичного контента, исключаемого из Google.

    ПРОВЕРИТЬ: Живая цель доступна для краулинга и показывает noindex краулеру.
  6. 06

    Защитите непубличный материал

    Используйте аутентификацию или серверные и прикладные механизмы, а не robots.txt.

    ПРОВЕРИТЬ: Неавторизованный запрос не может получить чувствительный контент.
  7. 07

    Опубликуйте утверждённый файл

    Задеплойте обычный текст в кодировке UTF-8 в корень origin.

    ПРОВЕРИТЬ: Живой URL /robots.txt возвращает проверенный файл.
  8. 08

    Протестируйте поведение в реальном времени

    Проверьте образцы разрешённых и заблокированных URL с соответствующими инструментами.

    ПРОВЕРИТЬ: Результаты совпадают с релизной таблицей, включая исключения.
  9. 09

    Сверьте входы обнаружения

    Согласовывайте карту сайта и цели внутренних ссылок с решениями по краулингу и индексации.

    ПРОВЕРИТЬ: В карте сайта нет преднамеренно приватных, перенаправляемых, отмеченных noindex или заблокированных URL без обоснования.
  10. 10

    Держите откат готовым

    Храните предыдущий файл и добавьте изменение правила в процедуры запуска и восстановления.

    ПРОВЕРИТЬ: Известная хорошая версия и владелец отката доступны немедленно.
ВОПРОСЫ ДЛЯ ОБСУЖДЕНИЯ

Сравнивайте компромиссы, а не приватные данные.

Используйте эти вопросы с вашей командой или сообществом владельцев сайтов. Делитесь методами и уроками, но никогда не вставляйте учётные данные, данные клиентов или непубличные детали инфраструктуры.

  1. 01

    Какие публичные шаблоны URL создают нагрузку краулерам на вашем сайте и какие доказательства помогли отличить реальную проблему от безобидного варианта?

  2. 02

    Как ваша команда рассматривает изменение robots.txt вместе с картой сайта, канонизацией и решениями по контролю доступа перед релизом?

  3. 03

    Какой сигнал отката сказал бы вашей команде, что новое правило краулера вредит важному пользовательскому или бизнес-маршруту?

ПОПУЛЯРНЫЕ / АВТОРИТЕТНЫЕ РЕСУРСЫ

Откройте исходные материалы.

Google Search CentralIntroduction to robots.txt ↗

Объясняет назначение Google, ограничения видимости в результатах поиска и ограничения по безопасности для robots.txt.

Проверено 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

Референс стандарта по синтаксису, сопоставлению, области действия, ошибкам, кешированию и ограничениям безопасности.

Проверено 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

Показывает использование meta noindex и HTTP‑заголовка и объясняет, почему ответ должен оставаться доступным для краулинга.

Проверено 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

Освещает размещение, поддерживаемый синтаксис, объявления sitemap и варианты тестирования.

Проверено 2026-09-27
Google Search CentralLearn about sitemaps ↗

Разъясняет преимущества и ограничения обнаружения через sitemap и важность внутренних ссылок.

Проверено 2026-09-27
MDN Web DocsHTTP authentication ↗

Обзор HTTP-контроля доступа и соображения HTTPS для аутентификации.

Проверено 2026-09-27

Политика источников. Эта статья использует связанные первичные стандарты и официальную документацию. Перед релизом сверяйте продуктово-специфичную конфигурацию с текущей документацией платформы.

КРАТКИЕ УТОЧНЕНИЯ

Частые вопросы.

Может ли robots.txt удержать страницу от попадания в Google Search?

Нет. Заблокированный robots.txt URL всё ещё может быть обнаружен и появиться в результатах. Для публичного контента, который не должен индексироваться, используйте доступный для краулинга noindex, а для приватного контента — контроль доступа.

Какой файл robots.txt наиболее безопасно использовать в качестве старта?

Начните без исключений, если вы не можете документировать потребность в управлении краулингом. Добавляйте только узкие пути, которые вы протестировали относительно важных страниц и ресурсов.

Стоит ли указывать sitemap в robots.txt?

Можно. Полностью квалифицированная строка Sitemap помогает обнаружению краулерами, но не заставляет их обходить или индексировать контент и не отменяет блокировку robots.

Status Is UP Editorial Team · Редакторы поддержки доступности (Uptime Enablement Editors)

Проверено Технический SEO и рецензент веб-платформы; добавьте обзор по безопасности для решений по контролю доступа или чувствительному контенту.. Опубликовано 2026-09-27; обновлено 2026-09-30.