
STATUS IS UP웹사이트 최적화 위키
32강화
SEO 및 검색 가시성 / 강화

Robots.txt 가이드: 오류를 숨기지 않고 크롤링 제어하기

robots.txt로 크롤러 접근을 안내하고, 목적에 맞는 색인화 또는 접근 통제 방식과 결합하세요.

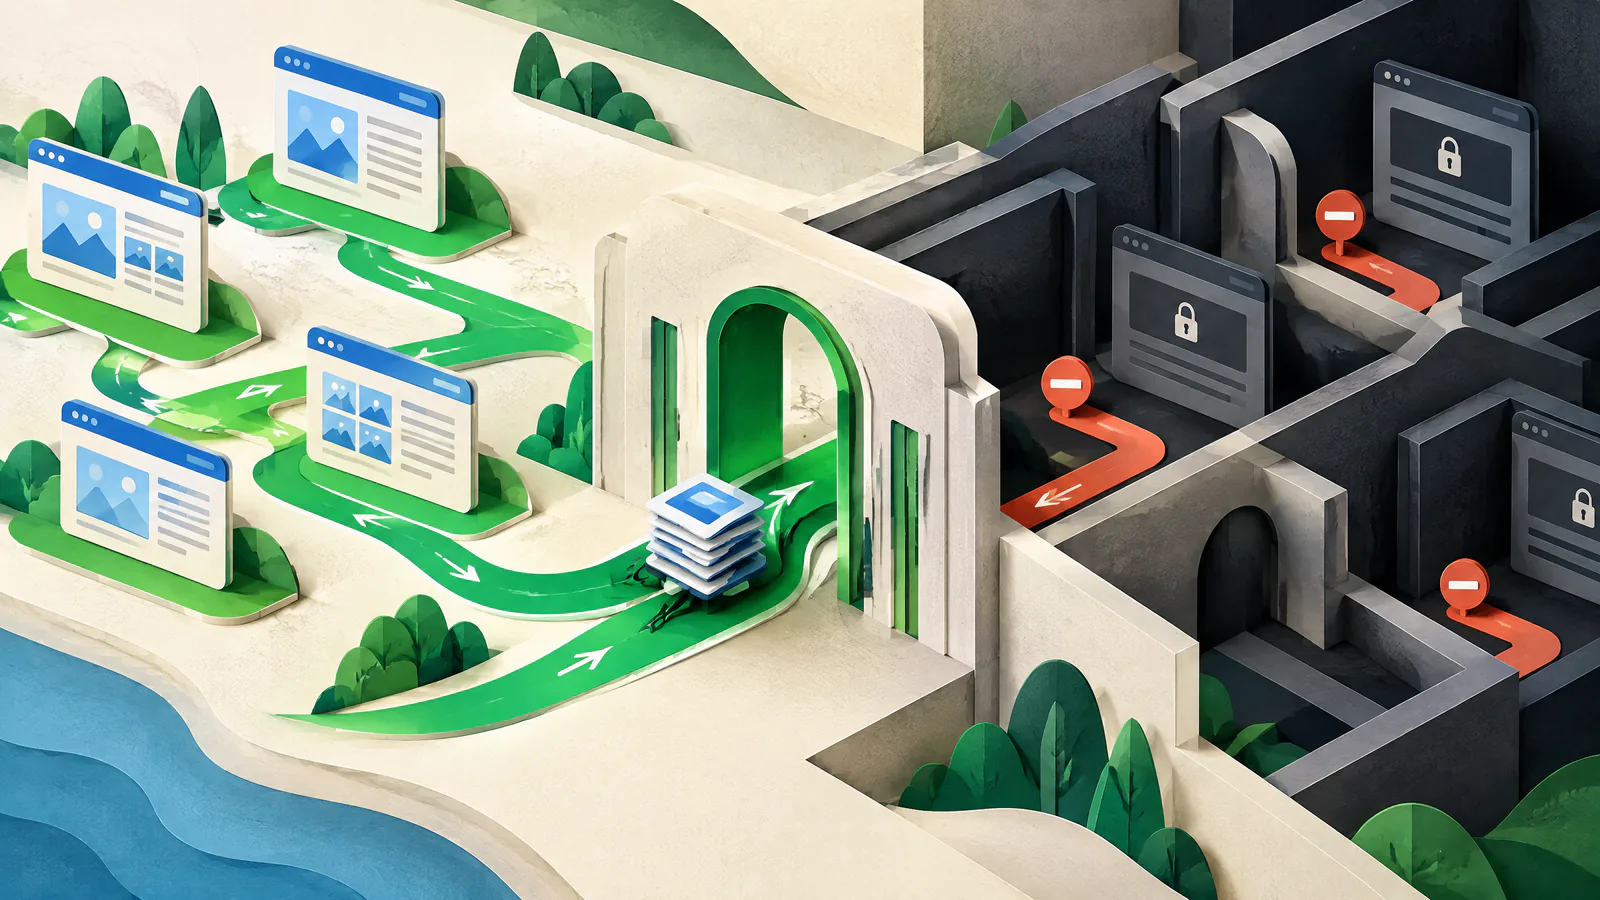
Robots.txt 가이드: 오류를 숨기지 않고 크롤링 제어하기 — 시각 가이드
읽기
8 분
출처
6
재검증
2027-03-27
검토됨
기술 SEO 및 웹 플랫폼 검토자; 접근 제어나 민감 콘텐츠 결정에는 보안 검토를 추가하세요.
간단 답변

결정부터 시작하세요.

robots.txt는 불필요한 크롤링 작업을 유발하는 특정 공개 URL 패턴에서 준수하는 크롤러를 멀리 유도하는 데 사용하세요. 정확한 사이트 오리진의 루트에 UTF-8 일반 텍스트 파일을 게시하고 규칙은 최소한으로 시작하세요. 이것은 크롤러 접근 신호일 뿐 잠금 장치가 아니며, 결코 실수를 숨기지 않습니다.

Robots.txt는 페이지를 신뢰성 있게 숨기거나 보호하지 않습니다. 차단된 URL은 여전히 링크를 통해 발견될 수 있습니다. 공개 콘텐츠를 색인에서 제외하려면 크롤러가 응답을 가져올 수 있도록 허용한 상태에서 noindex를 사용하세요. 비공개 자료는 서버 또는 애플리케이션 수준의 접근 제어로 강제하세요.

편집은 프로덕션 구성으로 취급하세요: 오리진을 식별하고, 명명된 URL을 테스트하며, 라이브 /robots.txt를 가져와 확인하고 이전 버전을 준비해 두세요. SIU는 중단 알람이나 상태 보고가 아니라 사전검증(preflight)과 롤백 규율을 통해 가용성 및 복구를 지원합니다.

시각 가이드

작업을 시스템 관점에서 보세요.

개별 전술을 실행하기 전에 이 지도로 문서의 의사결정 간 관계를 파악하세요.

SIU강화
01목표에 맞는 제어 수단을 선택하세요
02핵심 문법과 적용 범위를 정확하게 사용하세요
03URL 증거로 뒷받침되는 패턴만 차단하세요
04사이트맵 발견, noindex, 개인정보 결정은 일관되게 유지하세요
01

목표에 맞는 제어 수단을 선택하세요

크롤링은 URL을 자동으로 가져오는 행위입니다. 색인화는 검색 엔진이 해당 URL에 대한 정보를 저장하고 표시할지 결정하는 과정입니다. 접근 제어는 누가 콘텐츠를 얻을 수 있는지를 결정합니다. Robots.txt는 크롤링과 관련되며, 준수하는 크롤러는 이를 따를지 여부를 선택합니다. IETF Robots Exclusion Protocol은 이것이 권한 부여(authorization)가 아님을 명시합니다.

공개된 낮은 가치 경로(예: 내부 검색 제어 경로)에 대해 크롤러 접근을 관리하려면 Disallow 규칙을 사용하세요. 공개 콘텐츠 중 검색결과에 나타나지 않아야 하는 경우에는 noindex를 사용하세요. 미리보기, 계정 영역, 내보내기, 민감 데이터 등은 실제 접근 제어를 적용하세요. 고객·직원·결제·규제 대상 정보는 자격 있는 보안 및 플랫폼 검토를 받아야 하며, robots.txt는 절대 보완 제어가 아닙니다.

크롤링 관리

Robots.txt는 준수하는 크롤러가 정의된 공개 경로를 피하도록 요청할 수 있으나 결과에서의 제거를 보장하지는 않습니다.

색인 제어

HTML의 meta noindex나 X-Robots-Tag 응답 헤더를 사용하고, 해당 지시를 읽을 수 있도록 응답은 크롤러가 가져갈 수 있게 두세요.

비공개 콘텐츠

미리보기나 계정, 민감 데이터는 인증 또는 적절한 애플리케이션/서버 제어를 요구하고, 공개 검색 경로에서 URL을 제거하세요.

02

핵심 문법과 적용 범위를 정확하게 사용하세요

각 스킴, 호스트, 포트별로 오리진 루트에 UTF-8 일반 텍스트 robots.txt를 게시하세요. https://www.example.com/robots.txt 파일이 자동으로 https://example.com, 서브도메인, 또는 HTTP 오리진을 지배하지 않습니다. 규칙이 적용된다고 가정하기 전에 표준화된 URL(정규화 대상), 리디렉션, CDN, 애플리케이션이 제공하는 오리진을 확인하세요.

그룹은 User-agent로 시작하고 Allow 또는 Disallow 경로를 사용합니다. User-agent: *는 일반 그룹입니다. 매칭은 대소문자를 구분하며 경로의 시작에서 비교합니다. 가장 구체적인 매칭 규칙이 우선합니다; 동일하게 구체적인 Allow는 Disallow보다 우선해야 합니다. Disallow: 는 아무 것도 차단하지 않으며, Disallow: / 는 전체 오리진을 차단합니다. 표준은 주석용 #, 와일드카드 *, 패턴 끝 표시 $ 를 정의합니다.

최소한의 기준

문서화된 크롤 관리 필요성이 없다면 제외 규칙을 추가하지 마세요; 추측성 차단을 만들지 마십시오.

안전한 패턴

넓은 와일드카드나 설명 없는 파일명 규칙보다 /search/ 같은 안정적이고 좁은 접두사를 선호하세요.

주석

규칙의 목적, 소유자, 변경 참고를 기록하되 주석을 검토 대신으로 사용하지 마세요.

03

URL 증거로 뒷받침되는 패턴만 차단하세요

규칙을 작성하기 전에 주요 페이지, 원하지 않는 크롤 경로, 쿼리 변형, 사이트 내 검색, 미리보기 경로, 자산, 사이트맵 URL을 인벤토리화하세요. 샘플 URL마다 예상 결과와 일치하는 규칙을 기록하세요. 목록을 정규화된 URL 및 라이브 네비게이션과 비교해 차단이 유용한 경로를 숨기지 않도록 하세요.

브라우저에 중요한 리소스는 테스트가 끝나기 전까지 접근 가능하게 두세요. Google은 CSS, JavaScript, 이미지 등 리소스를 차단하면 페이지 분석이 어려워질 수 있음을 경고합니다. Robots.txt는 중복 콘텐츠 선정, 권한 부여, 페이지 품질 문제를 해결하지 않습니다; 적절할 경우 정규화(canonicalization), 리디렉션, 접근 제어, 또는 콘텐츠 개선을 사용하세요.

증거 우선

다른 사이트에서 복사한 일반 목록이 아니라 실제 URL 샘플과 서버 또는 크롤 증거를 사용하세요.

변경 테이블

각 샘플 URL, 의도된 결과, 일치한 규칙, 책임 소유자를 릴리스 기록에 유지하세요.

04

사이트맵 발견, noindex, 개인정보 결정은 일관되게 유지하세요

사이트맵은 검색 엔진에 중요한 URL 및 파일을 알리는 수단으로 발견을 도울 수 있으나 크롤링이나 색인을 보장하지는 않습니다. 강력한 내부 링크가 여전히 중요합니다. robots.txt에 전적으로 지정된 Sitemap URL을 추가할 수 있지만 비공개, 리디렉션된, robots로 차단된, 또는 의도적으로 noindex로 표시된 URL을 목록으로 포함하지 마세요. 배포 시 사이트맵 출력과 robots 규칙을 조정하세요.

noindex는 Google의 robots.txt 지시가 아닙니다. Google은 HTML meta 태그 또는 X-Robots-Tag HTTP 응답 헤더에서 이를 지원하며, 이 지시를 확인하려면 응답을 크롤해야 합니다. 공개 페이지를 Google 결과에서 제거하려면 noindex를 가리키는 것을 숨기는 robots 차단을 제거하세요. 비공개 콘텐츠는 robots.txt에 경로를 노출하지 말고 접근 제어를 적용하세요. 민감 데이터 경계는 자격 있는 검토가 필요합니다.

사이트맵 선언

예: Sitemap: https://www.example.com/sitemap.xml 같이 전체 URL을 사용하세요; 이것은 크롤 차단을 무효화하지 않습니다.

HTML 및 파일

HTML에는 meta noindex를, 파일 또는 비HTML 응답에는 X-Robots-Tag: noindex 응답 헤더를 사용하고 라이브 응답을 테스트하세요.

긴급 노출

콘텐츠가 민감한 경우 먼저 접근을 제한하고, 필요하면 검색 엔진의 제거 프로세스를 사용하세요.

05

중요 구성 파일처럼 테스트하고 배포하세요

승인된 텍스트를 로컬에서 검증한 후 의도된 크롤러 그룹에 대해 허용 및 차단 예제를 테스트하세요. 배포 후에는 개인적으로 또는 직접 HTTP 요청으로 라이브 /robots.txt를 가져와 콘텐츠, 오리진, 응답 상태를 확인하세요. Google은 Search Console의 robots.txt 보고서와 로컬 테스트용 오픈 소스 파서 라이브러리를 제공합니다.

크롤러는 robots 파일을 캐시할 수 있으므로 즉각적인 발견 또는 색인 변경을 약속하지 마세요. 서버 또는 네트워크 오류 시 크롤러는 전체 차단으로 가정할 수 있고, 4xx 응답은 접근을 허용할 수도 있습니다. 파일은 소스 제어된 구성에 보관하고, 전체 사이트 또는 와일드카드 변경에는 추가 검토를 요구하며 이전 버전을 보관하세요. SIU의 사전검증과 롤백 계획은 잘못된 릴리스가 더 큰 가용성 또는 검색 문제로 커지기 전에 잡는 데 도움이 됩니다.

릴리스 게이트

오리진 마이그레이션, 전체 사이트 차단, 와일드카드, 로그인·체크아웃·지원 경로에 영향을 주는 변경에는 두 번째 검토자를 요구하세요.

롤백 신호

중요 샘플 URL이 새로 차단되었거나 필요한 자산이 접근 불가해졌거나 엔드포인트가 사용 불가일 때 이전 버전을 복원하세요.

한계

하나의 크롤러 테스트만으로 모든 자동화 클라이언트가 모든 규칙을 동일하게 해석한다고 증명할 수는 없습니다.

실행 / 검증

실무용 할 일 가이드.

  1. 01

    목표 분류

    규칙을 선택하기 전에 크롤 관리, 색인 제외, 또는 비공개 접근 중 목표를 선택하세요.

    검증: 영향을 받는 각 URL에 문서화된 목적과 책임 소유자가 있습니다.
  2. 02

    오리진 매핑

    관련된 정확한 프로토콜, 호스트, 포트, 서브도메인, CDN, 애플리케이션 오리진을 식별하세요.

    검증: 어떤 오리진도 다른 오리진의 robots 규칙을 자동으로 상속한다고 가정하지 않습니다.
  3. 03

    대표 URL 목록화

    중요 페이지, 대상, 변형, 자산, 사이트맵 항목, 비공개 경로를 포함하세요.

    검증: 테스트용 URL별로 예상 결과를 명시한 표가 있습니다.
  4. 04

    좁은 규칙 작성

    명확한 User-agent, Allow, Disallow 경로를 사용하고 필요하지 않으면 광범위한 와일드카드를 피하세요.

    검증: 검토자가 각 규칙의 범위와 예외를 설명할 수 있습니다.
  5. 05

    noindex 올바르게 구현

    공개 콘텐츠 제외에는 meta 태그나 응답 헤더를 사용하세요.

    검증: 라이브 대상이 크롤 가능하며 크롤러에 noindex를 노출합니다.
  6. 06

    비공개 자료 보호

    robots.txt 대신 인증이나 서버·애플리케이션 제어를 사용하세요.

    검증: 인증되지 않은 요청으로 민감 콘텐츠를 얻을 수 없습니다.
  7. 07

    승인된 파일 게시

    오리진 루트에 UTF-8 일반 텍스트로 배포하세요.

    검증: 라이브 /robots.txt URL이 검토된 파일을 반환합니다.
  8. 08

    라이브 동작 테스트

    적절한 도구로 허용 및 차단 샘플을 확인하세요.

    검증: 결과가 릴리스 테이블과 일치하며 예외를 포함합니다.
  9. 09

    발견 입력 조정

    사이트맵 및 내부 링크 대상이 크롤/색인 결정과 일관되도록 유지하세요.

    검증: 의도적으로 비공개, 리디렉션, noindex 또는 차단된 URL이 합리적 이유 없이 사이트맵에 포함되어 있지 않습니다.
  10. 10

    롤백 준비 유지

    이전 파일을 저장하고 규칙 변경을 배포 및 복구 절차에 추가하세요.

    검증: 알려진 정상 버전과 롤백 담당자가 즉시 식별 가능합니다.
토론 주제

트레이드오프를 비교하세요 — 개인정보는 공유하지 마세요.

이 프롬프트를 팀이나 웹사이트 소유자 커뮤니티와 함께 사용하세요. 방법과 교훈은 공유하되, 인증 정보·고객 기록·비공개 인프라 세부사항은 절대 붙여넣지 마세요.

  1. 01

    귀하의 사이트에서 어떤 공개 URL 패턴이 크롤러 작업을 생성하며, 실제 문제와 무해한 변형을 구분하는 데 어떤 증거가 도움이 되었나요?

  2. 02

    팀은 출시 전에 robots.txt 변경을 사이트맵, 정규화(canonical), 접근 제어 결정과 어떻게 함께 검토하나요?

  3. 03

    새로운 크롤러 규칙이 중요한 사용자 또는 비즈니스 경로에 해를 끼치고 있음을 알려줄 롤백 신호는 무엇인가요?

주요 / 신뢰할 수 있는 자료

출처 자료 열기

Google Search CentralIntroduction to robots.txt ↗

Google의 의도된 사용법, 검색결과 한계, robots.txt의 보안 한계를 설명합니다.

검토일: 2026-09-27
IETF / RFC EditorRFC 9309: Robots Exclusion Protocol ↗

문법, 매칭, 적용 범위, 오류, 캐싱, 보안 한계에 대한 표준 규격의 참조 문서입니다.

검토일: 2026-09-27
Google Search CentralBlock Search indexing with noindex ↗

noindex 메타 태그와 HTTP 헤더 사용법 및 응답이 크롤 가능해야 하는 이유를 보여줍니다.

검토일: 2026-09-27
Google Crawling InfrastructureHow to write and submit a robots.txt file ↗

배치 위치, 지원되는 문법, 사이트맵 선언, 테스트 옵션을 다룹니다.

검토일: 2026-09-27
Google Search CentralLearn about sitemaps ↗

사이트맵 발견의 이점과 한계, 내부 링크의 중요성을 명확히 합니다.

검토일: 2026-09-27
MDN Web DocsHTTP authentication ↗

인증을 위한 HTTP 접근 제어와 HTTPS 관련 고려사항을 개관합니다.

검토일: 2026-09-27

출처 정책 이 문서는 표준 및 공식 문서에 근거한 링크된 자료를 사용합니다. 제품별 구성은 배포 전에 현재 플랫폼 문서를 확인하세요.

빠른 설명

자주 묻는 질문

robots.txt가 Google 검색에서 페이지를 차단할 수 있나요?

아니요. 차단된 URL도 여전히 발견되어 검색결과에 나타날 수 있습니다. 공개 콘텐츠를 색인에서 제외하려면 크롤러가 접근할 수 있는 상태에서 noindex를 사용하고, 비공개 콘텐츠에는 접근 제어를 사용하세요.

가장 안전한 시작용 robots.txt 파일은 무엇인가요?

문서화된 크롤 관리 필요성이 없다면 제외 규칙 없이 시작하세요. 중요한 페이지와 자산에 대해 테스트한 좁은 경로만 추가하세요.

사이트맵을 robots.txt에 나열해야 하나요?

나열할 수는 있습니다. 전체 URL로 된 Sitemap 라인은 크롤러 발견을 돕지만 크롤링이나 색인을 강제하지 않으며 robots 차단을 무효화하지 않습니다.

Status Is UP Editorial Team · 가용성 활성화(Uptime Enablement) 편집자

검토자: 기술 SEO 및 웹 플랫폼 검토자; 접근 제어나 민감 콘텐츠 결정에는 보안 검토를 추가하세요.. 게시 2026-09-27; 업데이트 2026-09-30.